
kubernetes pod的弹性伸缩———基于pod自定义custom metrics(容器的IO带宽)的HPA
背景
自Kubernetes 1.11版本起,K8s资源采集指标由Resource Metrics API(Metrics Server 实现)和Custom metrics api(Prometheus实现)两种API实现,传统Heapster监控被废弃。前者主要负责采集Node、Pod的核心资源数据,如内存、CPU等;而后者则主要负责自定义指标数据采集,如网卡流量,磁盘IOPS、HTTP请求数、数据库连接数等。
heapster被废弃以后,所有的指标数据都从API接口中获取,kubernetes将资源指标分为了两种:
Core metrics(核心指标):由metrics-server提供API,即 metrics.k8s.io,仅提供Node和Pod的CPU和内存使用情况。
Custom Metrics(自定义指标):由Prometheus Adapter提供API,即 custom.metrics.k8s.io,由此可支持任意Prometheus采集到的自定义指标。
想让k8s一些核心组件,比如HPA,获取核心指标以外的其它自定义指标,则必须部署一套prometheus监控系统,让prometheus采集其它各种指标,
但是prometheus采集到的metrics并不能直接给k8s用,因为两者数据格式不兼容,还需要另外一个组件(kube-state-metrics),将prometheus的metrics 数据格式转换成k8s API接口能识别的格式,转换以后,因为是自定义API,所以还需要用Kubernetes aggregator在主API服务器中注册,以便直接通过/apis/来访问。
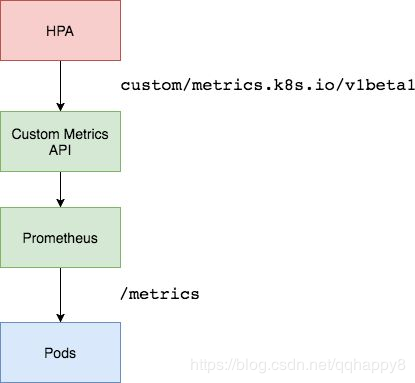
Horizontal Pod Autoscaler实现为一个控制循环,定期查询Resource Metrics API以获取CPU /内存等核心指标和针对特定应用程序指标的Custom Metrics API。
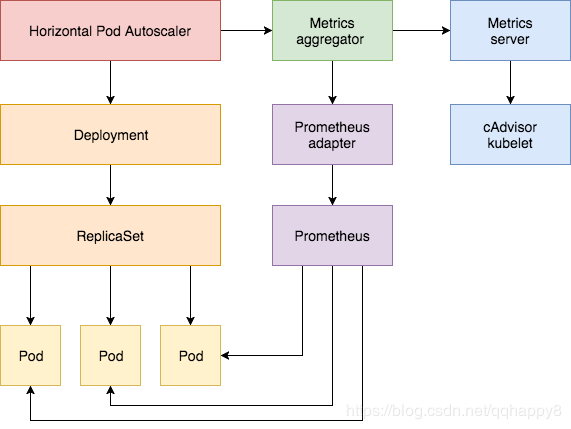
Custom Metrics组件介绍
- node-exporter:prometheus的agent端,收集Node级别的监控数据。
- prometheus:监控服务端,从node-exporter拉取数据并存储为时序数据。
- kube-state-metrics: 将prometheus中可以用PromQL查询到的指标数据转换成k8s对应的数据格式,即转换成Custerom Metrics API接口格式的数据,但是它不能聚合进apiserver中的功能。
- k8s-prometheus-adpater:聚合apiserver,即提供了一个apiserver(custom-metrics-api),自定义APIServer通常都要通过Kubernetes aggregator聚合到apiserver
部署步骤
1.部署好prometheus,node-exporter,kube-state-metrics,开启kube-apiserver的聚合功能,相关教程很多。
2.下载相关yaml文件 ,yaml文件clone于https://github.com/stefanprodan/k8s-prom-hpa,笔者内网环境,使用的为此git仓库的zip包。
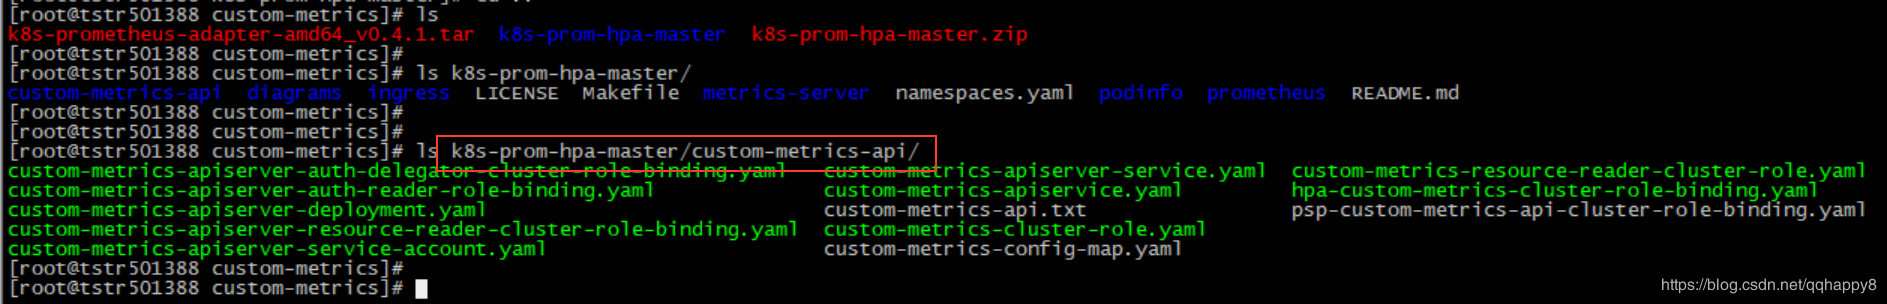
如上图,部署custom-metrics的yaml文件位于./custom-metrics-api目录,其中核心yaml文件为custom-metrics-apiserver-deployment.yaml和custom-metrics-apiservice.yaml,为部署prometheus-adapter的pod,并注册custom-metrics的apiservice。
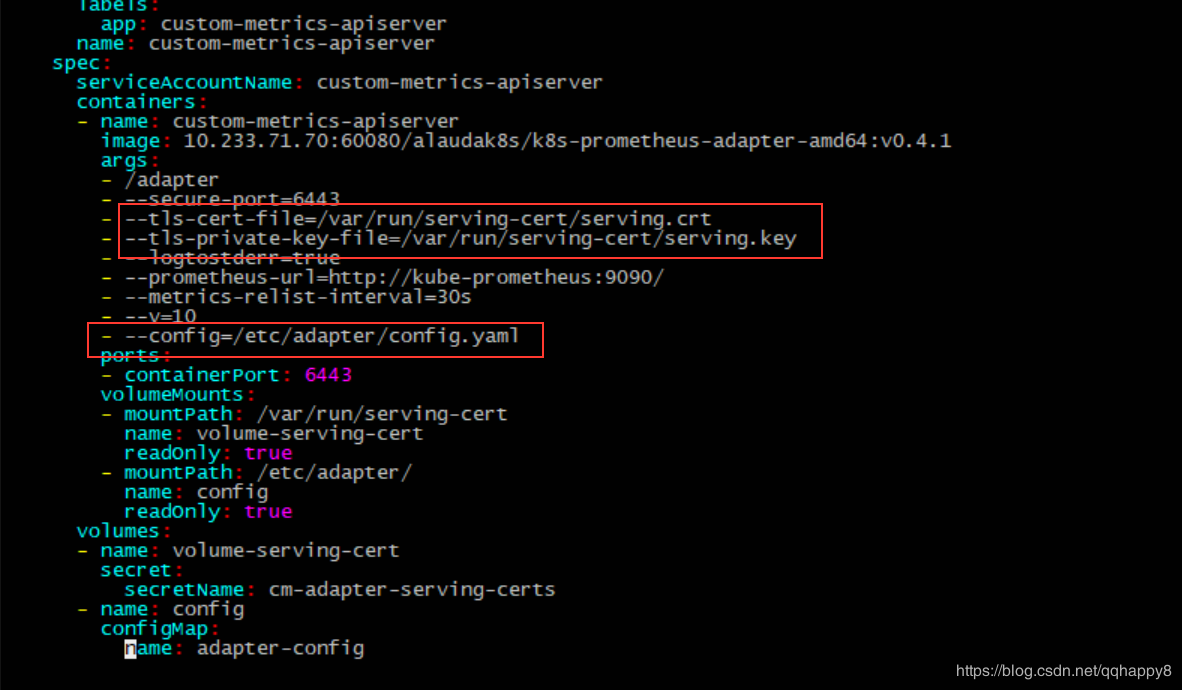
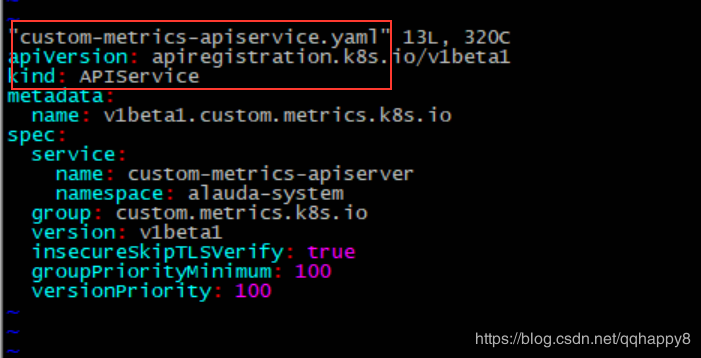
3.修改custom-metrics-api目录所有的yaml的namespace为alauda-system,因笔者prometheus部署在此namespace。
sed -i 's/namespace: monitoring/namespace: alauda-system/g' *.yaml
4.参照custom-metrics-apiserver-deployment.yaml里面的prometheus-adapter的启动配置,准备tls证书,笔者复用了master节点的证书。
kubectl create secret generic cm-adapter-serving-certs --from-file=serving.crt=/etc/kubernetes/pki/apiserver.crt --from-file=serving.key=/etc/kubernetes/pki/apiserver.key -n alauda-system

5.按照./custom-metrics-api目录下的资源清单,部署相关资源对象。
kubectl create -f /home/cloudops/custom-metrics/k8s-prom-hpa-master/custom-metrics-api
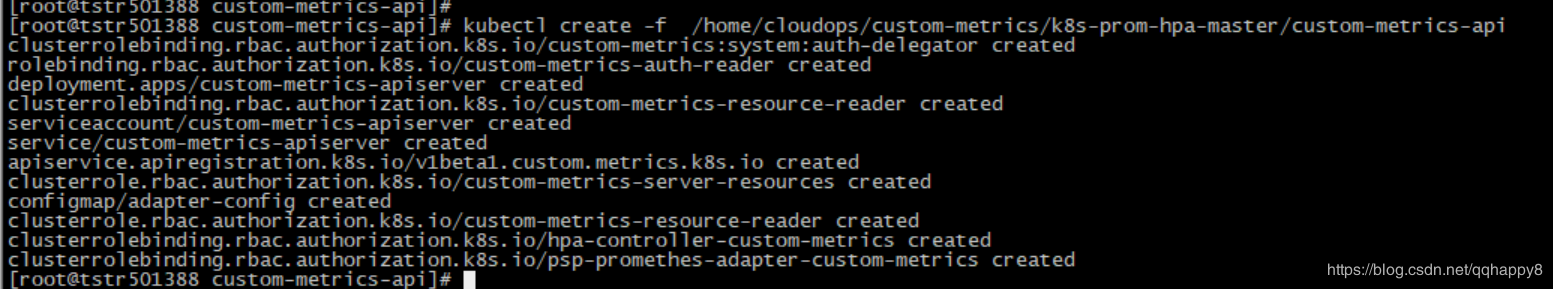
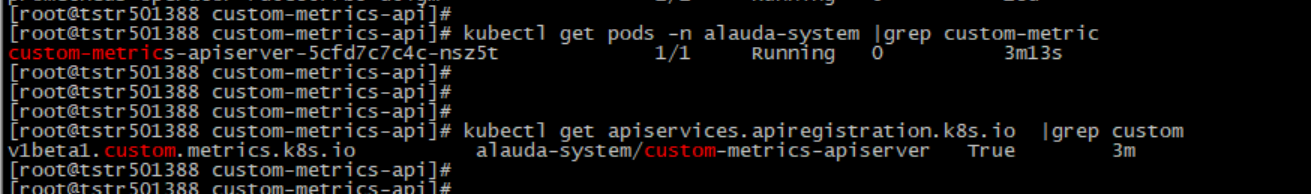
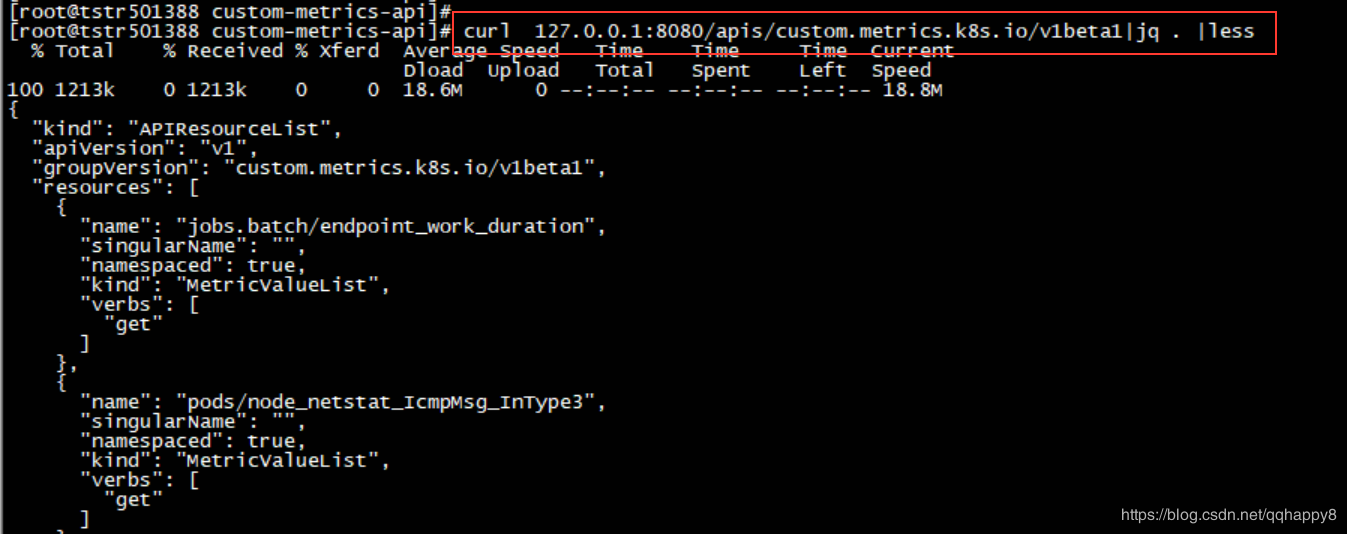
6.检查custom-metrics-apiserver的pod启动成功,custom-metrics-apiservice注册成功,curl此api路径正常返回。
curl 127.0.0.1:8080/apis/custom.metrics.k8s.io/v1beta1/ |jq .|less
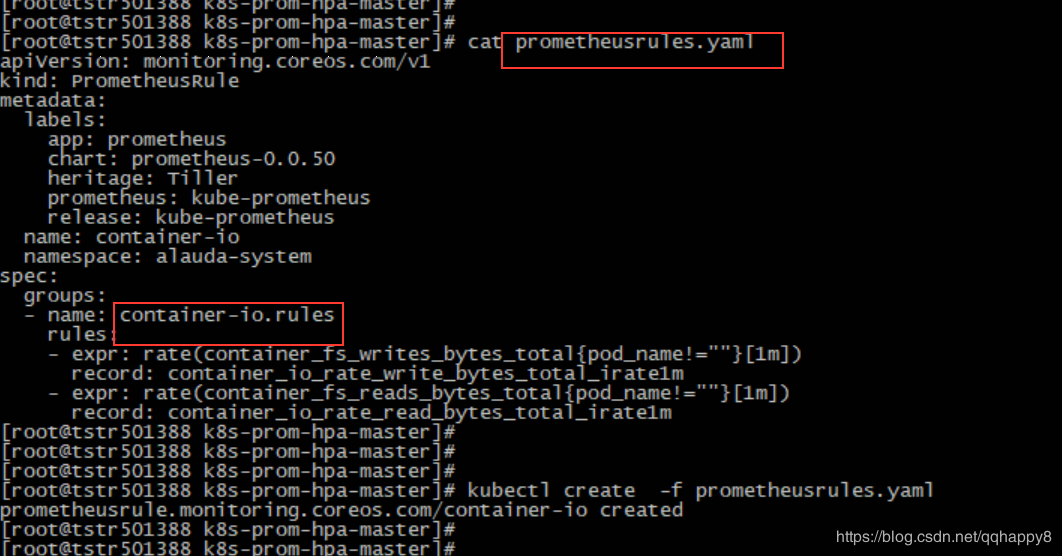
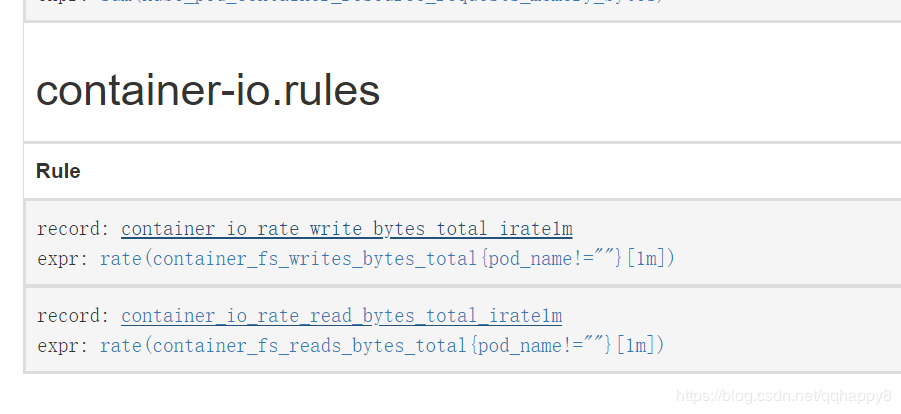
7.创建关于容器IO带宽的prometheusRule,确认rule的指标正常采集。
####cat prometheusrules.yaml

apiVersion: monitoring.coreos.com/v1

kind: PrometheusRule

metadata:

  labels:

    app: prometheus

    chart: prometheus-0.0.50

    heritage: Tiller

    prometheus: kube-prometheus

    release: kube-prometheus

  name: container-io

  namespace: alauda-system

spec:

  groups:

  - name: container-io.rules

    rules:

    - expr: rate(container_fs_writes_bytes_total{pod_name!=""}[1m])

      record: container_io_rate_write_bytes_total_irate1m

    - expr: rate(container_fs_reads_bytes_total{pod_name!=""}[1m])

      record: container_io_rate_read_bytes_total_irate1m
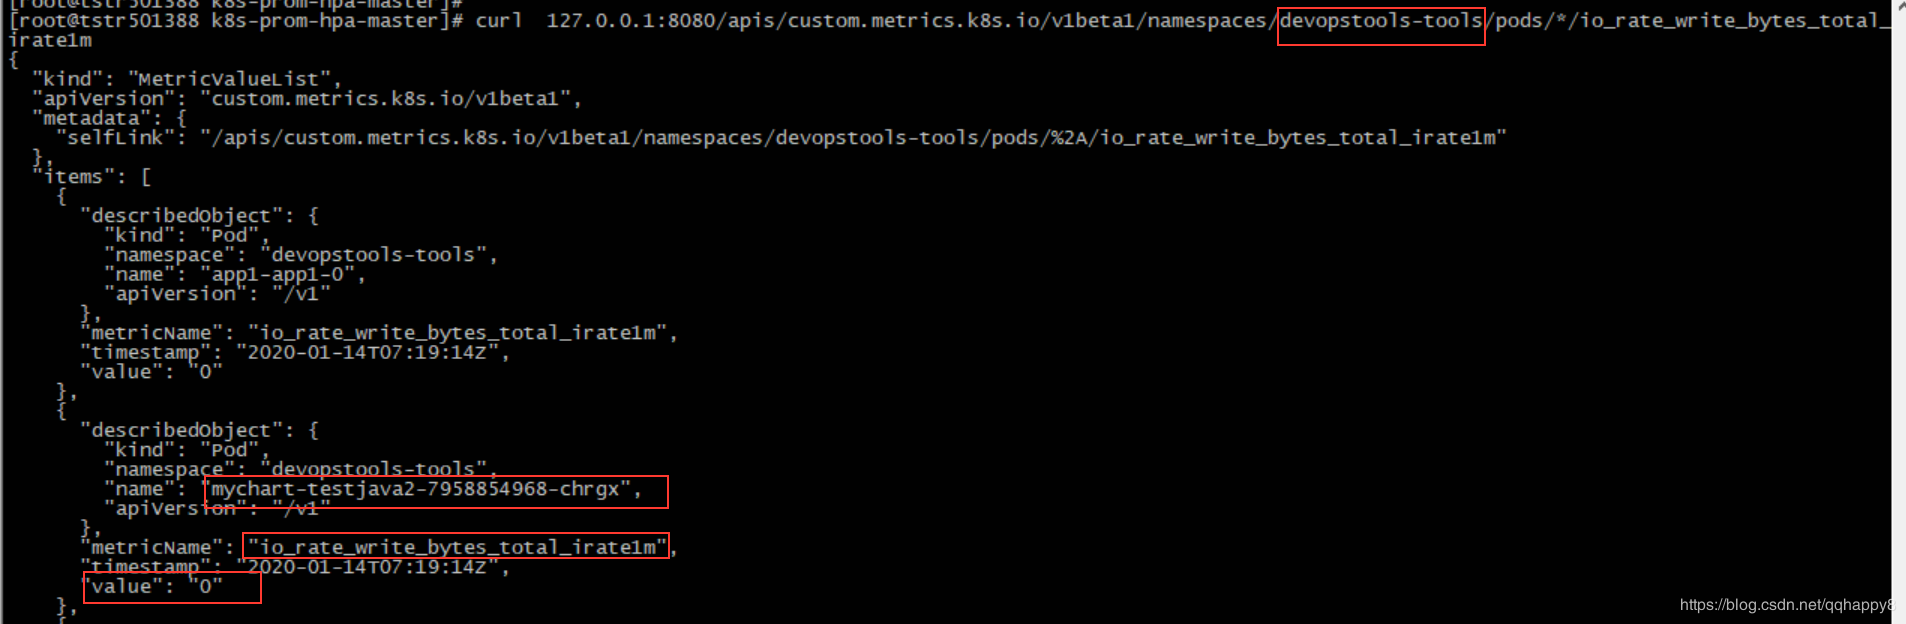
8.检查基于IO的custom-metrics通过kube-api能正常访问,注意替换namespace为本地环境。
curl 127.0.0.1:8080/apis/custom.metrics.k8s.io/v1beta1/namespaces/devopstools-tools/pods/*/io_rate_write_bytes_total_irate1m
9.创建一个基于IO带宽的HPA对象(基于pod的io写带宽,阈值为20M),笔者使用的为一个tomcat的pod。
####cat devopstools-tools-hpa-testjava.yaml

apiVersion: autoscaling/v2beta1

kind: HorizontalPodAutoscaler

metadata:

  name: testjava-io

  namespace: devopstools-tools

spec:

  maxReplicas: 3

  minReplicas: 1

  scaleTargetRef:

    apiVersion: extensions/v1beta1

    kind: Deployment

    name: mychart-testjava2

  metrics:

  - type: Pods

    pods:

      metricName: io_rate_write_bytes_total_irate1m

      targetAverageValue: 20000000000m
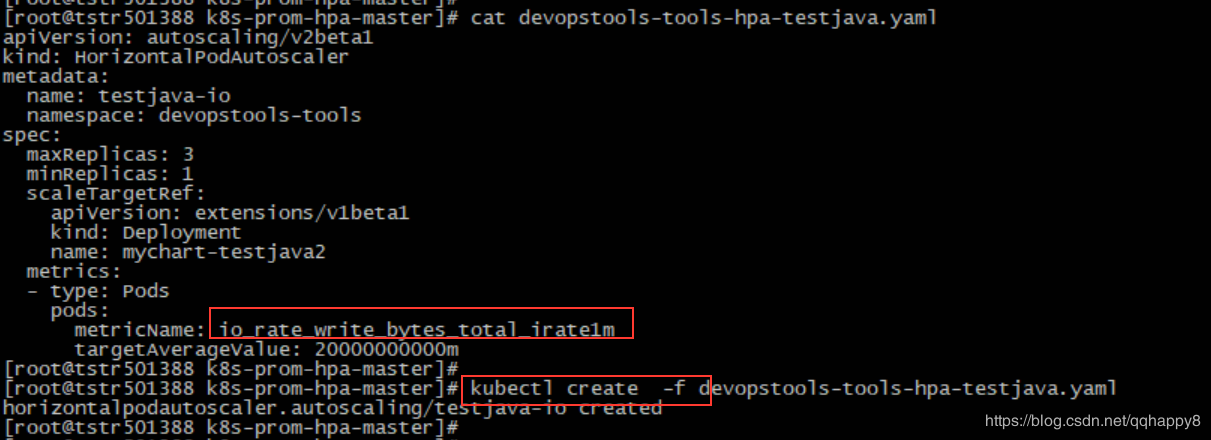
至此,基于IO写带宽的HPA创建完成
验证
1.在HPA的作用对象的容器pod里面,通过dd命令,加大此pod的IO带宽。

2.通过kubectl describe hpa检查HPA是否正常工作。
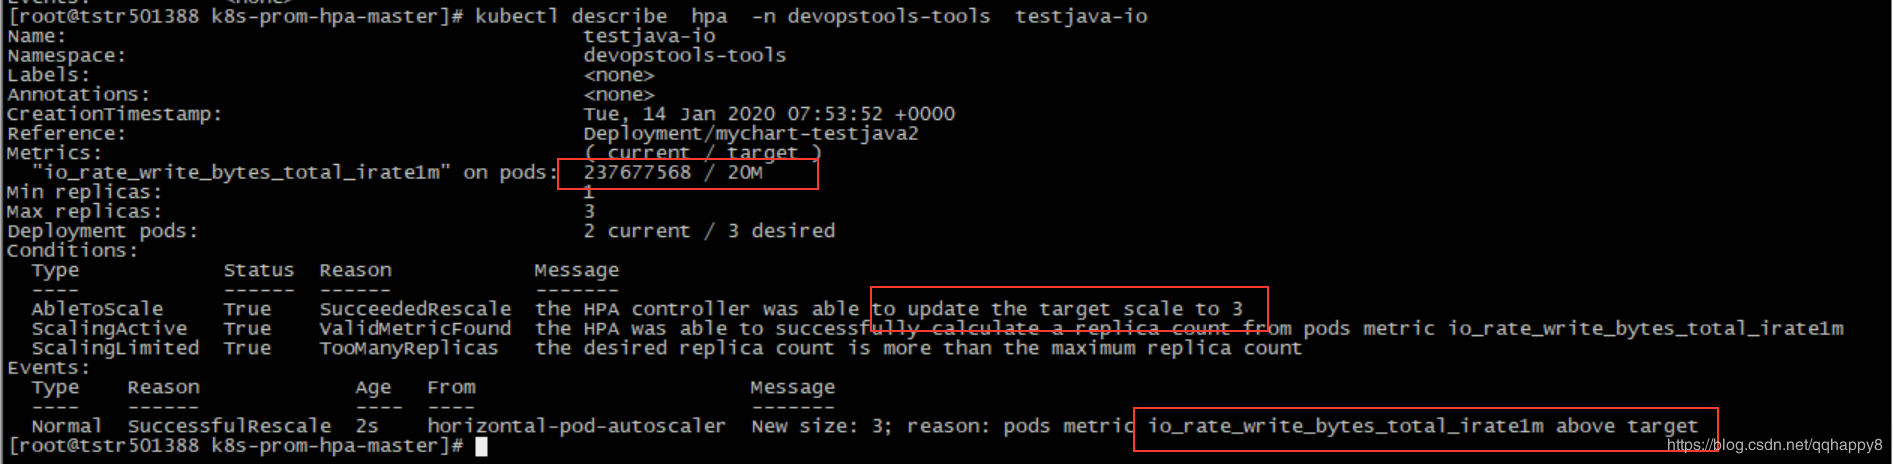
如上图,因为IO写带宽超过阈值(20M),deployment控制的pod副本数增加到3。
3.在prometheus端查询pod的IO带宽(下图显示io带宽40M以上),也表明HPA工作正常。

后记
1.基于IO带宽的HPA,和基于cpu和内存的HPA相比,生产实用性不一定很大,本文只是证明custom-metrics的可行性。
2.基于容器的IOPS的HPA暂未成功,原因为prometheus查询的容器iops(container_fs_io_current)始终为0,google到的原因为cadvisor的bug,待进一步调研。
参考 https://github.com/stefanprodan/k8s-prom-hpa
kubernetes pod的弹性伸缩———基于pod自定义custom metrics(容器的IO带宽)的HPA的更多相关文章
- Kubernetes 弹性伸缩全场景解析(三) - HPA 实践手册
在上一篇文章中,给大家介绍和剖析了 HPA 的实现原理以及演进的思路与历程.本文我们将会为大家讲解如何使用 HPA 以及一些需要注意的细节. autoscaling/v1 实践 v1 的模板可能是大家 ...
- Kubernetes 弹性伸缩全场景解读(二)- HPA 的原理与演进
前言 在上一篇文章 Kubernetes 弹性伸缩全场景解析 (一):概念延伸与组件布局中,我们介绍了在 Kubernetes 在处理弹性伸缩时的设计理念以及相关组件的布局,在今天这篇文章中,会为大家 ...
- 弹性伸缩布局-flex
弹性伸缩布局-flex 引言:本文主要参照阮一峰的网络日志 .郭锦荣的博客总结完成. 正文: 布局的传统解决方案,基于盒状模型,依赖 display 属性 + position属性 + float属性 ...
- CSS3弹性伸缩布局(二)——flex布局
上一篇博客<CSS3弹性伸缩布局(一)——box布局>介绍了旧版本的box布局,而这篇博客将主要介绍最新版本的flex布局的基础知识. 新版本简介 新版本的Flexbox模型是2012年9 ...
- Kubernetes 弹性伸缩HPA功能增强Advanced Horizontal Pod Autoscaler -介绍部署篇
背景 WHAT(做什么) Advanced Horizontal Pod Autoscaler(简称:AHPA)是kubernetes中HPA的功能增强. 在兼容原生HPA功能基础上,增加预测.执行模 ...
- Kubernetes Pod水平自动伸缩(HPA)
HPA简介 HAP,全称 Horizontal Pod Autoscaler, 可以基于 CPU 利用率自动扩缩 ReplicationController.Deployment 和 ReplicaS ...
- Kubernetes 弹性伸缩全场景解读(五) - 定时伸缩组件发布与开源
作者| 阿里云容器技术专家刘中巍(莫源) 导读:Kubernetes弹性伸缩系列文章为读者一一解析了各个弹性伸缩组件的相关原理和用法.本篇文章中,阿里云容器技术专家莫源将为你带来定时伸缩组件 kub ...
- Kubernetes使用metric-server让HPA弹性伸缩运行
监控架构概述 kubernetes监控指标大体可以分为两类:核心监控指标和自定义指标,核心监控指标是kubernetes内置稳定可靠监控指标,早期由heapster完成,现由metric-server ...
- Kubernetes 弹性伸缩全场景解析 (四)- 让核心组件充满弹性
前言 在本系列的前三篇中,我们介绍了弹性伸缩的整体布局以及HPA的一些原理,HPA的部分还遗留了一些内容需要进行详细解析.在准备这部分内容的期间,会穿插几篇弹性伸缩组件的最佳实践.今天我们要讲解的是 ...
随机推荐
- nginx 配置大吞吐量
ng做反向代理服务是如果没有这两行配置吞吐量到8000-10000就上不去. proxy_http_version 1.1; # 后端配置支持HTTP1.1,必须配 proxy_set_header ...
- java程序员从小工到专家成神之路(2020版)
目录 必须掌握的基础知识 1. Git & Github 2. Linux 3. 数据结构和算法 4. HTTP / HTTPS 5. 设计模式 6. 计算机原理 java学习之路 1. 工具 ...
- 飞机大战-面向对象-pygame
飞机大战 最近学习了python的面向对象,对面向对象的理解不是很深刻. 面向对象是数据和函数的'打包整理',将相关数据和处理数据的方法集中在一个地方,方便使用和管理. 本着学习的目的,在网上找了这个 ...
- Clickhouse 时区转换(下)
Clickhouse 时区转换续—时区参数转换 天天加班,时间不够,主要还是我太懒,流汗,,,,,,另外如果这篇学习笔记超过100阅读量并有评论,我可能半夜也会爬起来更新的. 相信大家看我之前记录的这 ...
- P4768 [NOI2018]归程(kruskal 重构树)
洛谷P4768 [NOI2018]归程 LOJ#2718.「NOI2018」归程 用到 kruskal 重构树,所以先说这是个啥 显然,这和 kruskal 算法有关系 (废话 这个重构树是一个有点权 ...
- LeetCode 25. K 个一组翻转链表 | Python
25. K 个一组翻转链表 题目来源:https://leetcode-cn.com/problems/reverse-nodes-in-k-group 题目 给你一个链表,每 k 个节点一组进行翻转 ...
- 安装KubeSphere
1. KubeSphere 是什么 1.1. 官方解释 KubeSphere是一个分布式操作系统,提供以Kubernetes为核心的云原生堆栈,旨在成为第三方应用程序的即插即用架构,以促进其生态系统的 ...
- 【Hexo】使用Hexo+github pages+travis ci 实现自动化部署
目录 一.说明 二.成品展示 三.前期准备 本地安装 node.js 本地安装 git github 账号 创建仓库 travis ci 账号 四.安装 Hexo 五.使用 hexo 搭建博客 六.部 ...
- spark系列-8、Spark Streaming
参考链接:http://spark.apache.org/docs/latest/streaming-programming-guide.html 一.Spark Streaming 介绍 Spark ...
- B. Phoenix and Beauty(贪心构造)
\(给定序列长n的数组和k.完美数组的定义是数组中每一个连续k项的子段和为定值\) \(现在要求插入一些数使得数组满足条件,输出你构造的新数列.\) \(\color{Red}{----------- ...