
论文阅读笔记(二十三)【ECCV2018】:Robust Anchor Embedding for Unsupervised Video Person Re-Identification in the Wild
Introduction
当前主要的非监督方法都采用相同的训练数据集,这些数据集在不同摄像头中是对称的,即不存在单个行人的错误项,这些方法将在实际场景中效果下降。在本方法中,作者引入了非对称数据,如下图所示,提出了一个在真实环境下的非监督深度神经网络。
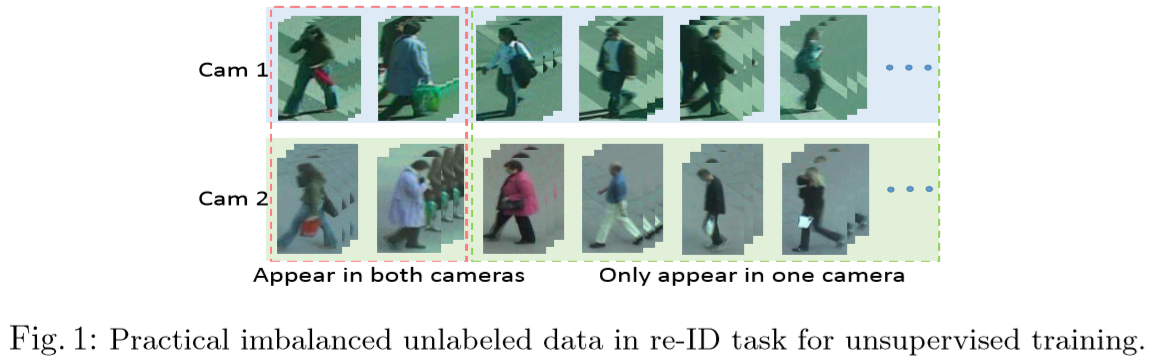
提出一个标签估计方法:a novel Robust Anchor Embeding (RACE) framework。
Proposed Method
(1)概述:

通俗来说,先固定几个序列,给这几个序列加上标签作为anchor,然后输入一个未标签序列,找出距离最近的若干个anchor,用这些anchor加权表示出这个未标签序列,这样既得到了相似距离又得到了权重,我们希望距离越近越好,权重越大越好,综上计算出最佳的anchor,作为预测的标签,循环这个过程得到所有的标签。
(2)Anchor初始化:
【注】anchor表示不同行人的身份,但在假设下并不严谨,两个anchor也可能属于同一个人。
随机抽选 m 个anchor序列  传入预训练的ImageNet模型,分别表示不同的行人,即:
 ,其中
 表示帧级特征向量的集合,l 表示对应的初始化标签。
在本文中,采用classification loss(Person re-identification: Past, present and future. 提出)来作为训练的基础结构。【待阅读】
(3)标签估计:
① 鲁棒的Anchor嵌入方法:
定义未标签的视频序列为: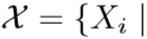
 。初始的帧级特征向量集合采用平均池化或者最大池化转化为单向量特征。考虑到一些帧存在跟踪偏差,即产生了离群帧(outlier frame),作者采用了regularized affine hull(RAH,From point to set: Extend the learning of distance metrics提出)【待阅读】,理解为对帧进行加权,得到 d 维的特征向量,即:
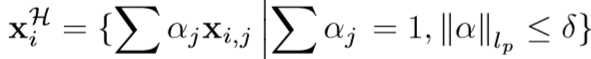
对于标签估计,首先学习embedding向量(姑且叫做嵌入向量)wi, 用于衡量未标签的特征序列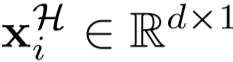 和anchor集合
 间的关系。学习到第 i 个未标签序列的最近的 k 个anchors,即
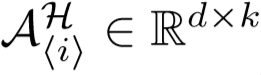 ,k 远远小于 m,用这 k 个anchors来联合表示该未标签序列,即定义如下系数学习问题(Robust AnChor Embeding问题,RACE):

该公式的第一项为embedding term,旨在限制未标签项与anchors之间的差异;
第二项为smoothing term,旨在权重越大的anchor距离越近,其中 d<i> 为相似度,理解为到各个anchor的距离,⊙ 为对应元素相乘,该项计算为:
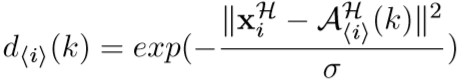
RACE问题将高维的CNN表征转为低维的权重映射,来降低算力损耗。
该问题为标准二次规划问题,优化方法:
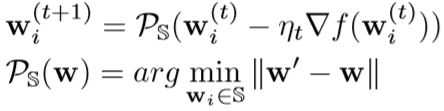
具体求解见:
Efficient projections onto the l 1-ball for learning in high dimensions
Large graph construction for scalable semi-supervised learning
From point to set: Extend the learning of distance metrics
【待阅读】
(4)top-k count 标签估计:
如果两个视频序列属于同一个行人,那么它们在不同的衡量维度上需要非常接近。具体来说,如果未标签序列 xi 属于行人 ,需要满足两个条件:
①  应当是距离 xi 最近的部分anchor之一,定义为:
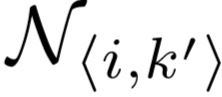 ;
② 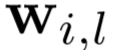 应当足够大。
定义预测的标签为:
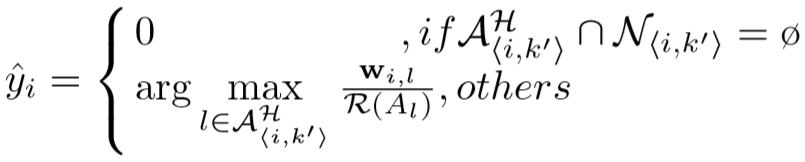
其中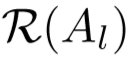 表示
 在
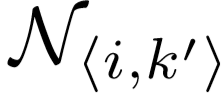 中的排名。
【疑问:已经是最近的 k 个最近的anchor了,为什么还要判断是不是最近的 k' 个?】
Experimental Results
(1)实验设置:
① 数据集:PRID-2011,iLIDS-VID,MARS;
② 参数设置:dropou = 0.5;图片resize = 128*256;learning rate(MARS)= 0.003,learning rate(PRID-2011, iLIDS-VID) = 0.01,并每20个epoch下降0.1;k = 15,k’ = 1;λ = 0.1。
(2)实验结果:
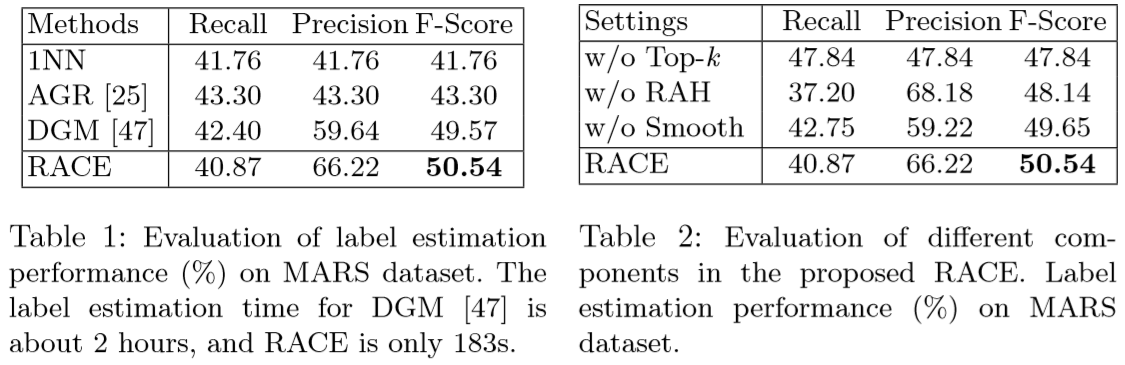
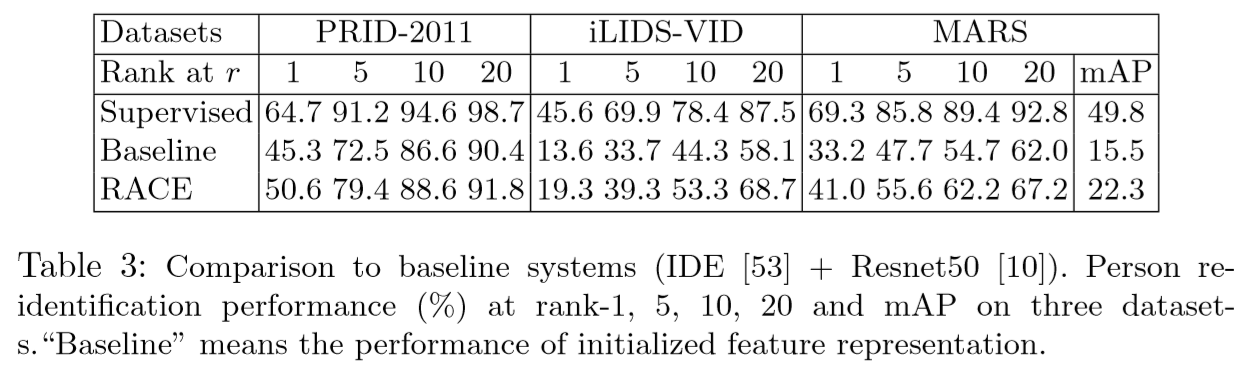
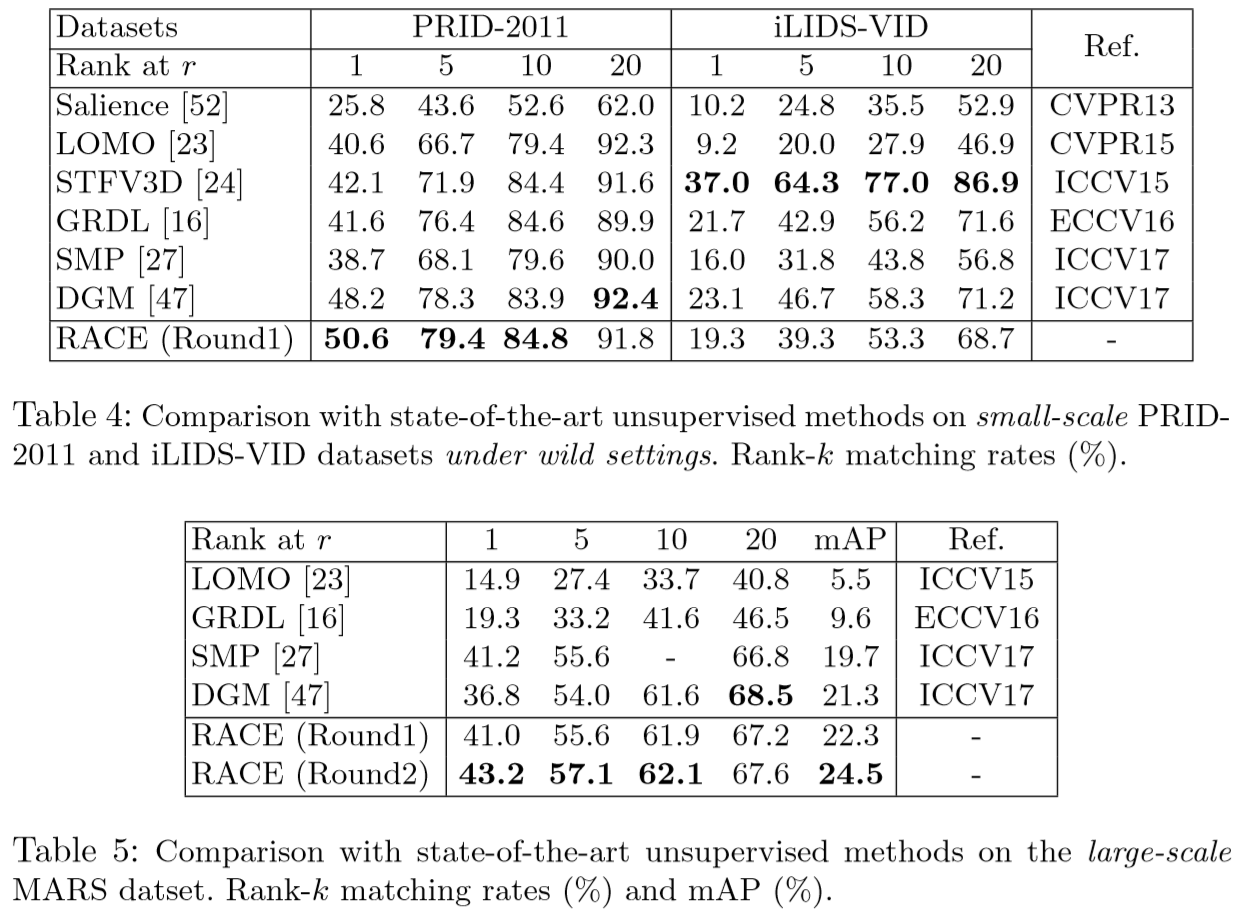
论文阅读笔记(二十三)【ECCV2018】:Robust Anchor Embedding for Unsupervised Video Person Re-Identification in the Wild的更多相关文章
- 论文阅读笔记二十三:Learning to Segment Instances in Videos with Spatial Propagation Network(CVPR2017)
论文源址:https://arxiv.org/abs/1709.04609 摘要 该文提出了基于深度学习的实例分割框架,主要分为三步,(1)训练一个基于ResNet-101的通用模型,用于分割图像中的 ...
- 论文阅读笔记二十七:Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks(CVPR 2016)
论文源址:https://arxiv.org/abs/1506.01497 tensorflow代码:https://github.com/endernewton/tf-faster-rcnn 室友对 ...
- 论文阅读笔记三十三:Feature Pyramid Networks for Object Detection(FPN CVPR 2017)
论文源址:https://arxiv.org/abs/1612.03144 代码:https://github.com/jwyang/fpn.pytorch 摘要 特征金字塔是用于不同尺寸目标检测中的 ...
- 论文阅读笔记二十五:Spatial Pyramid Pooling in Deep Convolutional Networks for Visual Recognition(SPPNet CVPR2014)
论文源址:https://arxiv.org/abs/1406.4729 tensorflow相关代码:https://github.com/peace195/sppnet 摘要 深度卷积网络需要输入 ...
- 论文阅读笔记二十四:Rich feature hierarchies for accurate object detection and semantic segmentation Tech report(R-CNN CVPR2014)
论文源址:http://www.cs.berkeley.edu/~rbg/#girshick2014rcnn 摘要 在PASCAL VOC数据集上,最好的方法的思路是将低级信息与较高层次的上下文信息进 ...
- 论文阅读笔记二十一:MULTI-SCALE CONTEXT AGGREGATION BY DILATED CONVOLUTIONS(ICRL2016)
论文源址:https://arxiv.org/abs/1511.07122 tensorflow Github:https://github.com/ndrplz/dilation-tensorflo ...
- 论文阅读笔记六十三:DeNet: Scalable Real-time Object Detection with Directed Sparse Sampling(CVPR2017)
论文原址:https://arxiv.org/abs/1703.10295 github:https://github.com/lachlants/denet 摘要 本文重新定义了目标检测,将其定义为 ...
- 论文阅读笔记五十三:Libra R-CNN: Towards Balanced Learning for Object Detection(CVPR2019)
论文原址:https://arxiv.org/pdf/1904.02701.pdf github:https://github.com/OceanPang/Libra_R-CNN 摘要 相比模型的结构 ...
- 论文阅读笔记四十三:DeeperLab: Single-Shot Image Parser(CVPR2019)
论文原址:https://arxiv.org/abs/1902.05093 github:https://github.com/lingtengqiu/Deeperlab-pytorch 摘要 本文提 ...
随机推荐
- day05【数组】
day05[数组] 1.数组 概念:是一种容器,可以同时存放多个数据. 特点: 数组是一种引用数据类型 数组当中的多个数据,类型必须统一 数组的长度在程序的运行期间不可改变 初始化:在内存当中创建一个 ...
- learn more ,study less(三):超越整体性学习
高效率的学生 成为一名高效率学生或是自学者需 要掌握减少花在书本上时间的艺术,我上学时,除了全日制的上课学习,业余时间经营一家 企业,每周写大约 7000 字,健身以及主持一家演讲俱乐部,尽管如此,我 ...
- Serverless 的运行原理与组件架构
本文重点探讨下开发者使用 Serverless 时经常遇到的一些问题,以及如何解决 过去一年,我们和大量 Serverless 用户进行了线上和线下的交流,了解大家的业务场景.对 Serverless ...
- input输入框联想功能
一直想找一个可以连接后台,可以根据后台内容的input输入框,可以实现联想功能,网上找到一个简单的静态页面的输入框联想,经过一番修改之后终于可以实现读取自己定义的数组的联想了,其实也比较简单就是格式的 ...
- ffmpeg常用数据结构
from :http://my.oschina.net/u/555701/blog/56748 AVCodecContext 这是一个描述编解码器上下文的数据结构,包含了众多编解码器需要的参数信息,如 ...
- Java 接口及接口回调_Chris
题目: 利用接口和接口回调,实现简单工厂模式,当输入不同的字符,代表相应图形时,利用工厂类获得图形对象,再计算以该图形为底的柱体体积. 代码: 1.Test.java /** * 测试类,包含一个主方 ...
- [兴趣使然]用python在命令行下画jandan像素超载鸡
下午刷煎蛋的时候看到 Dthalo 蛋友发的系列像素超载鸡,就想自己试试用python脚本画一个,老男孩视频里的作业真没兴趣,弄不好吧没意思,往好了写,自己控制不好,能力不够. 所以还是找自己有兴趣的 ...
- Django (一) 基础
创建项目 创建app python manager.py startapp app01 修改.添加url from django.conf.urls import url,include fr ...
- Python编程:从入门到实践——【作业】——第六章(字典)
第六章作业 6-1 人 : 使用一个字典来存储一个熟人的信息, 包括名. 姓. 年龄和居住的城市. 该字典应包含键first_name . last_name . age 和city . 将存储在该字 ...
- oracle数据库重要的查询语句
查看所有数据文件(dbf文件)的存放位置 SQL> select name from v$datafile; 标红色的为默认表空间文件 SQL> select name from v$da ...