
Spark 系列(十二)—— Spark SQL JOIN 操作
一、 数据准备
本文主要介绍 Spark SQL 的多表连接,需要预先准备测试数据。分别创建员工和部门的 Datafame,并注册为临时视图,代码如下:
val spark = SparkSession.builder().appName("aggregations").master("local[2]").getOrCreate()

val empDF = spark.read.json("/usr/file/json/emp.json")
empDF.createOrReplaceTempView("emp")

val deptDF = spark.read.json("/usr/file/json/dept.json")
deptDF.createOrReplaceTempView("dept")
两表的主要字段如下:
emp 员工表
 |-- ENAME: 员工姓名
 |-- DEPTNO: 部门编号
 |-- EMPNO: 员工编号
 |-- HIREDATE: 入职时间
 |-- JOB: 职务
 |-- MGR: 上级编号
 |-- SAL: 薪资
 |-- COMM: 奖金
dept 部门表
|-- DEPTNO: 部门编号
|-- DNAME: 部门名称
|-- LOC: 部门所在城市注:emp.json,dept.json 可以在本仓库的resources 目录进行下载。
二、连接类型
Spark 中支持多种连接类型:
- Inner Join : 内连接;
- Full Outer Join : 全外连接;
- Left Outer Join : 左外连接;
- Right Outer Join : 右外连接;
- Left Semi Join : 左半连接;
- Left Anti Join : 左反连接;
- Natural Join : 自然连接;
- Cross (or Cartesian) Join : 交叉 (或笛卡尔) 连接。
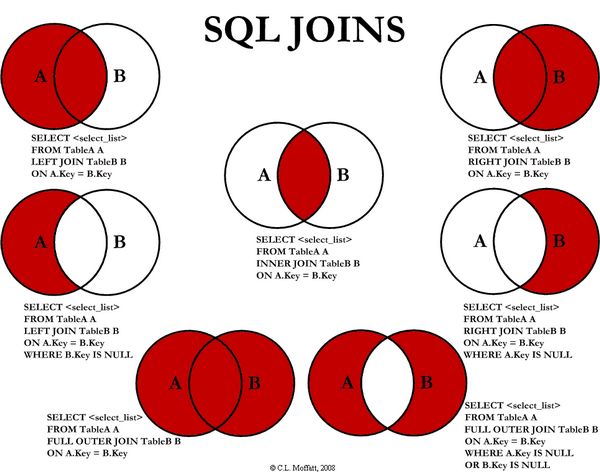
其中内,外连接,笛卡尔积均与普通关系型数据库中的相同,如下图所示:
这里解释一下左半连接和左反连接,这两个连接等价于关系型数据库中的 IN 和 NOT IN 字句:
-- LEFT SEMI JOIN
SELECT * FROM emp LEFT SEMI JOIN dept ON emp.deptno = dept.deptno
-- 等价于如下的 IN 语句
SELECT * FROM emp WHERE deptno IN (SELECT deptno FROM dept)

-- LEFT ANTI JOIN
SELECT * FROM emp LEFT ANTI JOIN dept ON emp.deptno = dept.deptno
-- 等价于如下的 IN 语句
SELECT * FROM emp WHERE deptno NOT IN (SELECT deptno FROM dept)
所有连接类型的示例代码如下:
2.1 INNER JOIN
// 1.定义连接表达式
val joinExpression = empDF.col("deptno") === deptDF.col("deptno")
// 2.连接查询
empDF.join(deptDF,joinExpression).select("ename","dname").show()

// 等价 SQL 如下:
spark.sql("SELECT ename,dname FROM emp JOIN dept ON emp.deptno = dept.deptno").show()
2.2 FULL OUTER JOIN
empDF.join(deptDF, joinExpression, "outer").show()
spark.sql("SELECT * FROM emp FULL OUTER JOIN dept ON emp.deptno = dept.deptno").show()
2.3 LEFT OUTER JOIN
empDF.join(deptDF, joinExpression, "left_outer").show()
spark.sql("SELECT * FROM emp LEFT OUTER JOIN dept ON emp.deptno = dept.deptno").show()
2.4 RIGHT OUTER JOIN
empDF.join(deptDF, joinExpression, "right_outer").show()
spark.sql("SELECT * FROM emp RIGHT OUTER JOIN dept ON emp.deptno = dept.deptno").show()
2.5 LEFT SEMI JOIN
empDF.join(deptDF, joinExpression, "left_semi").show()
spark.sql("SELECT * FROM emp LEFT SEMI JOIN dept ON emp.deptno = dept.deptno").show()
2.6 LEFT ANTI JOIN
empDF.join(deptDF, joinExpression, "left_anti").show()
spark.sql("SELECT * FROM emp LEFT ANTI JOIN dept ON emp.deptno = dept.deptno").show()
2.7 CROSS JOIN
empDF.join(deptDF, joinExpression, "cross").show()
spark.sql("SELECT * FROM emp CROSS JOIN dept ON emp.deptno = dept.deptno").show()
2.8 NATURAL JOIN
自然连接是在两张表中寻找那些数据类型和列名都相同的字段,然后自动地将他们连接起来,并返回所有符合条件的结果。
spark.sql("SELECT * FROM emp NATURAL JOIN dept").show()以下是一个自然连接的查询结果,程序自动推断出使用两张表都存在的 dept 列进行连接,其实际等价于:
spark.sql("SELECT * FROM emp JOIN dept ON emp.deptno = dept.deptno").show()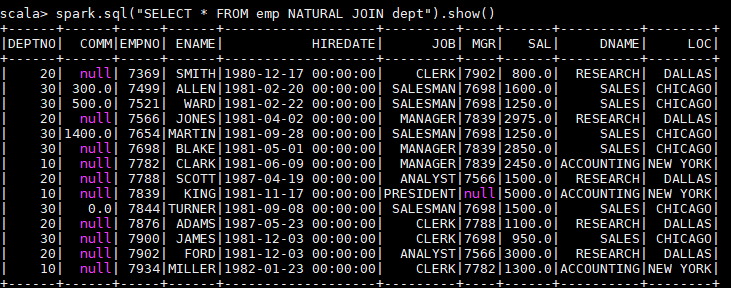
由于自然连接常常会产生不可预期的结果,所以并不推荐使用。
三、连接的执行
在对大表与大表之间进行连接操作时,通常都会触发 Shuffle Join,两表的所有分区节点会进行 All-to-All 的通讯,这种查询通常比较昂贵,会对网络 IO 会造成比较大的负担。
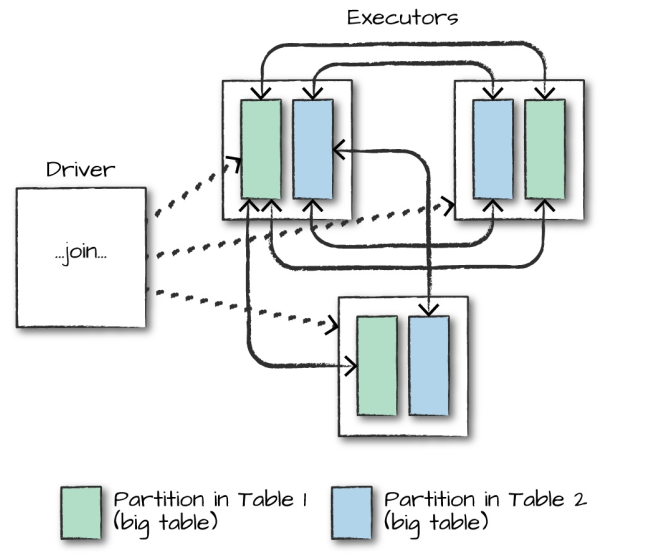
而对于大表和小表的连接操作,Spark 会在一定程度上进行优化,如果小表的数据量小于 Worker Node 的内存空间,Spark 会考虑将小表的数据广播到每一个 Worker Node,在每个工作节点内部执行连接计算,这可以降低网络的 IO,但会加大每个 Worker Node 的 CPU 负担。

是否采用广播方式进行 Join 取决于程序内部对小表的判断,如果想明确使用广播方式进行 Join,则可以在 DataFrame API 中使用 broadcast 方法指定需要广播的小表:
empDF.join(broadcast(deptDF), joinExpression).show()参考资料
- Matei Zaharia, Bill Chambers . Spark: The Definitive Guide[M] . 2018-02
更多大数据系列文章可以参见 GitHub 开源项目: 大数据入门指南
Spark 系列(十二)—— Spark SQL JOIN 操作的更多相关文章
- SQL Server 2008空间数据应用系列十二:Bing Maps中呈现GeoRSS订阅的空间数据
原文:SQL Server 2008空间数据应用系列十二:Bing Maps中呈现GeoRSS订阅的空间数据 友情提示,您阅读本篇博文的先决条件如下: 1.本文示例基于Microsoft SQL Se ...
- MySQL 系列(二) 你不知道的数据库操作
第一篇:MySQL 系列(一) 生产标准线上环境安装配置案例及棘手问题解决 第二篇:MySQL 系列(二) 你不知道的数据库操作 本章内容: 查看\创建\使用\删除 数据库 用户管理及授权实战 局域网 ...
- Alamofire源码解读系列(十二)之请求(Request)
本篇是Alamofire中的请求抽象层的讲解 前言 在Alamofire中,围绕着Request,设计了很多额外的特性,这也恰恰表明,Request是所有请求的基础部分和发起点.这无疑给我们一个Req ...
- 爬虫系列(十二) selenium的基本使用
一.selenium 简介 随着网络技术的发展,目前大部分网站都采用动态加载技术,常见的有 JavaScript 动态渲染和 Ajax 动态加载 对于爬取这些网站,一般有两种思路: 分析 Ajax 请 ...
- 第十二章 Python文件操作【转】
12.1 open() open()函数作用是打开文件,返回一个文件对象. 用法格式:open(name[, mode[, buffering[,encoding]]]) -> file obj ...
- Web 前端开发精华文章推荐(jQuery、HTML5、CSS3)【系列十二】
2012年12月12日,[<Web 前端开发人员和设计师必读文章>系列十二]和大家见面了.梦想天空博客关注 前端开发 技术,分享各种增强网站用户体验的 jQuery 插件,展示前沿的 HT ...
- struts2官方 中文教程 系列十二:控制标签
介绍 struts2有一些控制语句的标签,本教程中我们将讨论如何使用 if 和iterator 标签.更多的控制标签可以参见 tags reference. 到此我们新建一个struts2 web 项 ...
- Spark系列之二——一个高效的分布式计算系统
1.什么是Spark? Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有H ...
- Spark(十二)--性能调优篇
一段程序只能完成功能是没有用的,只能能够稳定.高效率地运行才是生成环境所需要的. 本篇记录了Spark各个角度的调优技巧,以备不时之需. 一.配置参数的方式和观察性能的方式 额...从最基本的开始讲, ...
- Spark(十二)SparkSQL简单使用
一.SparkSQL的进化之路 1.0以前: Shark 1.1.x开始:SparkSQL(只是测试性的) SQL 1.3.x: SparkSQL(正式版本)+Datafram ...
随机推荐
- socket简单实践
目录 socket模块: family(socket家族) fileno=None 请忽略,特殊用途 socket模块: 把tcp/ip协议层的各种数据封装啦.数据发送.接收等通过代码已经给你封装 应 ...
- 【转】Java 8新特性(四):新的时间和日期API
Java 8另一个新增的重要特性就是引入了新的时间和日期API,它们被包含在java.time包中.借助新的时间和日期API可以以更简洁的方法处理时间和日期. 在介绍本篇文章内容之前,我们先来讨论Ja ...
- MySQL explain使用
1.介绍 EXPLAIN 命令用于SQL语句的查询执行计划.这条命令的输出结果能够让我们了解MySQL 优化器(optimlzer)是如何执行SQL 语句的.这条命令并没有提供任何调整建议,但它能够提 ...
- Monkey框架(测试方法篇) - monkey测试实例
一.常规的稳定性测试 测试背景: 这是一个海外的合作项目,被测程序是Android应用(App).测试希望通过Monkey来模拟用户长时间的随机操作,检查被测应用是否会出现异常(应用崩溃或者无响应). ...
- layui如何隐藏弹出层关闭的按钮
layui默认弹出层是带有关闭按钮的,但是在某些场景我们不需要layui的关闭按钮,这时只需添加closeBtn :0即可 效果图如下: 示例代码如下: layui.use('layer', func ...
- jsoup获取标签下的文本(去除子标签的)
jsoup获取标签下的文本(去除子标签的) <pre name="code" class="java">Element content=doc.se ...
- odoo开发笔记 -- 多个子类继承同一个父类方法的执行顺序
场景描述: odoo模块化开发的架构理念,科学&高效, 可以让很多业务场景,尽可能松耦合:让开发人员的主要精力,关注在当前的业务逻辑: 所谓「前人栽树,后人乘凉」,模块整体好比一棵大树, 开发 ...
- index row size 2720 exceeds maximum 2712 for index "xxx" ,Values larger than 1/3 of a buffer page cannot be indexed.
记录一个bug情况: 我有个表NewTable,复合主键(slaveid,resid,owner) CREATE TABLE "public"."NewTable&quo ...
- Oracle系列二 基本的SQL SELECT语句
1.查询表中全部数据 示例: SELECT * FROM employees; 说明: SELECT 标识 选择哪些列. FROM 标识从哪个表中选择. * 选择全部 ...
- 3秒钟unittest入门使用
一:unittest跑起来 unittest使用,具体使用方式可以查看unittest官网,以下简单做个介绍,在工作中使用最多的 # 第一步: 创建unittest类,且一定要继承unittest.T ...