
hadoop 完全分布式搭建总结
完全分布式---------------
1.配置文件
[core-site.xml]
hdfs 地址 fs.defaultFS=hdfs://s129:8020/
[hdfs-site.xml] 副本
replication=1 //伪分布
replication=3 //完全分布
[mapred-site.xml] yarn框架
mapreduce.framework.name=yarn
[yarn-site.xml] 资源管理器主机名
rm.name=s129
[slaves]
s128
s127
s126
2.分发文件
a)ssh
openssh-server //sshd
openssh-clients //ssh
openssh //ssh-keygen
b)scp/rsync
3.格式化文件系统
$>hadoop namenode -format
4.启动hadoop所有进程
//start-dfs.sh + start-yarn.sh
$>start-all.sh
5.xcall.sh jps
创建符号连接 ln -s xxxx xx
ln -s /opt/jdk8/bin/java java
ln -s /opt/jdk8/bin/jps jps
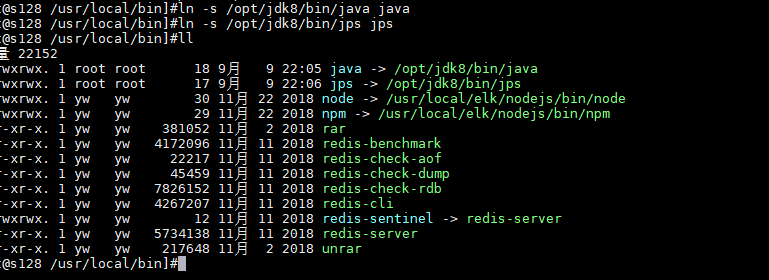
/usr/local/bin/jps
/usr/local/bin/java
6.查看jps进程
$>xcall.sh jps
或
$>netstat -tunpl | grep 端口号
7.关闭centos的防火墙
$>sudo service firewalld stop // <=6.5 start/stop/status/restart
$>sudo systemctl stop firewalld // 7.0 停止 start/stop/status/restart
$>sudo systemctl disable firewalld //关闭
$>sudo systemctl enable firewalld //启用
7.最终通过webui
http://s201:50070/
符号连接
----------------
1.修改符号连接的owner
$>chown -h centos:centos xxx //-h:针对连接本身,而不是所指文件.
2.修改符号链接
$>ln -sfT index.html index //覆盖原有的连接。
运行命令
start-all.sh 启动所有的Hadoop守护进程。包括NameNode、 Secondary NameNode、DataNode、JobTracker、 TaskTrack
stop-all.sh 停止所有的Hadoop守护进程。包括NameNode、 Secondary NameNode、DataNode、JobTracker、 TaskTrack
start-dfs.sh 启动Hadoop HDFS守护进程NameNode、SecondaryNameNode和DataNode
stop-dfs.sh 停止Hadoop HDFS守护进程NameNode、SecondaryNameNode和DataNode
hadoop-daemons.sh start namenode 单独启动NameNode守护进程
hadoop-daemons.sh stop namenode 单独停止NameNode守护进程
hadoop-daemons.sh start datanode 单独启动DataNode守护进程
hadoop-daemons.sh stop datanode 单独停止DataNode守护进程
hadoop-daemons.sh start secondarynamenode 单独启动SecondaryNameNode守护进程
hadoop-daemons.sh stop secondarynamenode 单独停止SecondaryNameNode守护进程
start-mapred.sh 启动Hadoop MapReduce守护进程JobTracker和TaskTracker
stop-mapred.sh 停止Hadoop MapReduce守护进程JobTracker和TaskTracker
hadoop-daemons.sh start jobtracker 单独启动JobTracker守护进程
hadoop-daemons.sh stop jobtracker 单独停止JobTracker守护进程
hadoop-daemons.sh start tasktracker 单独启动TaskTracker守护进程
hadoop-daemons.sh stop tasktracker 单独启动TaskTracker守护进程
hadoop模块
-------------------
common //
hdfs //
mapreduce //
yarn //
进程
------------------
[hdfs]start-dfs.sh
NameNode NN
DataNode DN
SecondaryNamenode 2NN
[yarn]start-yarn.sh
ResourceMananger RM
NodeManager NM
脚本分析
-------------------
sbin/start-all.sh
--------------
libexec/hadoop-config.sh
start-dfs.sh
start-yarn.sh
sbin/start-dfs.sh
--------------
libexec/hadoop-config.sh
sbin/hadoop-daemons.sh --config .. --hostname .. start namenode ...
sbin/hadoop-daemons.sh --config .. --hostname .. start datanode ...
sbin/hadoop-daemons.sh --config .. --hostname .. start sescondarynamenode ...
sbin/hadoop-daemons.sh --config .. --hostname .. start zkfc ... //
sbin/start-yarn.sh
--------------
libexec/yarn-config.sh
bin/yarn-daemon.sh start resourcemanager
bin/yarn-daemons.sh start nodemanager
sbin/hadoop-daemons.sh
----------------------
libexec/hadoop-config.sh
slaves
hadoop-daemon.sh
sbin/hadoop-daemon.sh
-----------------------
libexec/hadoop-config.sh
bin/hdfs ....
sbin/yarn-daemon.sh
-----------------------
libexec/yarn-config.sh
bin/yarn
bin/hadoop
------------------------
hadoop verion //版本
hadoop fs //文件系统客户端.
hadoop jar //
hadoop classpath
hadoop checknative
bin/hdfs
------------------------
dfs // === hadoop fs
classpath
namenode -format
secondarynamenode
namenode
journalnode
zkfc
datanode
dfsadmin
haadmin
fsck
balancer
jmxget
mover
oiv
oiv_legacy
oev
fetchdt
getconf
groups
snapshotDiff
lsSnapshottableDir
portmap
nfs3
cacheadmin
crypto
storagepolicies
version
hdfs常用命令
--------------------
hdfs dfs -ls / (查看文件系统列表)
$>hdfs dfs -mkdir /usr/local/hadoop/ (创建目录)
$>hdfs dfs -ls -r /usr/local/hadoop/ (查看)
$>hdfs dfs -lsr /usr/local/hadoop/(递归查看)
$>hdfs dfs -put jdk-8u191-linux-x64.tar.gz /usr/local/hadoop/ (复制文件)
$>hdfs dfs -get /usr/local/hadoop/ xxxx (获取文件)
$>hdfs dfs -rm -r -f /usr/local/hadoop/ (删除)
no route
--------------------
关闭防火墙。
$>su root
$>xcall.sh "service firewalld stop"
$>xcall.sh "systemctl disable firewalld"
hdfs
--------------------
500G
1024G = 2T/4T
切割。
寻址时间:10ms左右
磁盘速率 : 100M /s
64M
128M //让寻址时间占用读取时间的1%.
1ms
1 / 100
size = 181260798
block-0 : 134217728
block-1 : 47043070
--------------------
b0.no : 1073741829
b1.no : 1073741830
HA
-----------------------
high availability,高可用性。通常用几个9衡量。
99.999%
SPOF:
-----------------------
single point of failure,单点故障。解决:多配置节点至少两个
secondarynamenode 辅助名称节点 (定期抓取名称节点数据 不高可用)
----------------------
HDFS

找到所有的配置文件
----------------------
1.tar开hadoop-2.7.3.tar.gz
hadoop-2.7.3\share\hadoop\common\hadoop-common-2.7.3.jar\core-default.xml
hadoop-2.7.3\share\hadoop\hdfs\hadoop-hdfs-2.7.3.jar\hdfs-default.xml
hadoop-2.7.3\share\hadoop\mapreduce\hadoop-mapreduce-client-core-2.7.3.jar\mapred-default.xml
hadoop-2.7.3\share\hadoop\yarn\hadoop-yarn-common-2.7.3.jar\yarn-site.xml
本地模式
-----------
[core-site.xml]
fs.defaultFS=file:/// //默认值
配置hadoop临时目录
---------------------
1.配置[core-site.xml]文件
<configuration>
<property>
<name>fs.defaultFS</name>
<value>hdfs://s129/</value>
</property>
<!--- 配置新的本地目录 -->
<property>
<name>hadoop.tmp.dir</name>
<value>/usr/local/hadoop</value>
</property>
</configuration>
//以下属性均由hadoop.tmp.dir决定,在hdfs-site.xml文件中配置。
dfs.namenode.name.dir=file://${hadoop.tmp.dir}/dfs/name
dfs.datanode.data.dir=file://${hadoop.tmp.dir}/dfs/data
dfs.datanode.data.dir=file://${hadoop.tmp.dir}/dfs/data
dfs.namenode.checkpoint.dir=file://${hadoop.tmp.dir}/dfs/namesecondary
dfs.namenode.checkpoint.dir=file://${hadoop.tmp.dir}/dfs/namesecondary
2.分发core-site.xml文件
$>xsync core-site.xml
3.格式化文件系统,只对namenode的本地目录进行初始化。
$>hadoop namenode -format //hdfs namenode -format
4.启动hadoop
$>start-dfs.sh
使用xcall.sh在所有节点上创建jps符号连接,指向/soft/jdk/bin/jps
------------------------------------------------------------------

1.切换到root用户
$>su root
2.创建符号连接
$>xcall.sh "ln -sfT /soft/jdk/bin/jps /usr/local/bin/jps"
3.修改jps符号连接的owner
$>xcall.sh "chown -h centos:centos /usr/local/bin/jps"
4.查看所有主机上的java进程
$>xcall.sh jps
在centos桌面版中安装eclipse 在虚拟机中编写代码
----------------------------
1.下载eclipse linux版
eclipse-jee-mars-R-linux-gtk-x86_64.tar.gz
2.tar开到/soft下,
$>tar -xzvf eclipse-jee-mars-R-linux-gtk-x86_64.tar.gz -C /soft
3.启动eclipse
$>cd /soft/eclipse
$>./eclipse & //后台启动
4.创建桌面快捷方式
$>ln -s /soft/eclipse/eclipse ~/Desktop/eclipse
5.
hadoop 完全分布式搭建总结的更多相关文章
- hadoop完全分布式搭建HA(高可用)
2018年03月25日 16:25:26 D调的Stanley 阅读数:2725 标签: hadoop HAssh免密登录hdfs HA配置hadoop完全分布式搭建zookeeper 配置 更多 个 ...
- 超详细解说Hadoop伪分布式搭建--实战验证【转】
超详细解说Hadoop伪分布式搭建 原文http://www.tuicool.com/articles/NBvMv2原原文 http://wojiaobaoshanyinong.iteye.com/b ...
- 3.hadoop完全分布式搭建
3.Hadoop完全分布式搭建 1.完全分布式搭建 配置 #cd /soft/hadoop/etc/ #mv hadoop local #cp -r local full #ln -s full ha ...
- Hadoop伪分布式搭建(一)
下面内容主要说明在Windows虚拟机上面,怎么搭建一个Hadoop伪分布式,并如何运行wordcount程序和网页查看HDFS文件系统. 1 相关软件下载和安装 APACH官网提供hadoop版本 ...
- Hadoop伪分布式搭建步骤
说明: 搭建环境是VMware10下用的是Linux CENTOS 32位,Hadoop:hadoop-2.4.1 JAVA :jdk7 32位:本文是本人在网络上收集的HADOOP系列视频所附带的 ...
- Hadoop 完全分布式搭建
搭建环境 https://www.cnblogs.com/YuanWeiBlogger/p/11456623.html 修改主机名------------------- 1./etc/hostname ...
- hadoop 伪分布式搭建
下载hadoop1.0.4版本,和jdk1.6版本或更高版本:1. 安装JDK,安装目录大家可以自定义,下面是我的安装目录: /usr/jdk1.6.0_22 配置环境变量: [root@hadoop ...
- Hadoop完全分布式搭建过程中遇到的问题小结
前一段时间,终于抽出了点时间,在自己本地机器上尝试搭建完全分布式Hadoop集群环境,也是借助网络上虾皮的Hadoop开发指南系列书籍一步步搭建起来的,在这里仅代表hadoop初学者向虾皮表示衷心的感 ...
- Hadoop完全分布式搭建流程
centos7 搭建完全分布式 Hadoop 环境 SSR 前言 本次教程是以先创建 四台虚拟机 为基础,再配置好一台虚拟机的情况下,直接复制文件到另外的虚拟机中(这样做大大简化了安装流程) 且本次 ...
- Hadoop伪分布式搭建CentOS
所需软件及版本: jdk-7u80-linux-x64.tar.gz hadoop-2.6.0.tar.gz 1.安装JDK Hadoop 在需在JDK下运行,注意JDK最好使用Oracle的否则可能 ...
随机推荐
- appium+python 微信小程序的自动化
sudo kill -9 $(lsof -i:8889 -t) mitmweb -p 8889 -s addons.py mitmdump -q -p 8889 -s addons.py http: ...
- Go -- client 302 自动转 200 问题 cookie存储 模拟登陆问题
不久前用go写了个http client,去模拟某网站(*.com)的登录操作.网站的登录逻辑:1.验证登录账号和密码:2.下发token.此token通过cookie下发:3.redirect到主页 ...
- RK3399 pro 开发记录
RK3399有三种启动模式:1.Normal模式:2.Loader模式:3.MaskRom模式. Normal模式是正常的启动过程,各个组件依次加载,直到正常进入系统. Loade ...
- Spring AOP设计
Spring IOC设计到的设计模式: 工厂模式,模板方法模式,单例模式 Spring AOP涉及到的设计模式: 工厂模式,代理模式 1.Spring AOP目标 将分散在程序各处的横切关注点剥离出来 ...
- 分库分表 or NewSQL数据库?终于看懂应该怎么选!【转】
最近与同行科技交流,经常被问到分库分表与分布式数据库如何选择,网上也有很多关于中间件+传统关系数据库(分库分表)与NewSQL分布式数据库的文章,但有些观点与判断是我觉得是偏激的,脱离环境去评价方案好 ...
- 制作 python解释器
https://www.zhihu.com/tardis/sogou/qus/27286136
- sass - for循环写法
如要设置多个li的动画延迟时间时 注:这里选择器要加#{}才行 不然就会编译成: 6.7. 插值语句 #{} (Interpolation: #{}) 通过 #{} 插值语句可以在选择器或属性名中使用 ...
- Tosca : 把 inner text 放到变量里,定义变量,使用变量
XB的是分开取 注意颜色要变成蓝色的,才可用 上面是定义 下面是使用 键盘输入变量
- Apache log4j 1.2 - Short introduction to log4j
Apache log4j 1.2 - Short introduction to log4jhttps://logging.apache.org/log4j/1.2/manual.html log4j ...
- linux内核中的电源管理接口
1. pm_runtime_enable/pm_runtime_disable 使能/禁止runtime PM,分别对dev->power.disable_depth执行++和--操作,这个变量 ...