
SparkSQL高并发:读取存储数据库
摘要:实践解析如何利用SarkSQL高并发进行读取数据库和存储数据到数据库。
本文分享自华为云社区《SarkSQL高并发读取数据库和存储数据到数据库》,作者:Copy工程师 。
1. SparkSql 高并发读取数据库
SparkSql连接数据库读取数据给了三个API:
//Construct a DataFrame representing the database table accessible via JDBC URL url named table and connection properties.

Dataset<Row>     jdbc(String url, String table, java.util.Properties properties)

//Construct a DataFrame representing the database table accessible via JDBC URL url named table using connection properties.

Dataset<Row>     jdbc(String url, String table, String[] predicates, java.util.Properties connectionProperties)

//Construct a DataFrame representing the database table accessible via JDBC URL url named table.

Dataset<Row>     jdbc(String url, String table, String columnName, long lowerBound, long upperBound, int numPartitions, java.util.Properties connectionProperties)
三个API介绍:
1. 单个分区,单个task执行,无并发
遇到数据量很大的表,抽取速度慢。
实例:
SparkSession sparkSession = SparkSession.builder().appName("SPARK_FENGDING_TASK1").master("local").config("spark.testing.memory", 471859200).getOrCreate();

// 配置连接属性

Properties dbProps = new Properties();

dbProps.put("user","user");

dbProps.put("password","pwd");

dbProps.put("driver","oracle.jdbc.driver.OracleDriver");

// 连接数据库 获取数据 要使用自己的数据库连接串

Dataset<Row> tableDf = sparkSession.read().jdbc("jdbc:oracle:thin:@IP:1521:DEMO", "TABLE_DEMO", dbProps);

// 返回1

tableDf.rdd().getPartitions();
该API的并发数为1,单分区,不管你留给该任务节点多少资源,都只有一个task执行任务
2. 任意字段分区
该API是第二个API,根据设置的分层条件设置并发度:
def jdbc(

    url: String,

    table: String,

    predicates: Array[String], #这个是分层的条件,一个数组

    connectionProperties: Properties): DataFrame = {

    val parts: Array[Partition] = predicates.zipWithIndex.map { case (part, i) =>

        JDBCPartition(part, i) : Partition

    }

    jdbc(url, table, parts, connectionProperties)

}
实例:
// 设置分区条件 通过入库时间 把 10月和11月 的数据 分两个分区

String[] patitions = {"rksj >= '1569859200' and rksj < '1572537600'","rksj >= '1572537600' and rksj < '1575129600'"};

// 根据StudentId 分15个分区,就会有15个task抽取数据

Dataset<Row> tableDf3 = sparkSession.read().jdbc("jdbc:oracle:thin:@IP:1521:DEMO", "TABLE_DEMO",patitions,dbProps);

// 返回2

tableDf3.rdd().getPartitions();
该API操作相对自由,就是设置分区条件麻烦一点。
3. 根据Long类型字段分区
该API是第三个API,根据设置的分区数并发抽取数据:
def jdbc(

    url: String,

    table: String,

    columnName: String,    # 根据该字段分区,需要为整形,比如id等

    lowerBound: Long,      # 分区的下界

    upperBound: Long,      # 分区的上界

    numPartitions: Int,    # 分区的个数

    connectionProperties: Properties): DataFrame = {

    val partitioning = JDBCPartitioningInfo(columnName, lowerBound, upperBound, numPartitions)

    val parts = JDBCRelation.columnPartition(partitioning)

    jdbc(url, table, parts, connectionProperties)

}
实例:
// 根据StudentId 分15个分区,就会有15个task抽取数据

Dataset<Row> tableDf2 = sparkSession.read().jdbc("jdbc:oracle:thin:@IP:1521:DEMO", "TABLE_DEMO", "studentId",0,1500,15,dbProps);

// 返回10

tableDf2.rdd().getPartitions();
该操作根据分区数设置并发度,缺点是只能用于Long类型字段。
2. 存储数据到数据库
存储数据库API给了Class DataFrameWriter<T>类,该类有存储到文本,Hive,数据库的API。这里只说数据库的API,提一句,如果保存到Text格式,只支持保存一列。。。就很难受。
实例:
有三种写法
// 第一张写法,指定format类型,使用save方法存储数据库

jdbcDF.write()

  .format("jdbc")

  .option("url", "jdbc:postgresql:dbserver")

  .option("dbtable", "schema.tablename")

  .option("user", "username")

  .option("password", "password")

  .save();

// 第二种写法 使用jdbc写入数据库

jdbcDF2.write()

  .jdbc("jdbc:postgresql:dbserver", "schema.tablename", connectionProperties);

// 第三种写法,也是使用jdbc,只不过添加createTableColumnTypes,创建表的时候使用该属性字段创建表字段

jdbcDF.write()

  .option("createTableColumnTypes", "name CHAR(64), comments VARCHAR(1024)")

  .jdbc("jdbc:postgresql:dbserver", "schema.tablename", connectionProperties);
当我们的表已经存在的时候,使用上面的语句就会报错表已存在,这是因为我们没有指定存储模式,默认是ErrorIfExists
保存模式:
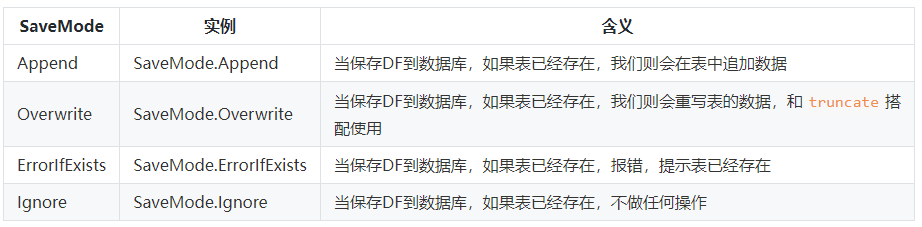
所以一般都是这样用:
tableDf3.write().mode(SaveMode.Append).jdbc("jdbc:oracle:thin:@IP:1521:DEMO", "TABLE_DEMO", connectionProperties);
对于connectionProperties还有很多其他选项:
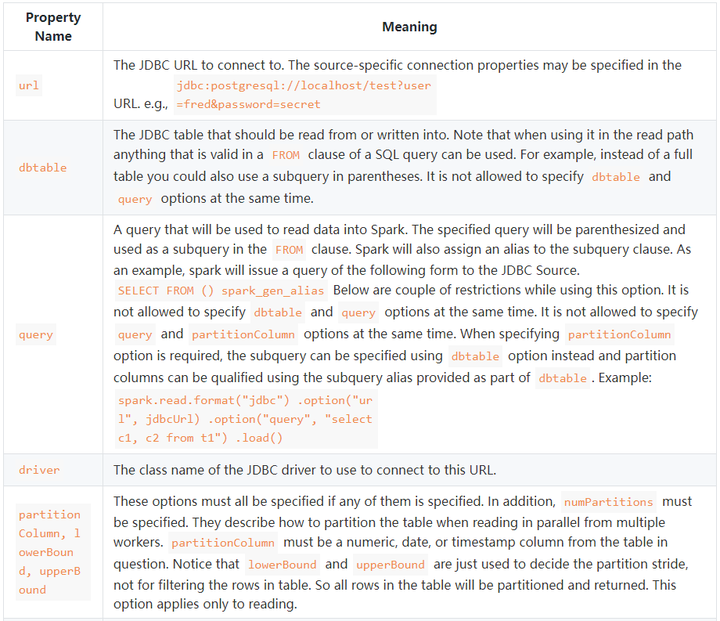
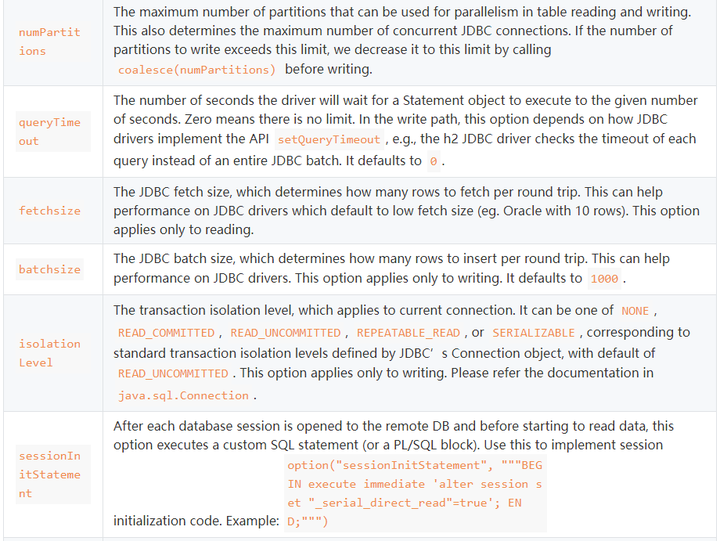
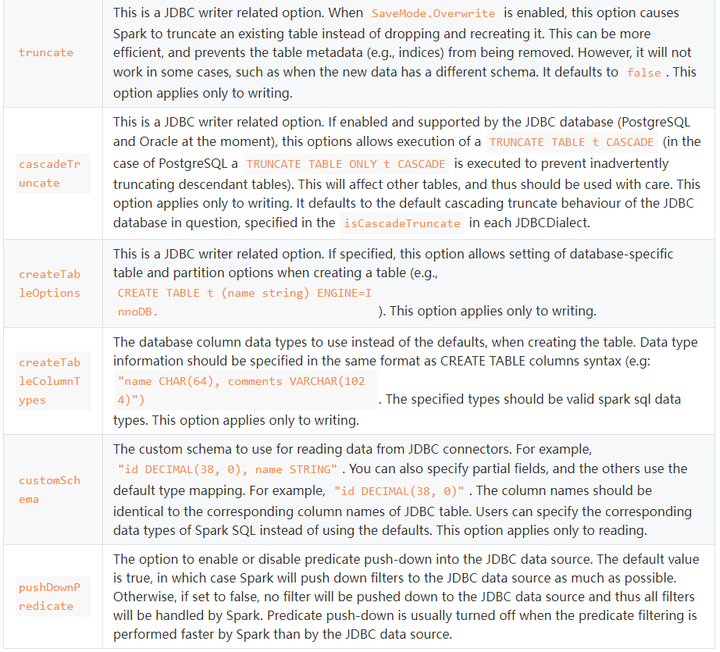
这里面的truncate就是说当使用SaveMode.Overwrite的时候,设置truncate为true,就会对表进行truncate语句清理表,不再是删除表在重建表的操作。
SparkSQL高并发:读取存储数据库的更多相关文章
- 如何在高并发分布式系统中生成全局唯一Id(转)
http://www.cnblogs.com/heyuquan/p/global-guid-identity-maxId.html 又一个多月没冒泡了,其实最近学了些东西,但是没有安排时间整理成博文, ...
- (转)如何在高并发分布式系统中生成全局唯一Id
又一个多月没冒泡了,其实最近学了些东西,但是没有安排时间整理成博文,后续再奉上.最近还写了一个发邮件的组件以及性能测试请看 <NET开发邮件发送功能的全面教程(含邮件组件源码)> ,还弄了 ...
- 【Redis】1、Jedis对管道、事务以及Watch的操作来应对高并发
对于一个互联网平台来说,高并发是经常会遇到的场景.最有代表性的比如秒杀和抢购.高并发会出现三个特点: 1.高并发读取 2.高并发写入(一致性) 3.出现超卖问题 前端如何应对? 1.缓存静态数据,例如 ...
- 高并发分布式系统如何做到唯一Id
又一个多月没冒泡了,其实最近学了些东西,但是没有安排时间整理成博文,后续再奉上.最近还写了一个发邮件的组件以及性能测试请看 <NET开发邮件发送功能的全面教程(含邮件组件源码)> ,还弄了 ...
- Go项目实战:打造高并发日志采集系统(六)
前情回顾 前文我们完成了日志采集系统的日志文件监控,配置文件热更新,协程异常检测和保活机制. 本节目标 本节加入kafka消息队列,kafka前文也介绍过了,可以对消息进行排队,解耦合和流量控制的作用 ...
- SSM实战——秒杀系统之高并发优化
一:高并发点 高并发出现在秒杀详情页,主要可能出现高并发问题的地方有:秒杀地址暴露.执行秒杀操作. 二:静态资源访问(页面)优化——CDN CDN,内容分发网络.我们把静态的资源(html/css/j ...
- 在CentOS上使用Nginx和Tomcat搭建高可用高并发网站
目录 目录 前言 创建CentOS虚拟机 安装Nginx 安装Tomcat 安装lvs和keepalived 反向代理 部署网站 搭建数据库 编写网站项目 解决session一致性 注意 参考资料 前 ...
- Sqlserver 高并发和大数据存储方案
Sqlserver 高并发和大数据存储方案 随着用户的日益递增,日活和峰值的暴涨,数据库处理性能面临着巨大的挑战.下面分享下对实际10万+峰值的平台的数据库优化方案.与大家一起讨论,互相学习提高! ...
- MySQL面试必考知识点:揭秘亿级高并发数据库调优与最佳实践法则
做业务,要懂基本的SQL语句: 做性能优化,要懂索引,懂引擎: 做分库分表,要懂主从,懂读写分离... 数据库的使用,是开发人员的基本功,对它掌握越清晰越深入,你能做的事情就越多. 今天我们用10分钟 ...
- mongodb三种存储引擎高并发更新性能专题测试
背景说明 近期北京理财频道反馈用来存放股市实时数据的MongoDB数据库写响应请求很慢,难以跟上业务写入速度水平.我们分析了线上现场的情况,发现去年升级到SSD磁盘后,数据持久化的磁盘IO开销已经不是 ...
随机推荐
- 一键修改IP多实例
一键修改IP多实例-v1 #!/bin/bash #2020-03-01 #auto change ip #By Flyaway ###################### grep "d ...
- Java面向对象(高级)
1.类变量 类变量是被类的所有实例共享的. 类变量具体放的位置在哪?在内存中的那个区域,这和jdk的版本是有关的 静态变量在类加载的时候就生成了,即使没有创建类实例也能访问,当然通过实例来实现 类变量 ...
- P4870 [BalticOI 2009 Day1]甲虫 题解
题目链接 简要题意 在一个数轴上有 \(n\) 滴露水,每滴露水初始水量为 \(m\),每秒会蒸发一滴水,一个甲虫初始在原点,速度为 1,水能瞬间喝完,问它最多能喝到几滴水. 题目分析 对于这种移动区 ...
- spring---反射(java.lang.reflect)
反射简介 反射是Java的高级特性之一,但是在实际的开发中,使用Java反射的案例却非常的少,但是反射确实在底层框架中被频繁的使用. 比如:JDBC中的加载数据库驱动程序,Spring框架中加载bea ...
- 完蛋!我被 Out of Memory 包围了!
是极致魅惑.洒脱自由的Java heap space? 是知性柔情.温婉大气的GC overhead limit exceeded? 是纯真无邪.活泼可爱的Metaspace? 如果以上不是你的菜,那 ...
- 带您了解 O2OA 流程中的人工活动处理方式
这次咱们来介绍 O2OA (翱途) 开发平台流程引擎中的人工活动的处理方式和逻辑,O2OA (翱途) 主要采用拖拽可视化开发的方式完成流程的设计和配置,不需要过多的代码编写,业务人员可以直接进行修改操 ...
- typeid关键词
typeid是c++的关键字,typeid操作符的返回结果是名为type_info的标准库类型的对象的引用(在头文件typeinfo中定义) ISO C++标准并没有确切定义type_info,它的确 ...
- EventBus 简明教程
简介 EventBus 是一个用于 Android 和 Java 编程的 事件发布/订阅框架.使用 EventBus 进行事件传递,事件的发布和订阅就被充分解耦合,这使得编程人员从传统而原始的事件传递 ...
- Windows10+Python+Yolov8+ONNX图片缺陷识别,并在原图中标记缺陷,有onnx模型则无需配置,无需训练。
目录 一.训练自己数据集的YOLOv8模型 1.博主电脑配置 2.深度学习GPU环境配置 3.yolov8深度学习环境准备 4.准备数据集 二.Python+Onnx模型进行图像缺陷检测,并在原图中标 ...
- .net 温故知新【13】:Asp.Net Core WebAPI 缓存
一.缓存 缓存指在中间层中存储数据的行为,该行为可使后续数据检索更快. 从概念上讲,缓存是一种性能优化策略和设计考虑因素. 缓存可以显著提高应用性能,方法是提高不常更改(或检索成本高)的数据的就绪性. ...