
Hibench对大数据平台CDH/HDP基准性能测试
一、部署方式
1.1、源码/包:https://github.com/Intel-bigdata/HiBench
部署方法:
https://github.com/Intel-bigdata/HiBench/blob/master/docs/build-hibench.md
注意:hibench执行需hadoop客户端jar包环境
如何使用HiBench进行基准测试说明:
https://cloud.tencent.com/developer/article/1158310
二、目录/文件简介

主要介绍下bin执行文件目录和conf配置文件目录。
·2.1配置文件目录--conf

benchmarks.lst 配置需测试项
frameworks.lst 配置测试hadoop或spark
hibench.conf 配置数据量级别及文件数等
hadoop.conf hadoop home、master等配置项
spark.conf spark home、master、 Yarn运行核数、内存等配置项
workloads目录 存放各种具体测试项配置文件
·2.2配置文件说明
|
文件名 |
主要用途 |
|
benchmarks.lst |
主要用于配置benchmarks的模块 |
|
flink.conf.template |
Flink测试的配置参数 |
|
frameworks.lst |
主要用于配置HiBench支持的测试框架 |
|
gearpump.conf.template |
gearpump测试相关配置文件 |
|
hadoop.conf.template |
Hadoop测试相关配置文件 |
|
hibench.conf |
HiBench配置文件 |
|
spark.conf.template |
Spark配置文件 |
|
storm.conf.template |
Strom配置文件 |
·2.3配置文件说明
··2.3.1. benchmarks.lst配置文件
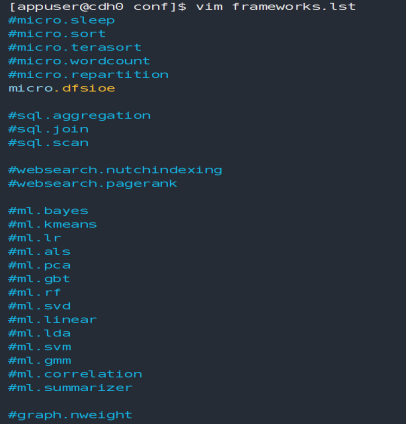
主要用于配置benchmarks列表,配置如下,可以对不需要测试的模块进行屏蔽或者删除,在需要屏蔽在前面加“#”如下:(适用于执行run_all.sh)
··2.3.2. hadoop.conf.template配置文件
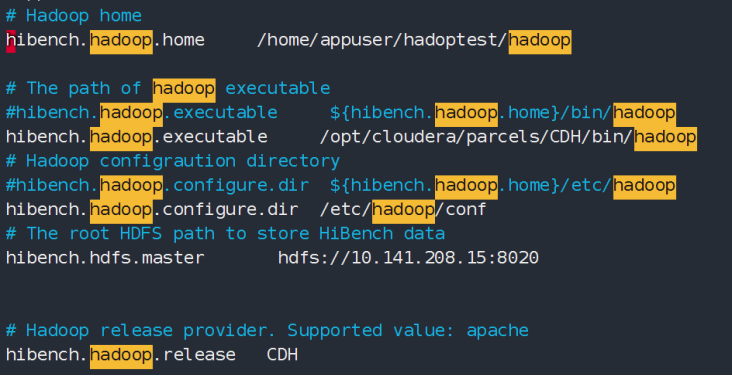
该配置文件主要用于配置Hadoop的环境,如果需要对Hadoop做benchmark测试则需要将该文件重命名为hadoop.conf。
编辑hadoop.conf文件,配置Hadoop环境,此处以CDH的目录配置为例,配置如下:
··2.3.3. spark.conf.template配置文件
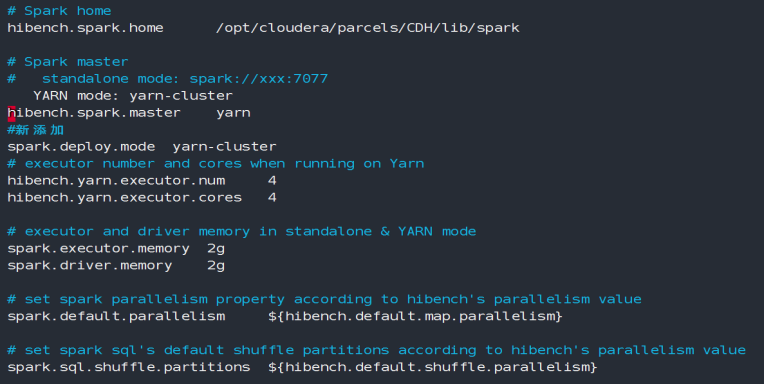
主要用于配置Spark的环境及运行参数,如果需要测试Saprk框架则需要将该配置文件重命名为spark.conf。
编辑spark.conf文件,配置Spark的环境,此处以CDH的目录配置为例,配置如下:根据集群环境调整相应参数。
··2.3.4. hibench.conf配置文件
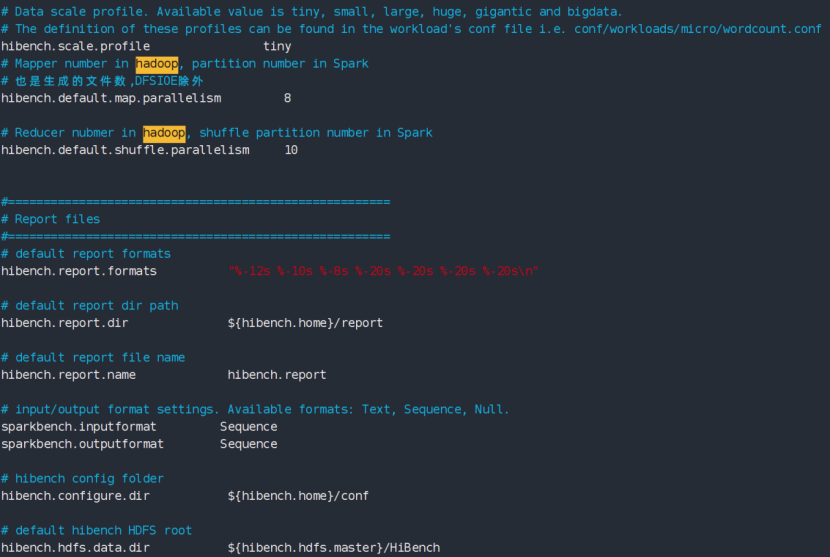
主要配置HiBench的运行参数及HiBench各个模块的home环境配置,根据需要修改相应的配置参数:
主要关注参数hibench.scale.profile、hibench.default.map.parallelism和hibench.default.shuffle.parallelism配置:
hibench.scale.profile:主要配置HiBench测试的数据规模;
hibench.default.map.parallelism:主要配置MapReduce的Mapper数量;
hibench.default.shuffle.parallelism:配置Reduce数量;
注意:
# 也是生成的文件数,DFSIOE除外
例如 hibench.default.map.parallelism 10
wordcount.conf配置数据量为10000000字节(10M),10个文件,及每个文件为1M。
三、数据规模说明
HiBench的默认数据规模有:tiny, small, large, huge, gigantic andbigdata,在这几种数据规模之外Fayson还介绍如何自己指定数据量。
·3.1DFSIOE数据规模介绍及自定义
配置文件:${hibench.home}/conf/workloads/micro/dfsioe.conf
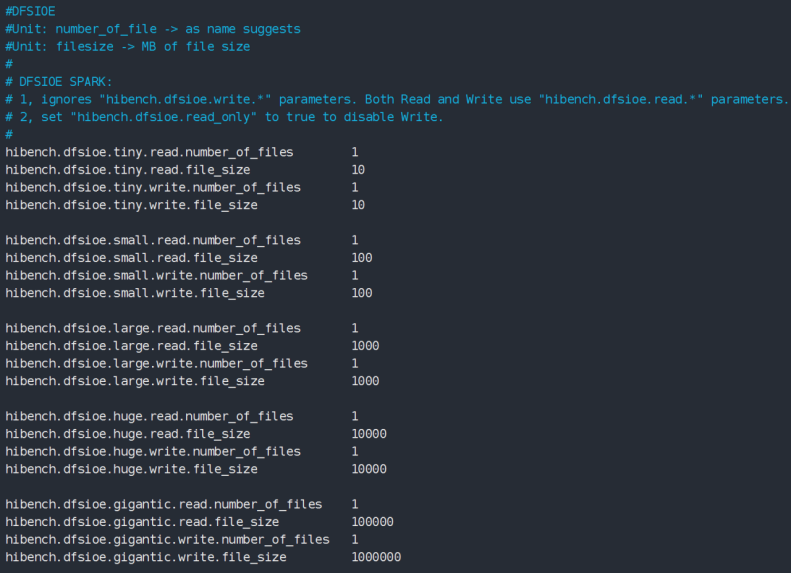
DFSIOE测试用例通过定义读或写的文件数和文件的大小来指定测试数据量的规模,如果需要自定义测试规模则修改文件数和文件的大小即可,文件大小以MB为单位。
例如:我需要自定义一个5TB数量级的DFSIOE测试,在hibench.conf文件中hibench.scale.profile配置的是mybigdata,需要在dfsioe.conf配置文件中增加读写文件数为5120,文件大小设置为1024,具体配置如下:
hibench.dfsioe.mybigdata.read.number_of_files 5120
hibench.dfsioe.mybigdata.read.file_size 1024
hibench.dfsioe.mybigdata.write.number_of_files 5120
hibench.dfsioe.mybigdata.write.file_size 1024
读写测试的数据量均为5TB = 5120 * 1024MB
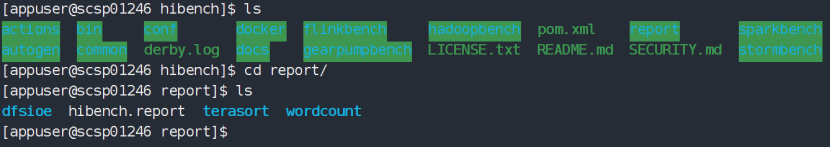
·3.2举例配置单词统计测试项 数据量大小
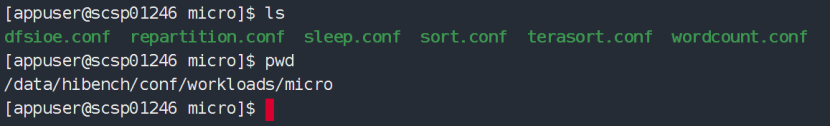
进入/conf/workloads/micro目录下,修改wordcount.conf

注意:dfsioe单位:MB,terasort单位:kb,其他测试项单位为:字节。
四、执行文件目录--bin

方式一:
sh run_all.sh
通过在conf下文件配置好数据量及测试项,批量执行测试项测试,包含数据准备及运行。
方式二:
1、具体测试某一项,以单词统计举例,准备数据可进入
/bin/workloads/micro/wordcount/prepare/
执行prepare.sh
(可执行命令hadoop fs -du -h /Hibench/Wordcount 查看对应各个用例生成的测试数据及用例结果
删除测试数据:sudo -u hdfs hadoop fs -rm -r /Hibench/Wordcount)
2、运行测试,进入/bin/workloads/micro/wordcount/hadoop/ 执行run.sh

五、查看报告文件
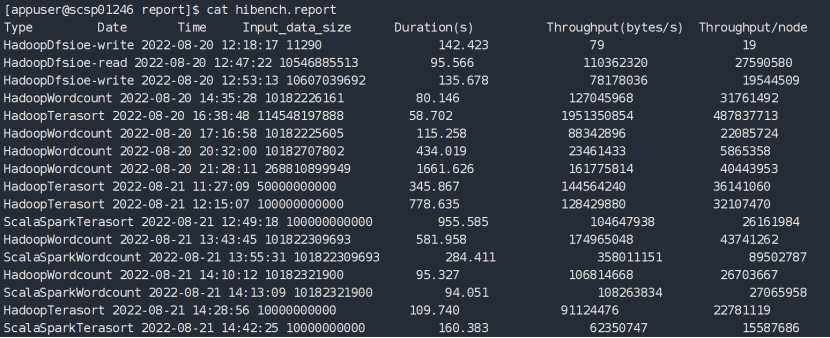
进入/report下,查看 hibench.report,其中包含类型、执行日期和时间,数据量,主要关注:持续时间,吞吐量/秒和吞吐量/节点。
Hibench对大数据平台CDH/HDP基准性能测试的更多相关文章
- 朝花夕拾之--大数据平台CDH集群离线搭建
body { border: 1px solid #ddd; outline: 1300px solid #fff; margin: 16px auto; } body .markdown-body ...
- 大数据 -- Cloudera Manager(简称CM)+CDH构建大数据平台
一.Cloudera Manager介绍 Cloudera Manager(简称CM)是Cloudera公司开发的一款大数据集群安装部署利器,这款利器具有集群自动化安装.中心化管理.集群监控.报警等功 ...
- HDP 企业级大数据平台
一 前言 阅读本文前需要掌握的知识: Linux基本原理和命令 Hadoop生态系统(包括HDFS,Spark的原理和安装命令) 由于Hadoop生态系统组件众多,导致大数据平台多节点的部署,监控极其 ...
- CM记录-CDH大数据平台实施经验总结2016(转载)
CDH大数据平台实施经验总结2016(转载) 2016年负责实施了一个生产环境的大数据平台,用的CDH平台+docker容器的方式,过了快半年了,现在把总结发出来. 1. 平台规划注意事项 1.1 业 ...
- product of大数据平台搭建------CM 和CDH安装
一.安装说明 CM是由cloudera公司提供的大数据组件自动部署和监控管理工具,相应的和CDH是cloudera公司在开源的hadoop社区版的基础上做了商业化的封装的大数据平台. 采用离线安装模式 ...
- CDH构建大数据平台-使用自建的镜像地址安装Cloudera Manager
CDH构建大数据平台-使用自建的镜像地址安装Cloudera Manager 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.搭建CM私有仓库 详情请参考我的笔记: http ...
- CDH 大数据平台搭建
一.概述 Cloudera版本(Cloudera’s Distribution Including Apache Hadoop,简称“CDH”),基于Web的用户界面,支持大多数Hadoop组件,包括 ...
- HDP 大数据平台搭建
一.概述 Apache Ambari是一个基于Web的支持Apache Hadoop集群的供应.管理和监控的开源工具,Ambari已支持大多数Hadoop组件,包括HDFS.MapReduce.Hiv ...
- CDH构建大数据平台-配置集群的Kerberos认证安全
CDH构建大数据平台-配置集群的Kerberos认证安全 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 当平台用户使用量少的时候我们可能不会在一集群安全功能的缺失,因为用户少,团 ...
- CDH构建大数据平台-Kerberos高可用部署【完结篇】
CDH构建大数据平台-Kerberos高可用部署[完结篇] 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.安装Kerberos相关的软件包并同步配置文件 1>.实验环境 ...
随机推荐
- mysql根据.frm和.ibd文件恢复数据表
忠人之事受人之托 起因是因为一位朋友的数据库服务器被重装了,只剩下一个zbp_post.frm和zbp_post.ibd文件.咨询我能不能恢复,确实我只用过mysqldump这种工具导出数据 然后进行 ...
- C# 中的 数组[]、ArrayList、List
C# 中的 数组[].ArrayList.List 数组 在 C# 中,数组实际上是对象,而不只是如在 C 和 C++ 中的连续内存的可寻址区域. 属性: 数组可以是一维.多维或交错的. 创建数组实例 ...
- Django资源网站
Django的官网:https://www.djangoproject.com/ Django Book2.0版本的中文文档:http://djangobook.py3k.cn/2.0/chapter ...
- oracle 11g手工建库步骤(初学者)
要建立的数据库ORACLE_SID=test1sys和system的密码为oracle1.建立相应的目录mkdir /u01/app/oracle/oradata/test1mkdir /u01/ap ...
- ES6之清楚明白的使用类(class)
定义 类是构造函数.原型链的语法糖. 定义类有两种方式 class Student { } var Student = class { } 某些浏览器可能无法解析es6及以上的语法,这时候需要通过ba ...
- [linux]常见内核TCP参数描述与配置
前言 所有的TCP/IP参数都位于/proc/sys/net目录下(请注意,对/proc/sys/net目录下内容的修改都是临时的,任何修改在系统重启后都会丢失),如果需要固化设置,则需要修改/etc ...
- zookeeper运维常用指令
zkServer.sh ./zkServer.sh start:启动zookeeper ./zkServer.sh stop:停止zookeeper ./zkServer.sh status:查看zo ...
- 理解linux的CPU上下文切换
前言 linux是一个多任务操作系统,它支持远大于CPU数量的任务同时运行.当然,这个同时运行不是真的同时运行,而是系统在很短的时间内轮流分配CPU资源,由于CPU的速度很快,所以给人一种同时运行的错 ...
- Jmeter:"An error occurred: Can't connect to X11 window server using 'lacalhost:12.0' as the value of the display variable." 解决办法
做各种不同项目的性能测试,都需要在项目本地压测服务器配置jmeter,需要时还要调出jmeter图形化界面来调试jmeter脚本. 标题中的问题遇过多次,这次做个记录. 1. 启动jmeter报错 在 ...
- centos7.X安装nginx – 东凭渭水流
1.安装nginx需要使用root用户 2.配置nginx源 rpm -ivh http://nginx.org/packages/centos/7/noarch/RPMS/nginx-release ...