
Python爬虫知识点四--scrapy框架
一。scrapy结构数据
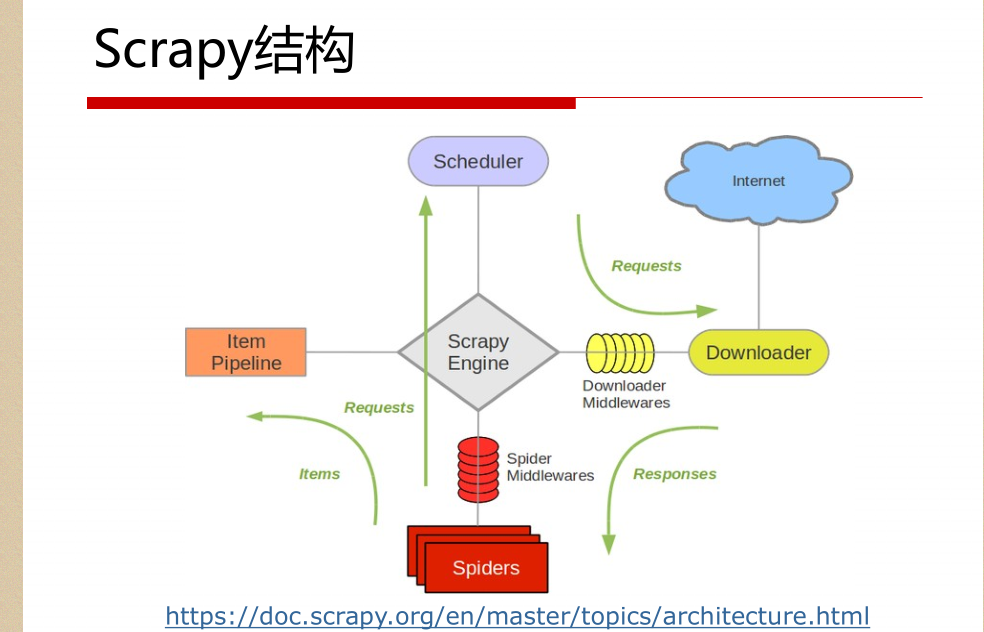
解释:
1.名词解析:
o 引擎(Scrapy Engine)
o 调度器(Scheduler)
o 下载器(Downloader)
o 蜘蛛(Spiders)
o 项目管道(Item Pipeline)
o 下载器中间件(Downloader Middlewares)
o 蜘蛛中间件(Spider Middlewares)
o 调度中间件(Scheduler Middlewares)
2.具体解析
绿线是数据流向
从初始URL开始,Scheduler会将其交给Downloader进
行下载
下载之后会交给Spider进行分析
Spider分析出来的结果有两种
一种是需要进一步抓取的链接,如 “下一页”的链接,它们
会被传回Scheduler;另一种是需要保存的数据,它们被送到Item Pipeline里,进行
后期处理(详细分析、过滤、存储等)。
在数据流动的通道里还可以安装各种中间件,进行必
要的处理。
二。初始化爬虫框架 Scrapy
命令: scrapy startproject qqnews
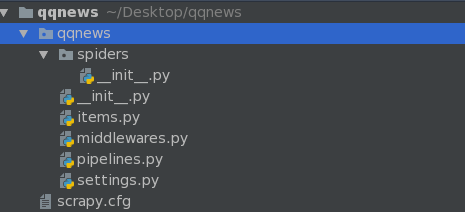
ps:真正的项目是在spiders里面写入的
三。scrapy组件spider
爬取流程
1. 先初始化请求URL列表,并指定下载后处
理response的回调函数。
2. 在parse回调中解析response并返回字典,Item
对象,Request对象或它们的迭代对象。
3 .在回调函数里面,使用选择器解析页面内容
,并生成解析后的结果Item。
4. 最后返回的这些Item通常会被持久化到数据库
中(使用Item Pipeline)或者使用Feed exports将
其保存到文件中。
标准项目结构实例:
1.items结构:定义变量,根据不同种数据结构定义
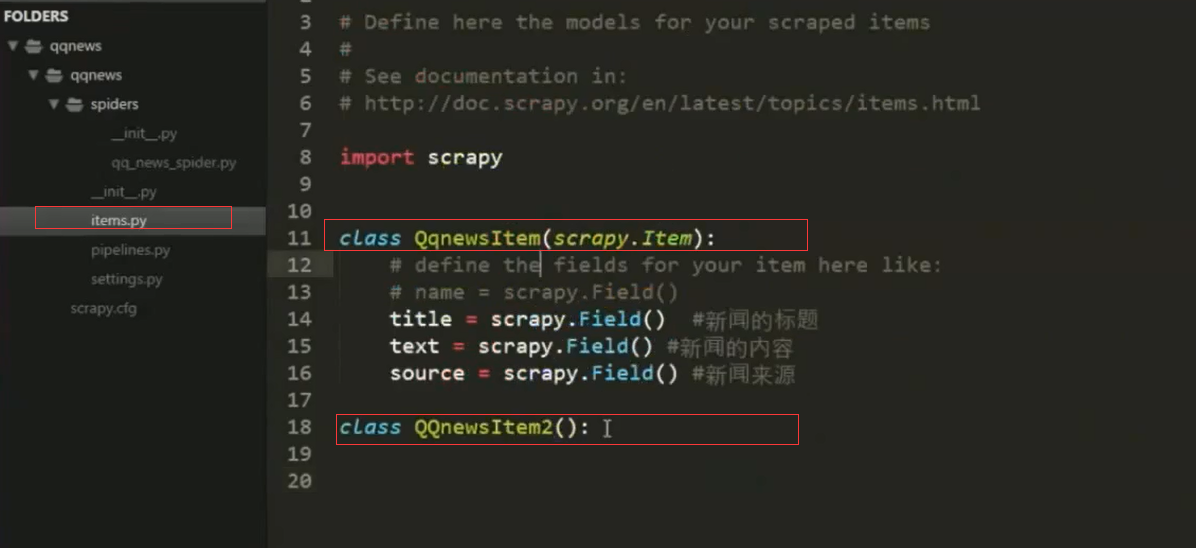
2.spider结构中引入item里面,并作填充item
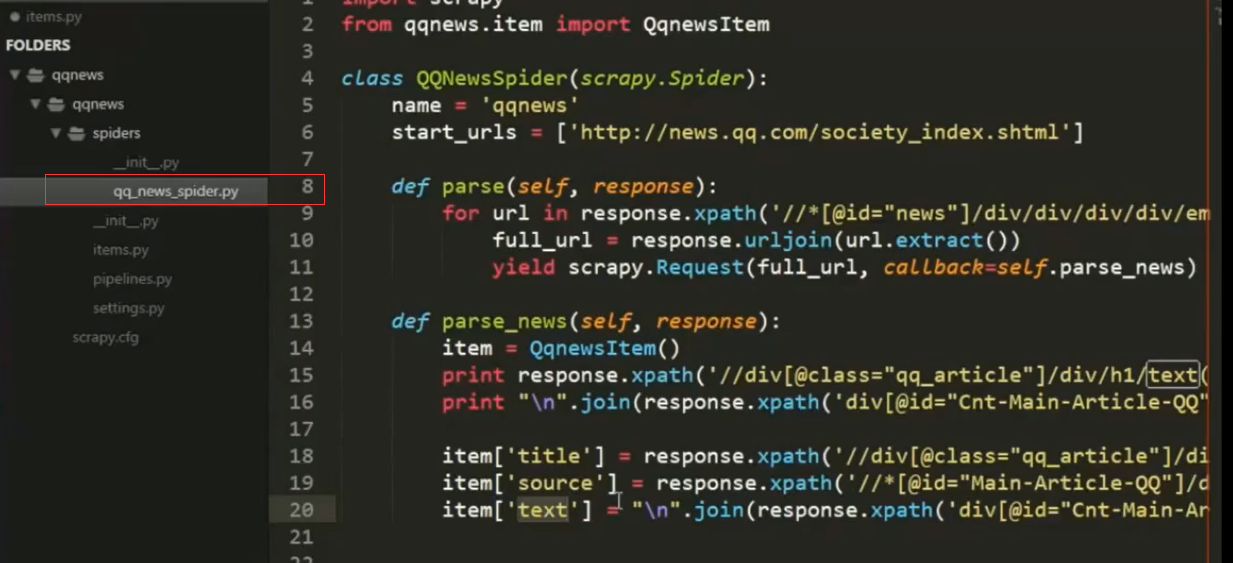
3。pipline去清洗,验证,存入数据库,过滤等等 后续处理
Item Pipeline常用场景
清理HTML数据
验证被抓取的数据(检查item是否包含某些字段)
重复性检查(然后丢弃)
将抓取的数据存储到数据库中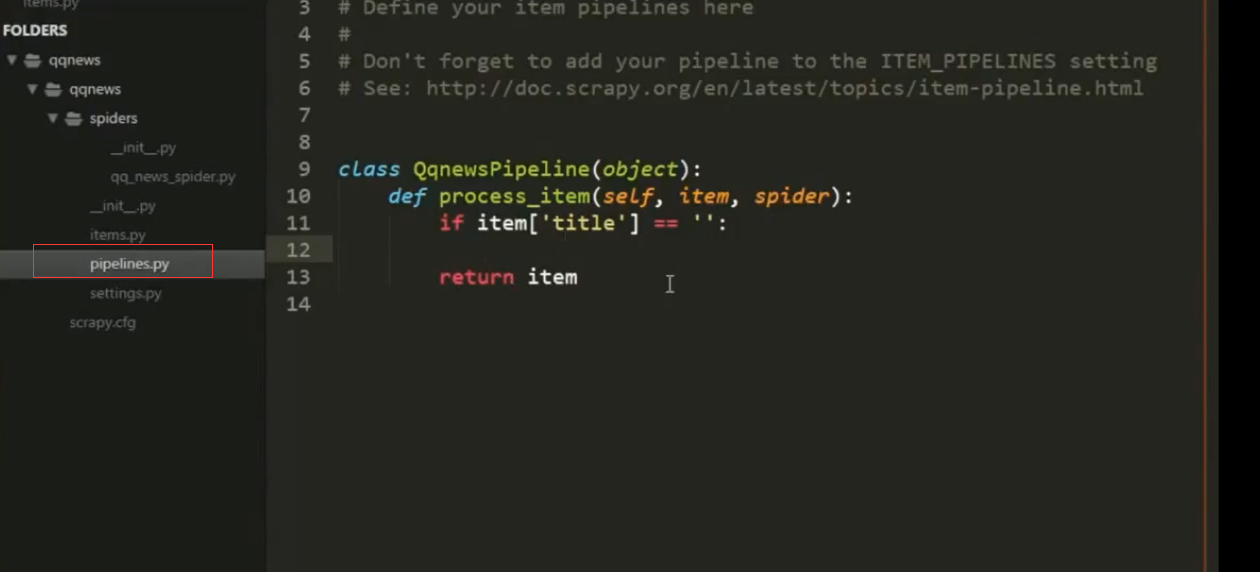
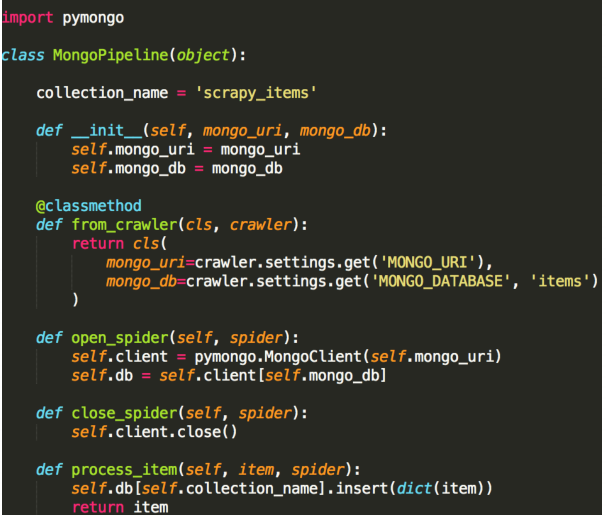
4.Scrapy组件Item Pipeline
经常会实现以下的方法:
open_spider(self, spider) 蜘蛛打开的时执行
close_spider(self, spider) 蜘蛛关闭时执行
from_crawler(cls, crawler) 可访问核心组件比如配置和
信号,并注册钩子函数到Scrapy中
pipeline真正处理逻辑
定义一个Python类,实现方法process_item(self, item,
spider)即可,返回一个字典或Item,或者抛出DropItem
异常丢弃这个Item。
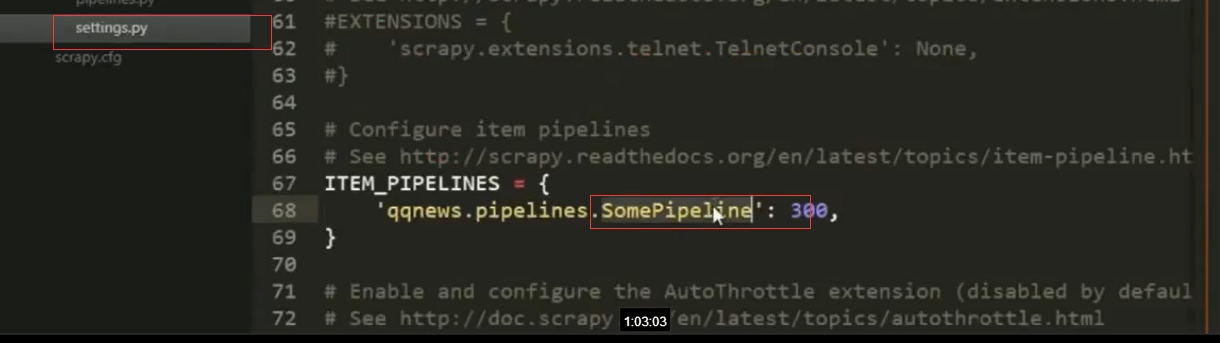
5.settings中定义哪种类型的pipeline
持续更新中。。。。,欢迎大家关注我的公众号LHWorld.
Python爬虫知识点四--scrapy框架的更多相关文章
- Python爬虫进阶之Scrapy框架安装配置
Python爬虫进阶之Scrapy框架安装配置 初级的爬虫我们利用urllib和urllib2库以及正则表达式就可以完成了,不过还有更加强大的工具,爬虫框架Scrapy,这安装过程也是煞费苦心哪,在此 ...
- python爬虫入门(六) Scrapy框架之原理介绍
Scrapy框架 Scrapy简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬 ...
- 零基础写python爬虫之使用Scrapy框架编写爬虫
网络爬虫,是在网上进行数据抓取的程序,使用它能够抓取特定网页的HTML数据.虽然我们利用一些库开发一个爬虫程序,但是使用框架可以大大提高效率,缩短开发时间.Scrapy是一个使用Python编写的,轻 ...
- python爬虫学习之Scrapy框架的工作原理
一.Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. 其最初是为了 页面抓取 (更确切来说, 网 ...
- PYTHON 爬虫笔记十一:Scrapy框架的基本使用
Scrapy框架详解及其基本使用 scrapy框架原理 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了 ...
- python 爬虫相关含Scrapy框架
1.从酷狗网站爬取 新歌首发的新歌名字.播放时长.链接等 from bs4 import BeautifulSoup as BS import requests import re import js ...
- 芝麻HTTP:Python爬虫进阶之Scrapy框架安装配置
初级的爬虫我们利用urllib和urllib2库以及正则表达式就可以完成了,不过还有更加强大的工具,爬虫框架Scrapy,这安装过程也是煞费苦心哪,在此整理如下. Windows 平台: 我的系统是 ...
- 【Python爬虫实战】Scrapy框架的安装 搬运工亲测有效
windows下亲测有效 http://blog.csdn.net/liuweiyuxiang/article/details/68929999这个我们只是正确操作步骤详解的搬运工
- 第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息 crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多 ...
随机推荐
- 读阮一峰老师 es6 入门笔记 —— 第一章
鉴于最近用 vuejs 框架开发项目,其中有很多涉及到 es6 语法不太理解所以便认真地读了一下这本书. 地址:http://es6.ruanyifeng.com/#README 第一章:let ,c ...
- 【NOIP模拟】jzoj5233概率博弈(树规)
Description 小A和小B在玩游戏.这个游戏是这样的: 有一棵
- 【ASP.NET MVC 学习笔记】- 07 使用 Entity Framework
本文参考:http://www.cnblogs.com/willick/p/3304534.html 1.ORM(Object Relation Mapping)工具,是为了解决“关系数据库”和“面向 ...
- Android+ESP8266+路由器实现远程控制(基于花生壳域名方式访问)
x先说一下实现的功能,其实就是远程控制 和这篇文章的控制 http://www.cnblogs.com/yangfengwu/p/5295632.html 应该说是这篇文章的升级,解决这篇文章由 ...
- 树莓派.GPRS.短信接收器
起因 曾经用过西门子出的短信猫, 好处是直接有SDK开发包, 不会硬件开发也能直接使用 缺点也是明显的, 就是只支持Windows系统, 另外就是在Windows下工作很不稳定, 隔开几天就会出现收不 ...
- 无需安装SqlServer打开并管理SqlServer数据库的方法
本地安装的数据库是SqlServer2008R2的 在附加一个数据库文件时出现了以下错误 错误的原因就是附加的数据库版本太高,而本地数据库版本太低导致的 通过各种方式才查询到附加的数据库版本是SqlS ...
- SSM框架+slf4j 以Gradle实现
环境:win10+jdk8+tomcat9+Intellij IDEA 首先,作为一个喜欢偷懒的人,管理jar之类的的事情太累,所以用了Gradle项目管理器 第一步: 新建一个gradle-web项 ...
- Linux系列教程(七)——Linux帮助和用户管理命令
上篇博客我们介绍了Linux文件搜索命令,其中find是用的最多的也是功能最强大的文件或目录搜索命令,和另一个搜索命令locate的区别是,find命令是全盘搜索,刚创建的文件也能搜索的到,而loca ...
- php 不能取得session值的一个解决方法
1.确认下<?php session_start(); ?> 这句话是不是在<HTML> 标志之前. 不在的话,请放到<HTML> 标志之前. 2.如果上面操作后 ...
- cmd 编译java WebService
格式:wsimport -s "src目录" -p "生成类所在包名" -keep "wsdl发布地址" 示例: wsimport -s G ...