
Python爬虫(学习准备)
编码格式的认识:
- 字符:各种文字和符号的统称
- 字符集:多个字符的集合
- 字符集包括:ASCII字符集,GB2312字符集,GB18030,Unicode字符集等
- 1个字符ASCII编码占1个字节,用Unicode编码占2个字节
- UTF-8是Unicode的实习方式之一,是一种变长的编码方式,可以是1,2,3个字节等
在Python中字符串分为两种类型:
- bytes:二进制,互联网上数据都是以二进制传输
- str:unicode的呈现方式
str与bytes的转换:
encode() #str->bytes
decode() #bytes->str
a = '华南理工大学广州学院'

print(type(a))  #<class 'str'>

b = a.encode()  #参数不填默认utf-8编码

print(b)

print(type(b))  #<class 'bytes'>

a = b.decode('utf-8')

print(a)  #华南理工大学广州学院
cookie和session区别:
- cookie数据存放在客户的浏览器上,session数据放在服务器上。
- cookie不是很安全,别人可以分析存放在本地的cookie并进行cookie欺骗
- session会在一定时间内保存在服务器。当访问增多,会比较占服务器性能
- 单个cookie保存的数据不能超过4k,很多浏览器都限制一个站点最多保存20个cookie
Http和Https:
Http
- 超文本传输协议
- 默认端口号:80
Https
- Http + ssl(安全套接字层)
- 默认端口号:443
Https比http更安全,但是性能更低(耗时更长)
Url的形式:

http请求格式:

http常见请求头:

常见响应状态码:
- 200:成功
- 302:转移至新的url
- 307:转移至新的url
- 404:not found
- 500:服务器内部错误
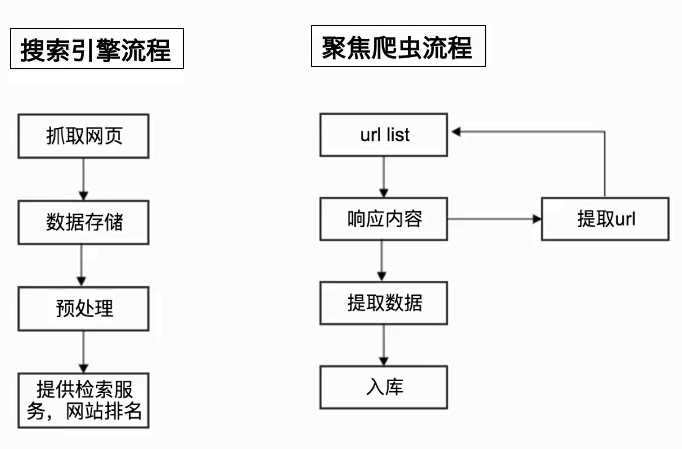
爬虫的分类:
- 通用爬虫:通常指搜索引擎的爬虫
- 聚焦爬虫:针对特定网站的爬虫
通用爬虫与聚焦爬虫的流程:
Robots协议:
网站通过Robots协议告诉搜索引擎哪些页面可以抓取,哪些页面不能抓取
浏览器发送Http请求的过程:
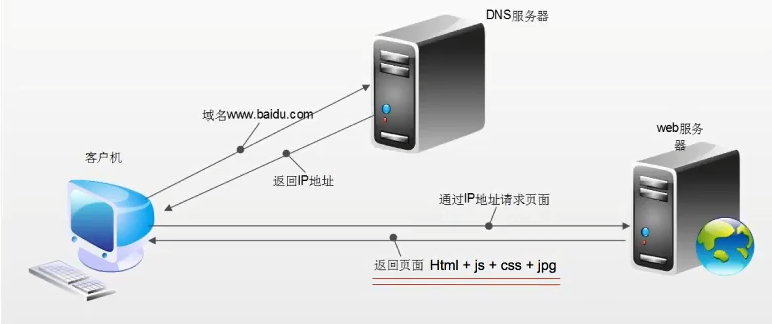
浏览器渲染出来的页面与爬虫请求的页面不一样
Python爬虫(学习准备)的更多相关文章
- Python 爬虫模拟登陆知乎
在之前写过一篇使用python爬虫爬取电影天堂资源的博客,重点是如何解析页面和提高爬虫的效率.由于电影天堂上的资源获取权限是所有人都一样的,所以不需要进行登录验证操作,写完那篇文章后又花了些时间研究了 ...
- python爬虫成长之路(一):抓取证券之星的股票数据
获取数据是数据分析中必不可少的一部分,而网络爬虫是是获取数据的一个重要渠道之一.鉴于此,我拾起了Python这把利器,开启了网络爬虫之路. 本篇使用的版本为python3.5,意在抓取证券之星上当天所 ...
- python爬虫学习(7) —— 爬取你的AC代码
上一篇文章中,我们介绍了python爬虫利器--requests,并且拿HDU做了小测试. 这篇文章,我们来爬取一下自己AC的代码. 1 确定ac代码对应的页面 如下图所示,我们一般情况可以通过该顺序 ...
- python爬虫学习(6) —— 神器 Requests
Requests 是使用 Apache2 Licensed 许可证的 HTTP 库.用 Python 编写,真正的为人类着想. Python 标准库中的 urllib2 模块提供了你所需要的大多数 H ...
- 批量下载小说网站上的小说(python爬虫)
随便说点什么 因为在学python,所有自然而然的就掉进了爬虫这个坑里,好吧,主要是因为我觉得爬虫比较酷,才入坑的. 想想看,你可以批量自动的采集互联网上海量的资料数据,是多么令人激动啊! 所以我就被 ...
- python 爬虫(二)
python 爬虫 Advanced HTML Parsing 1. 通过属性查找标签:基本上在每一个网站上都有stylesheets,针对于不同的标签会有不同的css类于之向对应在我们看到的标签可能 ...
- Python 爬虫1——爬虫简述
Python除了可以用来开发Python Web之后,其实还可以用来编写一些爬虫小工具,可能还有人不知道什么是爬虫的. 一.爬虫的定义: 爬虫——网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区 ...
- Python爬虫入门一之综述
大家好哈,最近博主在学习Python,学习期间也遇到一些问题,获得了一些经验,在此将自己的学习系统地整理下来,如果大家有兴趣学习爬虫的话,可以将这些文章作为参考,也欢迎大家一共分享学习经验. Pyth ...
- [python]爬虫学习(一)
要学习Python爬虫,我们要学习的共有以下几点(python2): Python基础知识 Python中urllib和urllib2库的用法 Python正则表达式 Python爬虫框架Scrapy ...
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
随机推荐
- spingboot 2.1.3 与 elasticsearch7 兼容问题
pom 加入 elasticsearch7 的依赖, <dependency> <groupId>org.elasticsearch</groupId> < ...
- GO语言编译环境采用gosublime(19新版)
环境:博主已下载好,并安装在E:/SDK,使用过sublime text3,有git 0x00 环境变量 默认已经有GOPATH(代码存放在这),PATH(安装go的bin目录即E:\SDK\bin) ...
- Microsemi Libero系列教程(二)——新建点灯工程
前言 上一篇文章,介绍了Microsemi Libero系列教程(一)-Libero开发环境介绍,下载,安装与注册,作为嵌入式开发中的Hello World,点灯是再也基础不过的实验了,通过点灯实验, ...
- Xshell/Xftp连接Linux速度非常慢(已解决)
原因: 在使用shell连接虚拟机时连接等待时间太长,ssh的服务端在连接时会自动检测dns环境是否一致导致的,修改为不检测即可! 解决方案: 1.打开sshd服务的配置文件/etc/ssh/sshd ...
- Linux(三)
1.用户与用户组 Linux系统是一个多用户.多任务的操作系统,任何一个要使用系统资源的用户,都必须首先向系统管理员(root)申请一个账号,然后以这个账号的身份进入系统. ...
- JavaWeb入门——在Linux环境下安装Tomcat服务器
JavaWeb入门——在Linux环境下安装Tomcat服务器 摘要:本文主要学习了如何在Linux环境下安装Tomcat服务器. 准备工作 检查Java环境变量 检查系统是否配置了Java的环境变量 ...
- DispatchProxy实现动态代理及AOP
DispatchProxy类是DotnetCore下的动态代理的类,源码地址:Github,官方文档:MSDN.主要是Activator以及AssemblyBuilder来实现的(请看源码分析),园子 ...
- golang的缓冲channel简单使用
目录 golang的缓冲channel简单使用 阻塞型 非阻塞 golang的缓冲channel简单使用 我们常用的是无缓冲channel : make(chan type) 其实make() 创建c ...
- 老师傅珍藏多年CAD常用快捷键合集,收藏,工作效率翻倍!
想要熟练操作CAD,做一名出色的CAD绘图员,少不了勤学苦练,还要掌握一些常用的绘图命令以及常用快捷键. 今天就来跟大家分享超全的CAD绘图命令,以及常用快捷键,学会涨工资! 常用快捷键: CTRL快 ...
- pyecharts画图总结
pyecharts 画图归纳 将本地文件导入到Pyecharts: test = open(filename, 'r') data = test.readlines() test.close() 如果 ...