
ubantu14.04安装storm伪分布式
1、安装jdk
安装:sudo apt-get install openjdk-7-jdk
配置:
修改文件 sudo nano /etc/profile , 添加以下内容:
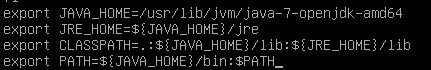
立即执行使之生效:

2、安装依赖库文件


3、安装ZMQ
下载 zeromq-2.1.7.zip ,下载地址 http://download.zeromq.org,如果链接打不开的,则链接:https://pan.baidu.com/s/1VUB_jKNQQOwvqkLhofSBYw 密码:cxp0
进入解压文件夹,依次执行:


4、安装jzmq
由于ZMQ是C/C++ de kuwenjian ,strom 是基于JVM的,无法直接使用。jzmq是JNI封装的ZMQ的Java库,storm需要通过它来使用ZMQ
下载jzmq ,下载地址 https://github.com/nathanmarz/jzmq/archive/master.zip
进入解压后的文件夹,依次执行:


执行make命令会出错,做下面操作后再执行:
①、手动创建classdist_noinst.stamp空文件

②、进入以下文件夹,执行如下操作:

退回文件夹,继续执行:


5、启动Zookeeper
下载zookeeper-3.4.5.tar.gz,地址http://archive.apache.org/dist/zookeeper/zookeeper-3.4.6/
解压,进入解压后的文件夹中,将文件 ./conf/zoo_sample.cfg 重命名为 ./conf/zoo.cfg

配置环境变量 zookeeper,nano /etc/progile

编辑zoo.cfg文件

添加以下内容

执行以下命令启动Zookeeper

查看运行成功没:

6、配置Storm
下载地址 https://www.storm-project.net/downloads.html
配置storm环境变量:nano /etc/profile

source /etc/profile立即执行
配置storm.yaml(注意每个冒号后面两个空格)


8、启动storm
storm nimbus &
storm supervisor &
storm ui &
浏览器输入: 127.0.0.1:8080

恭喜你,安装成功
ubantu14.04安装storm伪分布式的更多相关文章
- java大数据最全课程学习笔记(1)--Hadoop简介和安装及伪分布式
Hadoop简介和安装及伪分布式 大数据概念 大数据概论 大数据(Big Data): 指无法在一定时间范围内用常规软件工具进行捕捉,管理和处理的数据集合,是需要新处理模式才能具有更强的决策力,洞察发 ...
- Caffe2(1)----Ubantu14.04安装
英文好的请直接参考官方安装文档:Ubantu14.04下的源码编译. Caffe2的安装相比以前Caffe一代的安装,简直有点一键装机的感觉,下面简单总结下Caffe2的安装. 环境:Ubantu14 ...
- VMwareWorkstation 平台 Ubuntu14 下安装配置 伪分布式 hadoop
VMwareWorkstation平台Ubuntu14下安装配置伪分布式hadoop 安装VmwareStation 内含注册机. 链接:https://pan.baidu.com/s/1j-vKgD ...
- ubantu18.04下Hadoop安装与伪分布式配置
1 下载 下载地址:http://mirror.bit.edu.cn/apache/hadoop/common/stable2/ 2 解压 将文件解压到 /usr/local/hadoop cd ~ ...
- centos中-hadoop单机安装及伪分布式运行实例
创建用户并加入授权 1,创建hadoop用户 sudo useradd -m hadoop -s /bin/bash 2,修改sudo的配置文件,位于/etc/sudoers,需要root权限才可以读 ...
- Hadoop安装-单机-伪分布式简单部署配置
最近在搞大数据项目支持所以有时间写下hadoop随笔吧. 环境介绍: Linux: centos7 jdk:java version "1.8.0_181 hadoop:hadoop-3.2 ...
- Ubuntu 安装hadoop 伪分布式
一.安装JDK : http://www.cnblogs.com/E-star/p/4437788.html 二.配置SSH免密码登录1.安装所需软件 sudo apt-get ins ...
- 在mac上安装hadoop伪分布式
换了macbook pro之后,要重新安装hadoop,但是mac上的jdk跟windows上的不同,导致折腾了挺久的,现在分享出来,希望对大家有用. 一:下载jdk 选择最新版本下载,地址:http ...
- hadoop 1.2.1 安装步骤 伪分布式
最近在系统的学习hadoop 课程第一步是安装hadoop1.x,具体安装步骤如下: 一.系统安装 本文使用centos6.5安装,具体安装步骤省略 二.jdk安装 下载jdk1.7.0_51解压,在 ...
随机推荐
- Python之装饰器(二)
以前你有没有这样一段经历:很久之前你写过一个函数,现在你突然有了个想法就是你想看看,以前那个函数在你数据集上的运行时间是多少,这时候你可以修改之前代码为它加上计时的功能,但是这样的话是不是还要大体读读 ...
- caffe中batch norm源码阅读
1. batch norm 输入batch norm层的数据为[N, C, H, W], 该层计算得到均值为C个,方差为C个,输出数据为[N, C, H, W]. <1> 形象点说,均值的 ...
- Ubuntu 19.10 发布 | 云原生生态周报 Vol. 24
作者 | 木苏.进超.冬岛.元毅.心水.衷源 业界要闻 1.云原生编程语言 Pulumi 1.0 pulumi ,一款中立的开源云开发平台,Pulumi 支持多语言.混合云环境.完全可扩展.初期支持 ...
- Halcon一日一练:阈值分割的几个算子
threshold(Image:Region:MinGray:MaxGray:) 功能:得到灰度值在最小与最大这间的那些部分.其返回仍然是一个区域. MinGray<MaxGray. 这个算子可 ...
- pycharm中debug的使用
1.未打断点运程序,输出全部结果 2.打断点后,点击debug,代码执行到断点前停止(断点所在行不执行) 3.step over,是在单步执行时,在函数内遇到子函数时不会进入子函数内单步执行,而是将子 ...
- tomcat+Apache介绍
tomcat不是一个完整意义上的Jave EE服务器,它甚至都没有提供对哪怕是一个主要Java EE API的实现:但由于遵守apache开源协议,tomcat却又为众多的java应用程序服务器嵌入自 ...
- 入门了解Service Mesh + Istio?从本文开始
下周六,深圳,阔别已久的线下技术沙龙要和你见面啦! 现场有Rancher Labs研发经理demo刚刚发布的Rancher 2.3中的Istio.Windows容器.集群模板等功能及使用,还有k3s首 ...
- 微信公众号【阿里技术(ali_tech)】历史文章整理
简介 来自微信公众号: ali_tech 阿里巴巴官方技术号,关于阿里的技术创新均呈现于此. 本内容来自微信公众号的分享,最后更新时间2019-10-26,请关注对应公众号接收最新分享,定期同步地址: ...
- PHP5底层原理之垃圾回收机制
概念 垃圾回收机制 是一种内存动态分配的方案,它会自动释放程序不再使用的已分配的内存块. 垃圾回收机制 可以让程序员不必过分关心程序内存分配,从而将更多的精力投入到业务逻辑. 与之相关的一个概念,内存 ...
- 百万年薪python之路 -- MySQL数据库之 存储引擎
MySQL之存储引擎 一. 存储引擎概述 定义: 存储引擎是mysql数据库独有的存储数据.为数据建立索引.更新数据.查询数据等技术的实现方法 首先声明一点: 存储引擎这个概念只有MySQL才有. ...