
爬虫之爬取网贷之家在档P2P平台基本数据并存入数据库
python 版本 :3.5.2
Jupyter Notebook
使用库:
reuqests (For human)
json (用来加载JSON数据)
datetime (用来记录抓取所花时间,也可以忽略)
pymysql (连接数据库,载入所爬取数据 )
1.用chrome浏览器打开网贷之家官网:http://www.wdzj.com 然后使用Chrome工具审查元素,勾选 Preserve log 然后刷新一次页面

2.找到 http://www.wdzj.com/wdzj/html/json/dangan_search.json 也就是说网贷之家将所收集在档的平台以JSON形式数据储放的,这下就很好办了,直接用抓取这个页面就ok
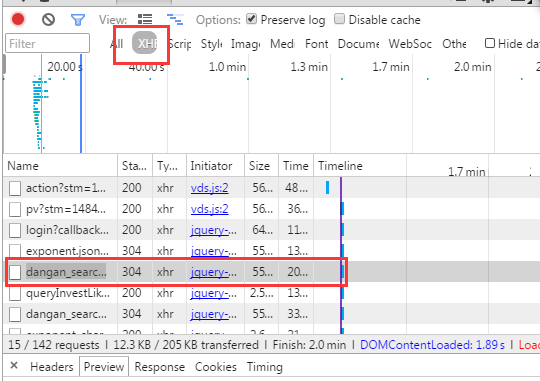
3.上简单粗暴的代码
  1 #coding utf-8

  2 import requests

  3 import json

  4 import datetime

  5 import pymysql

  6 user_agent = 'User-Agent: Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; Maxthon 2.0)' #用来伪装用户身份

  7 headers = {'User-Agent':user_agent}

  8 p2plist_url='http://www.wdzj.com/wdzj/html/json/dangan_search.json' #刚刚找到用来存放平台的JSON数据页面

  9 print ('正在抓取……')

 10 s1=datetime.datetime.now()

 11 r=requests.get(p2plist_url)

 12 content=r.text

 13 content=json.loads(content) #加载JSON数据

 14 s2=datetime.datetime.now()

 15 s3=(s2-s1).total_seconds()

 16 print ('抓取完成^\n共用时%s秒' % round(s3))
查看一下结果
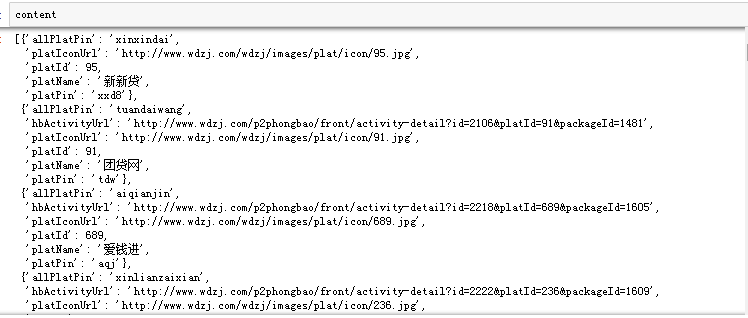
接着连接数据库,把数据丢到数据库里面去(pymsql 库, 需要先下载,打开CMD 然后输入 ’pip install pymysql‘ 下载库)
 con=pymysql.connect(host='127.0.0.1',port=3306,user='root',passwd=None,db='quan') #连接数据库

 cur=con.cursor() #创建游标

 create_table='create table wdzj (id smallint,name varchar(20),pin varchar(20))' #创建一个数据库用来存储数据

 try:

     cur.execute(create_table)

     con.commit()

     print ('创表成功')

 except Exception as e:

         print ('创表失败\n%s ' % e)

         con.rollback

 #插入数据语句

 for x in content:

     sql="insert into wdzj (name,id,pin) values ('%s','%d','%s') " % (x['platName'],x['platId'],x['platPin'])

     try:

         cur.execute(sql)

         con.commit()

         print ('插入成功  %s %s %s'% (x['platName'],x['platId'],x['platPin']))

     except Exception as e:

         print ('插入错误\n%s ' % e)

         con.rollback

 cur.close() #关闭游标

 con.close() #关闭连接
查看一下结果
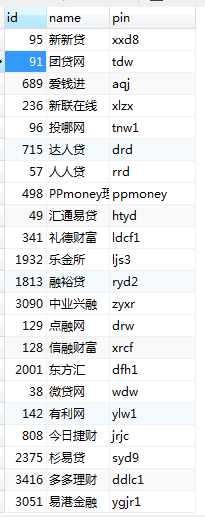
进行查询:条件为查询存储到数据库中,平台名称为'介贷网'的信息。ps:小小的一波推荐,玩P2P的,这个平台虽然小,但还不错。

完成!
学习过程中所遇到的问题:
1.第一次连接数据库储存数据,花了很长时间去琢磨插入语句,因为操作及逻辑思维固化的原因,刚开始将数据库语言写成cur.execute('*******'),但因为基础不扎实,硬是写不好,后来想到了,不如先写好数据库语句,将它作为一个对象写进执行数据库语句的cur.execute('*******')里面去。
2.遇到了'latin-1' codec can't encode characters in position 40-42: ordinal not in range(256) 的问题,查了一下百度,虽然得到了很几种解决方案,还记得最简单粗暴的就是:encode('utf-8')一下,然后decode('latin-1')一下,简直太粗暴,我也尝试做了一下,发现插进入的数据全特么是乱码,摒弃。后来找到了,原来是数据库的编码设置问题,后来在连接数据库的时候加上了 charset="utf8" 完美解决
3.记得con.commit()否则,执行的插入语句是没有用的,因为没有提交到数据库 ,它的伙伴con.rollback() 是用来回滚的。打个比方,屌丝去追女神(数据库),送花(操作,增删改),别人妹子接受了你的花,那么就(con.commit()),不接受,那么你就滚吧(con.rollback()),
还有cur.close() 和con.close(),养成良好的习惯,操作完成后记得关闭连接
总结:
神马?函数封装都木有?哈哈,简单粗暴,够用,但是不灵活,之后会进行改进,一步一步前进~
QQ:1749061919 小白爬虫求带
爬虫之爬取网贷之家在档P2P平台基本数据并存入数据库的更多相关文章
- 爬取网贷之家平台数据保存到mysql数据库
# coding utf-8 import requests import json import datetime import pymysql user_agent = 'User-Agent: ...
- python学习之爬虫(一) ——————爬取网易云歌词
接触python也有一段时间了,一提到python,可能大部分pythoner都会想到爬虫,没错,今天我们的话题就是爬虫!作为一个小学生,关于爬虫其实本人也只是略懂,怀着"Done is b ...
- python3爬虫应用--爬取网易云音乐(两种办法)
一.需求 好久没有碰爬虫了,竟不知道从何入手.偶然看到一篇知乎的评论(https://www.zhihu.com/question/20799742/answer/99491808),一时兴起就也照葫 ...
- python 爬取乌云所有厂商名字,url,漏洞总数 并存入数据库
需要:MySQLdb 下面是数据表结构: /* Navicat MySQL Data Transfer Source Server : 127.0.0.1 Source Server Version ...
- 网络爬虫之定向爬虫:爬取当当网2015年图书销售排行榜信息(Crawler)
做了个爬虫,爬取当当网--2015年图书销售排行榜 TOP500 爬取的基本思想是:通过浏览网页,列出你所想要获取的信息,然后通过浏览网页的源码和检查(这里用的是chrome)来获相关信息的节点,最后 ...
- python 爬虫之爬取大街网(思路)
由于需要,本人需要对大街网招聘信息进行分析,故写了个爬虫进行爬取.这里我将记录一下,本人爬取大街网的思路. 附:爬取得数据仅供自己分析所用,并未用作其它用途. 附:本篇适合有一定 爬虫基础 crawl ...
- Python爬虫之爬取慕课网课程评分
BS是什么? BeautifulSoup是一个基于标签的文本解析工具.可以根据标签提取想要的内容,很适合处理html和xml这类语言文本.如果你希望了解更多关于BS的介绍和用法,请看Beautiful ...
- 如何用Python网络爬虫爬取网易云音乐歌曲
今天小编带大家一起来利用Python爬取网易云音乐,分分钟将网站上的音乐down到本地. 跟着小编运行过代码的筒子们将网易云歌词抓取下来已经不再话下了,在抓取歌词的时候在函数中传入了歌手ID和歌曲名两 ...
- python网络爬虫&&爬取网易云音乐
#爬取网易云音乐 url="https://music.163.com/discover/toplist" #歌单连接地址 url2 = 'http://music.163.com ...
随机推荐
- 【转】程序员必须知道的几个Git代码托管平台
一.VS2013中克隆远程Git仓库和SSH的配置 1.VS2013中克隆远程项目 首先感谢园友的评论和补充,今日又仔细看了一下,VS2013中是可以克隆项目的,只是我一直用的GitHub来克隆的 ...
- Nodejs的多线程
转: http://snoopyxdy.blog.163.com/blog/static/60117440201349352443/
- Java 抽象类和接口与多态
引入抽象类和接口的原因 即"针对接口编程",关键就在多态,即向上转型 当变量的的声明类型是超类型时,即抽象类或者接口,这样,只要是具体实现此超类型的类所产生的对象,都可以指定给这个 ...
- 谈谈MySQL数据表的类型(转)
谈谈MySQL数据表的类型 通常意义上,数据库也就是数据的集合,具体到计算机上数据库可以是存储器上一些文件的集合或者一些内存数据的集合. 我们通常说的MySql数据库,sql server数据库等等其 ...
- JDBC executeBatch 抛出异常停止
进行批量更新的时候发现: addBatch(sql); executeBatch 抛出异常后,剩余的sql没有更新,即出现异常之前的都入库了,异常之后即使有可执行sql都不会执行. 百度资料后了解:这 ...
- UVa 11456 - Trainsorting
题目大意:给一个车辆到达车站的序列(按时间先后),可以对车辆进行以下处理:插在队首.插在队尾或者拒绝进站.车站内的车辆必须按照重量大小从大到小排列,问车站内最多能有多少辆车辆? 假设车i是第一个进站, ...
- Java IO面试
1. 讲讲IO里面的常见类,字节流.字符流.接口.实现类.方法阻塞. 字节流和字符流的区别: 1)字节流处理单元为1个字节,操作字节和字节数组,而字符流处理的单元为2个字节的Unicode字符,分别操 ...
- Mysql中主从复制的原理、配置过程以及实际案例
Mysql中主从复制的原理.配置过程以及实际案例1.什么是主从复制?原理:主从分离,什么意思呢?我们不妨画个图看看.如图1所示: 2.准备工作:预备两台服务器,我这里使用虚拟机安装了两个Centos6 ...
- Java 之 web.xml(Java之负基础实战)
多个web.xml会同时生效,先加载tomcat下的web.xml,再加载网站目录下的web.xml. 1.tomcat自带的web.xml 在tomcat的conf目录下 2.自定义web.xml ...
- 浅谈Log4j
1 什么是Log4j Log4j 是Apache为Java提供的日志管理工具.为了你快速理解Log4j的作用,我们用下面的代码说明Log4j的作用.我们为了调试程序,总是需要在程序使用System.o ...