
HBase总结 LSM理解
转载的文章,觉得写的比较好
讲LSM树之前,需要提下三种基本的存储引擎,这样才能清楚LSM树的由来:
- 哈希存储引擎 是哈希表的持久化实现,支持增、删、改以及随机读取操作,但不支持顺序扫描,对应的存储系统为key-value存储系统。对于key-value的插入以及查询,哈希表的复杂度都是O(1),明显比树的操作O(n)快,如果不需要有序的遍历数据,哈希表就是your Mr.Right
- B树存储引擎是B树(关于B树的由来,数据结构以及应用场景可以看之前一篇博文)的持久化实现,不仅支持单条记录的增、删、读、改操作,还支持顺序扫描(B+树的叶子节点之间的指针),对应的存储系统就是关系数据库(Mysql等)。
- LSM树(Log-Structured Merge Tree)存储引擎和B树存储引擎一样,同样支持增、删、读、改、顺序扫描操作。而且通过批量存储技术规避磁盘随机写入问题。当然凡事有利有弊,LSM树和B+树相比,LSM树牺牲了部分读性能,用来大幅提高写性能。
通过以上的分析,应该知道LSM树的由来了,LSM树的设计思想非常朴素:将对数据的修改增量保持在内存中,达到指定的大小限制后将这些修改操作批量写入磁盘,不过读取的时候稍微麻烦,需要合并磁盘中历史数据和内存中最近修改操作,所以写入性能大大提升,读取时可能需要先看是否命中内存,否则需要访问较多的磁盘文件。极端的说,基于LSM树实现的HBase的写性能比Mysql高了一个数量级,读性能低了一个数量级。
LSM树原理把一棵大树拆分成N棵小树,它首先写入内存中,随着小树越来越大,内存中的小树会flush到磁盘中,磁盘中的树定期可以做merge操作,合并成一棵大树,以优化读性能
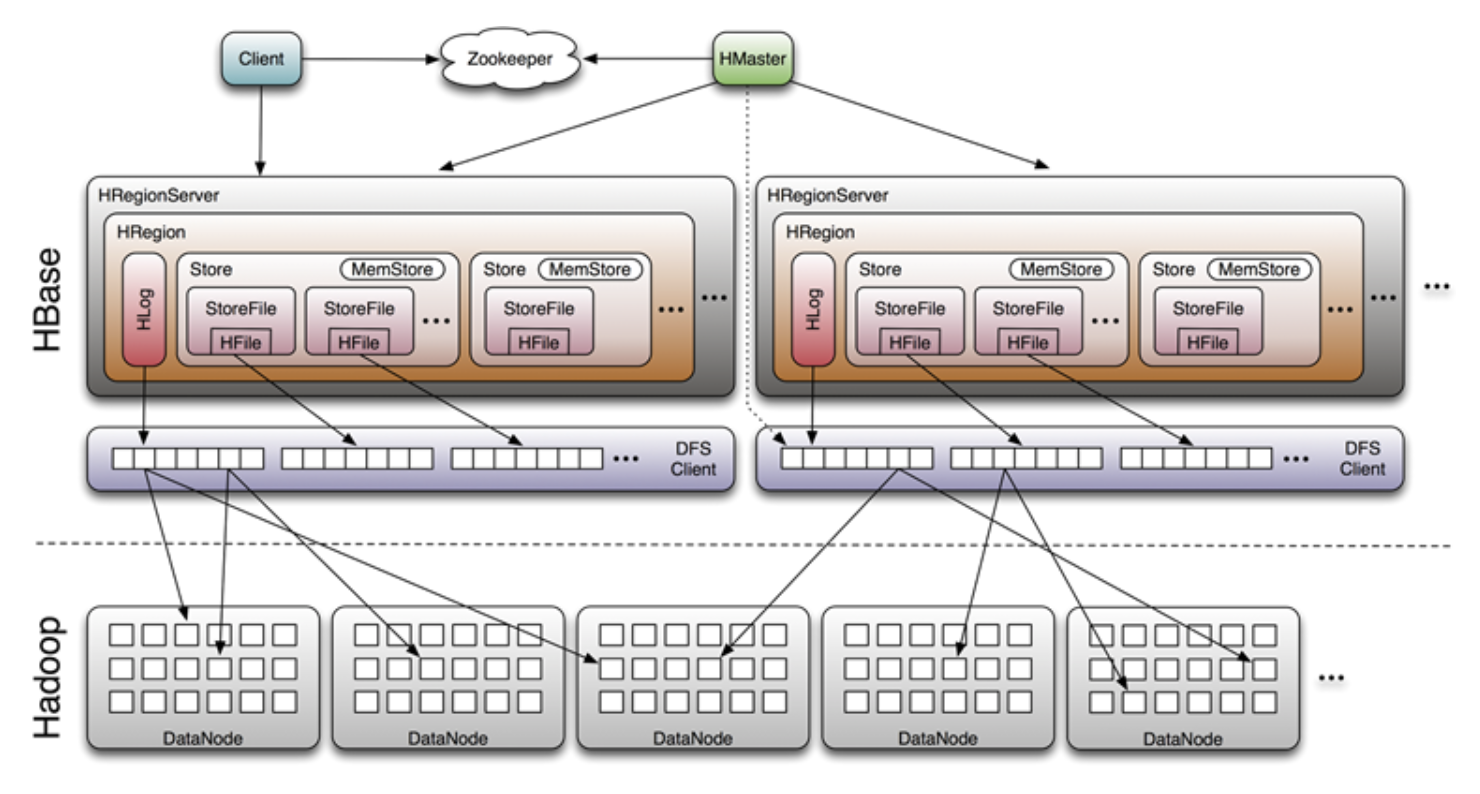
以上这些大概就是HBase存储的设计主要思想,这里分别对应说明下:
- 因为小树先写到内存中,为了防止内存数据丢失,写内存的同时需要暂时持久化到磁盘,对应了HBase的MemStore和HLog
- MemStore上的树达到一定大小之后,需要flush到HRegion磁盘中(一般是Hadoop DataNode),这样MemStore就变成了DataNode上的磁盘文件StoreFile,定期HRegionServer对DataNode的数据做merge操作,彻底删除无效空间,多棵小树在这个时机合并成大树,来增强读性能。
关于LSM Tree,对于最简单的二层LSM Tree而言,内存中的数据和磁盘你中的数据merge操作,如下图
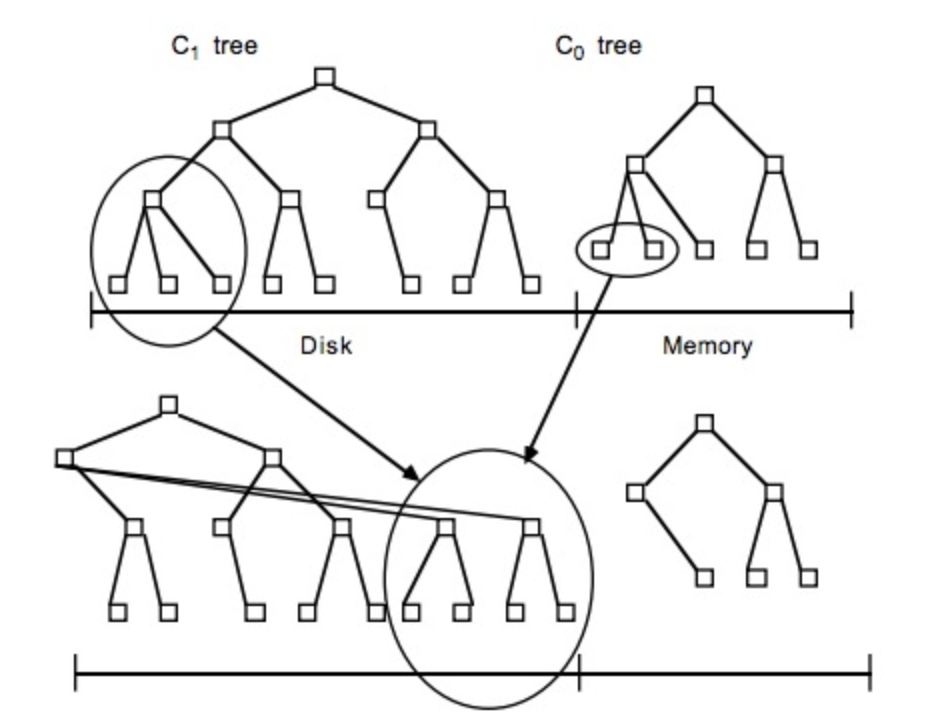
lsm tree,理论上,可以是内存中树的一部分和磁盘中第一层树做merge,对于磁盘中的树直接做update操作有可能会破坏物理block的连续性,但是实际应用中,一般lsm有多层,当磁盘中的小树合并成一个大树的时候,可以重新排好顺序,使得block连续,优化读性能。
hbase在实现中,是把整个内存在一定阈值后,flush到disk中,形成一个file,这个file的存储也就是一个小的B+树,因为hbase一般是部署在hdfs上,hdfs不支持对文件的update操作,所以hbase这么整体内存flush,而不是和磁盘中的小树merge update,这个设计也就能讲通了。内存flush到磁盘上的小树,定期也会合并成一个大树。整体上hbase就是用了lsm tree的思路。
HBase总结 LSM理解的更多相关文章
- sstable, bigtable,leveldb,cassandra,hbase的lsm基础
先看懂文献1和2 1. 先了解sstable.SSTable: Sorted String Table [2] [10] WiscKey: 类似myisam, key value分离, 根据ssd优 ...
- <HBase><读写><LSM>
Overview HBase中的一个big table,首先会按行划分成一些region(这些region之间是有序的,由startkey保证),每个region分配到不同的节点进行存储.因此,reg ...
- 快速理解 Phoenix : SQL on HBASE
转自:http://blog.csdn.net/colorant/article/details/8645081 ==是什么 == 目标Scope EasyStandard SQL access on ...
- hbase概念
1. 概述(扯淡~) HBase是一帮家伙看了Google发布的一片名为“BigTable”的论文以后,犹如醍醐灌顶,进而“山寨”出来的一套系统. 由此可见: 1. 几乎所有的HBase中的理念,都可 ...
- HBase概念及表格设计
HBase概念及表格设计 1. 概述(扯淡~) HBase是一帮家伙看了Google发布的一片名为“BigTable”的论文以后,犹如醍醐灌顶,进而“山寨”出来的一套系统. 由此可见: 1. 几乎所有 ...
- HBase写请求分析
HBase作为分布式NoSQL数据库系统,不单支持宽列表.而且对于随机读写来说也具有较高的性能.在高性能的随机读写事务的同一时候.HBase也能保持事务的一致性. 眼下HBase仅仅支持行级别的事务一 ...
- [Spark] 04 - HBase
BHase基本知识 基本概念 自我介绍 HBase是一个分布式的.面向列的开源数据库,该技术来源于 Fay Chang 所撰写的Google论文“Bigtable:一个结构化数据的分布式存储系统”. ...
- 【转帖】LSM树 和 TSM存储引擎 简介
LSM树 和 TSM存储引擎 简介 2019-03-08 11:45:23 长烟慢慢 阅读数 461 收藏 更多 分类专栏: 时序数据库 版权声明:本文为博主原创文章,遵循CC 4.0 BY-S ...
- HBase原理 – 分布式系统中snapshot是怎么玩的?(转载)
snapshot(快照)基础原理 snapshot是很多存储系统和数据库系统都支持的功能.一个snapshot是一个全部文件系统.或者某个目录在某一时刻的镜像.实现数据文件镜像最简单粗暴的方式是加锁拷 ...
随机推荐
- Spring Boot程序获取tomcat启动端口
package com.geostar.geostack.git_branch_manager.config; import org.springframework.beans.factory.ann ...
- Linux-负载均衡LVS
LVS负载均衡 负载均衡集群是Load Balance 集群的缩写,翻译成中文就是负载均衡集群.常用的负载均衡开源软件有Nginx.LVS.Haproxy,商业的硬件负载均衡设备有F5.Netscal ...
- python xpath学习
一.选取节点: 二.谓词: 注意:在scrapy中用xpath进行搜索时,如果使用相对路径,要加上.,如,不然搜索的是整个文档.
- Angular6封装http请求
最近抽空学习了一下Angular6,之前主要使用的是vue,所以免不了的也想对Angular6提供的工具进行一些封装,今天主要就跟大家讲一下这个http模块. 之前使用的ajax库是axios,可以设 ...
- Luogu P2057 [SHOI2007]善意的投票
题目链接 \(Click\) \(Here\) 考虑模型转换.变成文理分科二选一带收益模型,就一波带走了. 如果没有见过这个模型的话,这里讲的很详细. #include <bits/stdc++ ...
- css实现文本两端对齐
display:inline-block; text-align:center; text-align-last:justify;
- CentOS Linux安装python3
本文的方法是在CentOS上新装了python3,如果本机安装了python2则保留,因为可能有程序依赖目前的python2环境,比如yum!!!!! 一.安装python3.7 1. 安装依赖环境 ...
- git添加删除远程tag
git tag -a test20190108_1 -m "fix bug" git push origin test20190108_1 git push origin :ref ...
- 更换gcc工具链
title: 更换gcc工具链 date: 2019/1/16 19:27:51 toc: true --- 更换gcc工具链 下载后解压到一个临时目录先看看文件结构 mkdir tmp tar xj ...
- IaaS,PaaS,SaaS 的区别(转)
越来越多的软件,开始采用云服务. 云服务只是一个统称,可以分成三大类. IaaS:基础设施服务,Infrastructure-as-a-service PaaS:平台服务,Platform-as-a- ...