
机器学习基石:02 Learning to Answer Yes/No



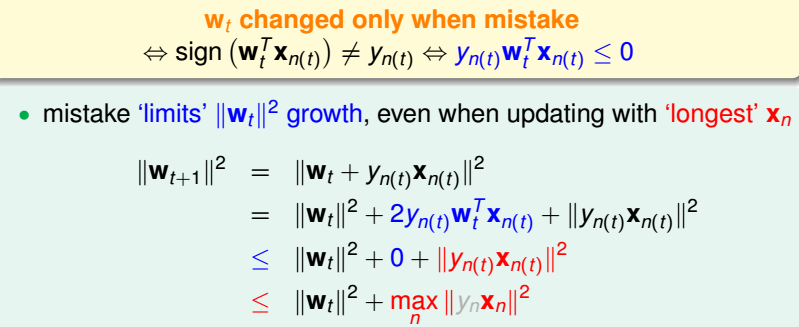
机器学习基石:02 Learning to Answer Yes/No的更多相关文章
- 机器学习基石 2 Learning to Answer Yes/No
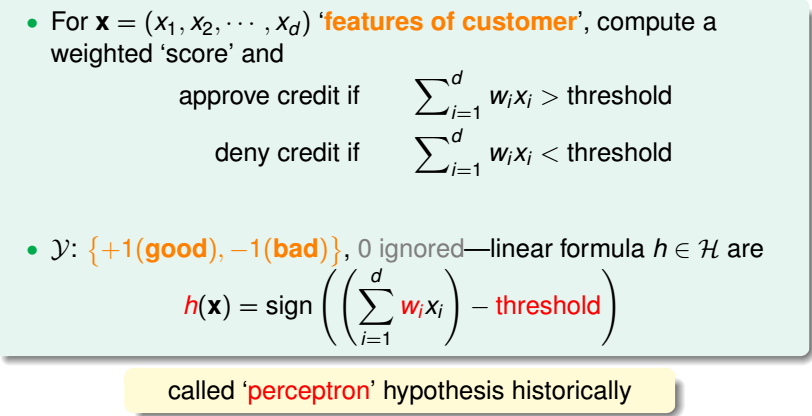
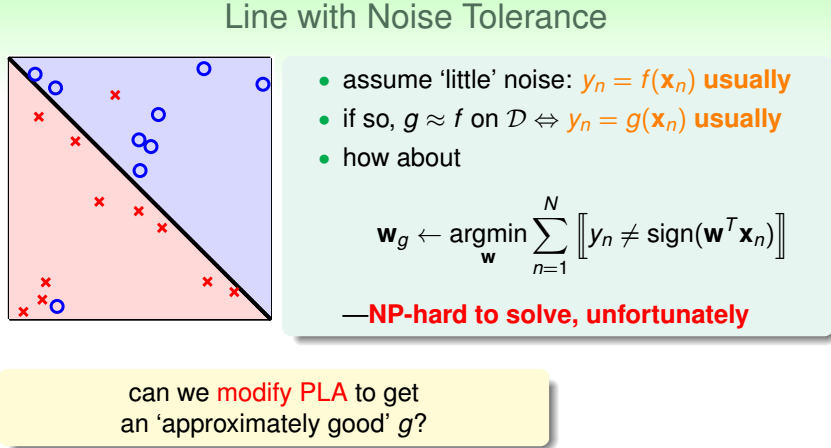
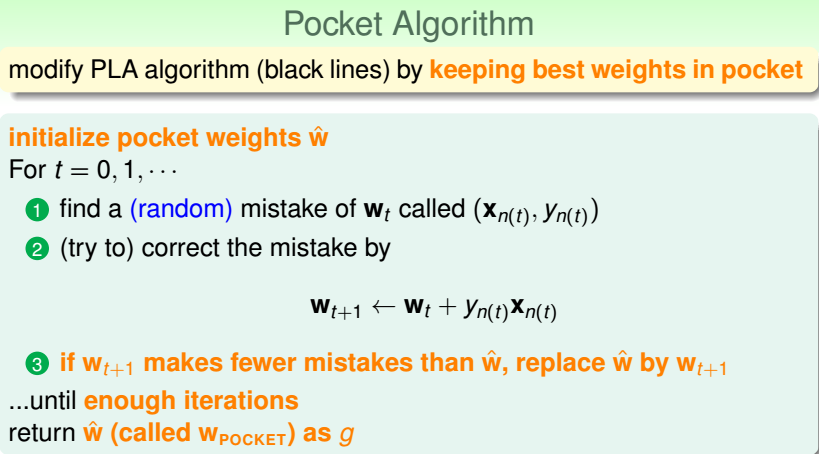
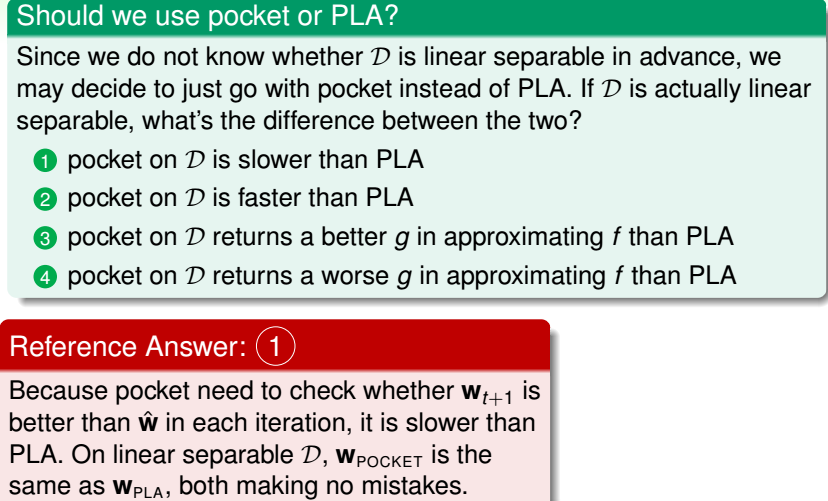
机器学习基石 2 Learning to Answer Yes/No Perceptron Hypothesis Set 对于一个线性可分的二分类问题,我们可以采用感知器 (Perceptron)这种 ...
- 机器学习基石笔记:02 Learning to Answer Yes/No、PLA、PA
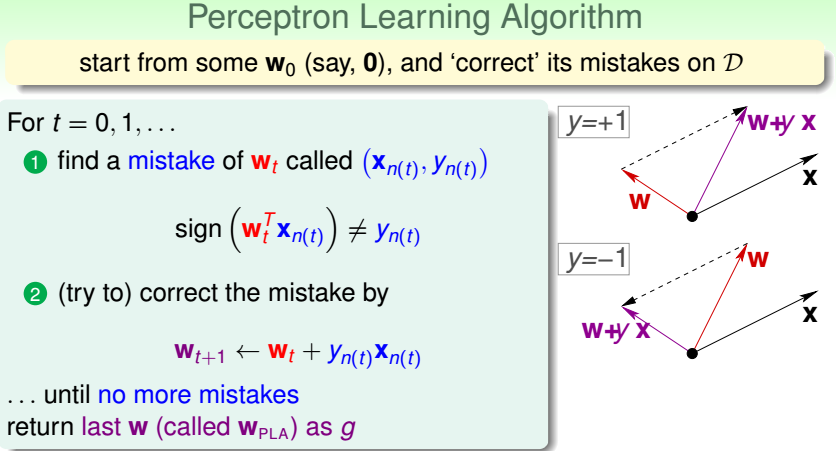
原文地址:https://www.jianshu.com/p/ed0aee74523f 一.Perceptron Learning Algorithm (一)算法原理 PLA本质是二元线性分类算法,即 ...
- 02 Learning to Answer Yes/No
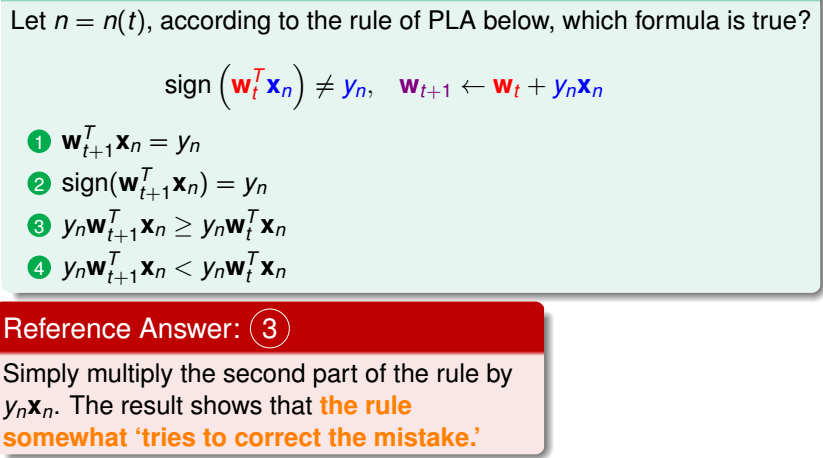
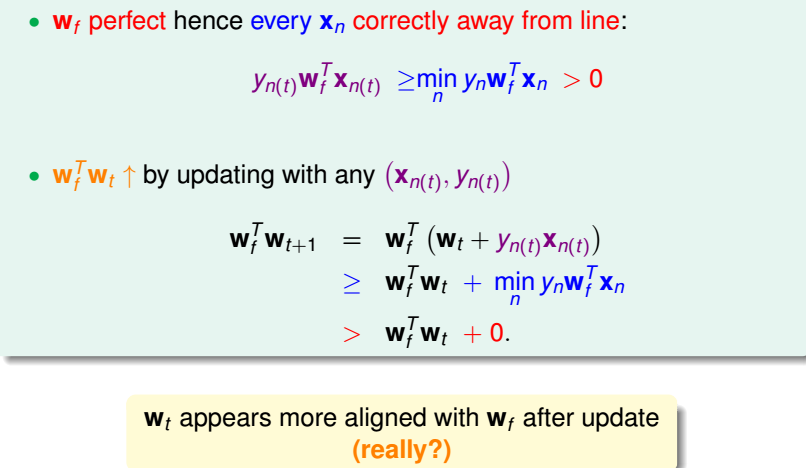
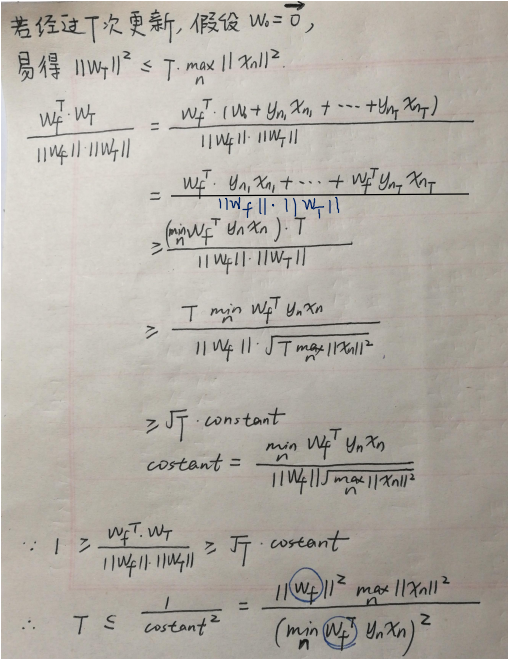
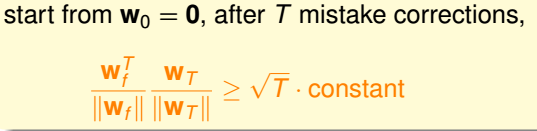
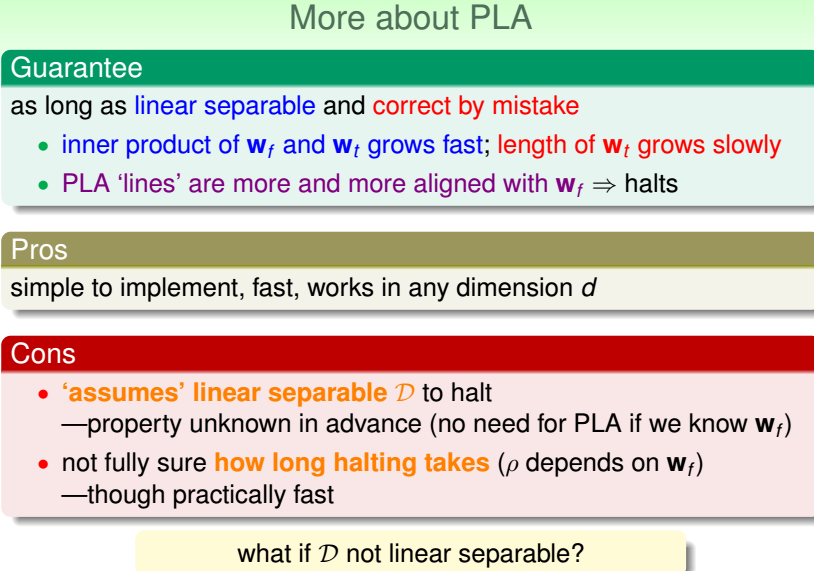
Perceptron Learning Algorithm 感知器算法, 本质是二元线性分类算法,即用一条线/一个面/一个超平面将1,2维/3维/4维及以上数据集根据标签的不同一分为二. 算法确定后, ...
- 机器学习基石 4 Feasibility of Learning
机器学习基石 4 Feasibility of Learning Learning is Impossible? 机器学习:通过现有的训练集 \(D\) 学习,得到预测函数 \(h(x)\) 使得它接 ...
- 机器学习基石 3 Types of Learning
机器学习基石 3 Types of Learning Learning with Different Output Space Learning with Different Data Label L ...
- 机器学习基石 1 The Learning Problem
机器学习基石 1 The Learning Problem Introduction 什么是机器学习 机器学习是计算机通过数据和计算获得一定技巧的过程. 为什么需要机器学习 1 人无法获取数据或者数据 ...
- 機器學習基石(Machine Learning Foundations) 机器学习基石 课后习题链接汇总
大家好,我是Mac Jiang,非常高兴您能在百忙之中阅读我的博客!这个专题我主要讲的是Coursera-台湾大学-機器學習基石(Machine Learning Foundations)的课后习题解 ...
- 机器学习基石(台湾大学 林轩田),Lecture 1: The Learning Problem
课程的讲授从logo出发,logo由四个图案拼接而成,两个大的和两个小的.比较小的两个下一次课程就可能会解释到它们的意思,两个大的可能到课程后期才会解释到它们的意思(提示:红色代表使用机器学习危险,蓝 ...
- 机器学习基石第三讲:types of learning
博客已经迁移至Marcovaldo's blog (http://marcovaldong.github.io/) 刚刚完毕机器学习基石的第三讲.这一讲主要介绍了机器学习的分类.对何种问题应该使用何种 ...
随机推荐
- QQ数据库管理
1,数据库关系图 ##用例1:查询数据 #01.查询QQ号码为54789625的所有好友信息,包括QQ号码,昵称,年龄 select RelationQQID as QQ号码,NickName as ...
- Python基本数据结构--列表
列表: 1.有序的集合: 2.通过偏移来索引,从而读取数据: 3.支持嵌套: 4.可变的类型: 列表的操作: 1.切片: a = [1,2,3,4,5,6,7] 正向索引 反向索引 默认索引 2.添加 ...
- Leetcode 12——Integer to Roman
12.Integer to Roman Given an integer, convert it to a roman numeral. Input is guaranteed to be withi ...
- 利用PCA降维
参考:<机器学习实战>- Machine Learning in Action 一. 基本思想 PCA(Principal Component Analysis),主成分分析.是目前应用 ...
- 《Language Implementation Patterns》之 解释器
前面讲述了如何验证语句,这章讲述如何构建一个解释器来执行语句,解释器有两种,高级解释器直接执行语句源码或AST这样的中间结构,低级解释器执行执行字节码(更接近机器指令的形式). 高级解释器比较适合DS ...
- vivado License导入方法与资源获取
前言 以下安装说明基于已经正确安装vivado 笔者操作环境:linux vivado版本:2015.2 vivado License导入方法: 点击菜单栏[Help],选择[Manage Licen ...
- 201621123031 《Java程序设计》第2周学习总结
Week02-Java基本语法与类库 1. 本周学习总结 本周讲了Java的基本数据类型,主要分为八类(byte,short,int,long,double,float,char,boolean),其 ...
- Flask 部署和分发
到目前为止,启动Flask应用都是通过"app.run()"方法,在开发环境中,这样固然可行,不过到了生产环境上,势必需要采用一个健壮的,功能强大的Web应用服务器来处理各种复杂情 ...
- python之路--day6--字符编码
一.知识储备 cpu--控制和运算 内存--暂时存储cpu需要的数据 硬盘--永久保存数据2.文本编辑器的原理存储原理 1,启动文本编辑器 2,在编辑器上输入内容---此时输入内容还在内存上 3,保存 ...
- 第五章 JavaScript对象及初识面向对象
第五章 JavaScript对象及初识面向对象 一.对象 在JavaScript中,所有事物都是对象,如字符串.数值.数组.函数等. 在JavaScript对象分为内置对象和自定义对象,要处理一些 ...