
MR案例:Reduce-Join
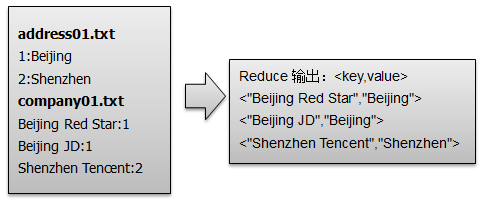
问题描述:两种类型输入文件:address(地址)和company(公司)进行一对多的关联查询,得到地址名(例如:Beijing)与公司名(例如:Beijing JD、Beijing Red Star)的关联信息。可参考MR案例:Map-Join
1.map阶段:对比之前的单表关联可知,reduce阶段的key必须为关联两表的key,即address.Id = company.Id。则两表经过map处理输出的key必须是Id。
Class Map<LongWritable, Text, LongWritable, Text>{

    method map(){

        // 获取文件的每一行数据,并以":"分割

        String[] line = value.toString().split(":");

        //split对应的文件名

        String fileName = ((FileSplit) context.getInputSplit()).getPath().getName();

        //处理company文件的value信息:"Beijing Red Star:1"

        if (path.indexOf("company") >= 0){

            //<key,value> --<"1","company:Beijing Red Star">

            context.write(new LongWritable(line[1]), new Text("company" + ":" + line[0]));

        }

        //处理adress文件的value信息:"1:Beijing"

        else if (path.indexOf("address") >= 0){

            //<key,value> --<"1","address:Beijing">

            context.write(new LongWritable(line[0]), new Text("address" + ":" + line[1]));

        }

    }

}
2.reduce阶段:首先对输入<key, values>即<”1”,[“company:Beijing Red Star”,”company:Beijing JD”,”address:Beijing”]>的values值进行遍历获取到单元信息value(例如”company:Beijing Red Star”),然后根据value中的标识符(company和address)将公司名和地址名分别存入到company集合和address集合,最后对company集合和address集合进行笛卡尔积运算得到company与address的关系,并进行输出。
Class Reducer<LongWritable, Text, Text, Text>{

    method reduce(){

        //用来存储 company 和 address 的集合

        List<String> companys = new ArrayList<String>();

        List<String> addresses = new ArrayList<String>();

        for(Text text : v2s){

            String[] result = text.toString().split(":");

            //以 company 开头的value存储到 company 集合中

            if(result[0].equals("company")){

                companys.add(result[1]);

            }

            //以 address 开头的value存储到 address 集合中

            else if(result[0].equals("address")){

                addresses.add(result[1]);

            }

        }
        /**
         * 如果只判断左表addresses.size()!=0;则转化为 左外连接 --> LEFT OUTER JOIN
         * 如果只判断右表companys.size()!=0;则转化为 右外连接 --> RIGHT OUTER JOIN
         * 左右都不判断,则转化为 全外连接 --> FULL OUTER JOIN
         */

        // 求笛卡尔积

        if(0 != companys.size()&& 0 != addresses.size()){

            for(int i=0;i<companys.size();i++){

                for(int j=0;j<addresses.size();j++){

                    //<key,value>--<"Beijing JD","Beijing">

                    context.write(new Text(companys.get(i)), new Text(addresses.get(j)));

                }

            }

        }

    }

}
MR案例:Reduce-Join的更多相关文章
- Hadoop学习之路(二十一)MapReduce实现Reduce Join(多个文件联合查询)
MapReduce Join 对两份数据data1和data2进行关键词连接是一个很通用的问题,如果数据量比较小,可以在内存中完成连接. 如果数据量比较大,在内存进行连接操会发生OOM.mapredu ...
- MR案例:倒排索引
1.map阶段:将单词和URI组成Key值(如“MapReduce :1.txt”),将词频作为value. 利用MR框架自带的Map端排序,将同一文档的相同单词的词频组成列表,传递给Combine过 ...
- MapReduce编程之Reduce Join多种应用场景与使用
在关系型数据库中 Join 是非常常见的操作,各种优化手段已经到了极致.在海量数据的环境下,不可避免的也会碰到这种类型的需求, 例如在数据分析时需要连接从不同的数据源中获取到数据.不同于传统的单机模式 ...
- MR案例:小文件处理方案
HDFS被设计来存储大文件,而有时候会有大量的小文件生成,造成NameNode资源的浪费,同时也影响MapReduce的处理效率.有哪些方案可以合并这些小文件,或者提高处理小文件的效率呢? 1). 所 ...
- MapReduce之Reduce Join
一 介绍 Reduce Join其主要思想如下: 在map阶段,map函数同时读取两个文件File1和File2,为了区分两种来源的key/value数据对,对每条数据打一个标签(tag), 比如:t ...
- MR案例:CombineFileInputFormat
CombineFileInputFormat是一个抽象类.Hadoop提供了两个实现类CombineTextInputFormat和CombineSequenceFileInputFormat. 此案 ...
- MR案例:倒排索引 && MultipleInputs
本案例采用 MultipleInputs类 实现多路径输入的倒排索引.解读:MR多路径输入 package test0820; import java.io.IOException; import j ...
- MR案例:输出/输入SequenceFile
SequenceFile文件是Hadoop用来存储二进制形式的key-value对而设计的一种平面文件(Flat File).在SequenceFile文件中,每一个key-value对被看做是一条记 ...
- MR案例:外连接代码实现
[外连接]是在[内连接]的基础上稍微修改即可.具体HQL语句详见Hive查询Join package join.map; import java.io.IOException; import java ...
随机推荐
- 160405、quartz持久化所需表结构
delete from qrtz_fired_triggers; delete from qrtz_simple_triggers; delete from qrtz_simprop_trig ...
- SpringCloud--注册中心Eureka
Eureka的服务治理设计中,所有节点即是服务提供方,也是服务消费方. Eureka Server的高可用:就是将自己作为服务向其他服务注册中心注册自己,形成一组互相注册的服务注册中心,实现服务清单的 ...
- 手动编译安装Libvirt之后利用systemctl管理libvirtd服务
因为要给特殊的虚拟机关联文件指定selinux标签,而默认的Libvirt没有这个功能,所以需要修改LIbvirt源代码,重新编译安装Libvirt,而手动编译安装的LIbvirt,没有办法使用sys ...
- K-means聚类算法MATLAB
以K-means算法为例,实现了如下功能 自动生成符合高斯分布的数据,函数名为gaussianSample.m 实现多次随机初始化聚类中心,以找到指定聚类数目的最优聚类.函数名myKmeans.m 自 ...
- springmvc 之 easyUI开发商城管理系统
1.分页 url:controller的路径 pageSize:每页显示的行数 ---后台参数名(rows) 会向后台传递一个 page参数,表示当前页.---后台参数名(page) controll ...
- sql server数据库状态监控
sql server数据库监控 转自:https://www.cnblogs.com/seusoftware/category/500793.html 6. SQL Server数据库监控 - 如 ...
- 2.AS入门教程
AndroidStudio 本文是关于androidStudio的一些基础知识 介绍 Google官方的Android集成开发环境(IDE = Integrated Development Envir ...
- 文字识别的google的库 tesseract
https://github.com/tesseract-ocr/tesseract https://github.com/tesseract-ocr/tessdata 字体识 ...
- IDEA中打包Spark项目提示Error:(16, 48) java: -source 1.5 中不支持 lambda 表达式
在idea中新建了一Spark的项目,在做项目的编译打包的时候,提示如下错误信息: Error:(, ) java: -source 1.5 中不支持 lambda 表达式 (请使用 -source ...
- EXPORT_SYMBOL使用
EXPORT_SYMBOL只出现在2.6内核中,在2.4内核默认的非static 函数和变量都会自动导入到kernel 空间的, 都不用EXPORT_SYMBOL() 做标记的.2.6就必须用EXPO ...