
TF-IDF定义及实现
TF-IDF定义及实现
定义
TF-IDF的英文全称是:Term Frequency - Inverse Document Frequency,中文名称词频-逆文档频率,常用于文本挖掘,资讯检索等应用,在nlp以及推荐等领域都是一个常用的指标,用于衡量字词的重要性。比较直观的解释是,如果一个词本来出现的频率就很高,如the,那么它就几乎无法带给读者一些明确的信息。一般地,以TF-IDF衡量字词重要性时,某个字词在某个文档中出现的频率越高,那么该字词对该文档就有越大的重要性,它可能会是文章的关键词;但若字词在词库中出现的频率越高,那么字词的重要性越低,如the。
计算公式
\]
TF-IDF即是两者相乘,词频乘以逆文档频率。
\]
下标i,j的含义:编号为j的文档中的词语i在该文档中的词频,即所占比例,n为该词语的数量。
\]
N是文档总数,$ N_i $ 表示文档集中包含了词语i的文档数。对分子分母加一是为了避免某些词语未在文档中出现过导致的分母为零的情况。IDF针对某个词计算了它的逆文档频率,即包含该词语的文档比例的倒数(再取对数),若IDF值越小,分母越大,说明这个词语在文档集中比较常见不具有鲜明的信息代表性,TF-IDF的值就小。总之TF-IDF的值我们通常希望它越大越好,大值代表性强。
实现
1. 数据定义预处理
import numpy as np

import pandas as pd

doc1 = "The cat sat on my bed"

doc2 = "The dog sat on my keens"

#构建词库

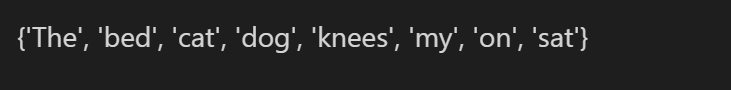
wordSet = set(doc1.split()).union(set(doc2.split()))#union是并集操作

wordSet
2. 统计词频
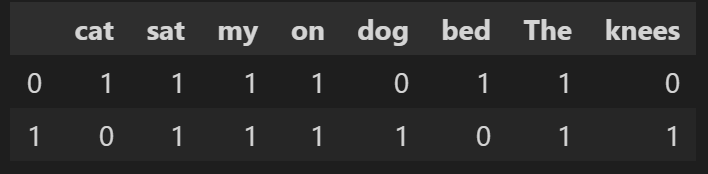
dict1 = dict.fromkeys(wordSet, 0)

dict2 = dict.fromkeys(wordSet, 0)

for word in doc1.split():

    dict1[word]+=1

for word in doc2.split():

    dict2[word]+=1

pd.DataFrame([wordDictA, wordDictB])
3. 计算词频 TF,对单个文档统计
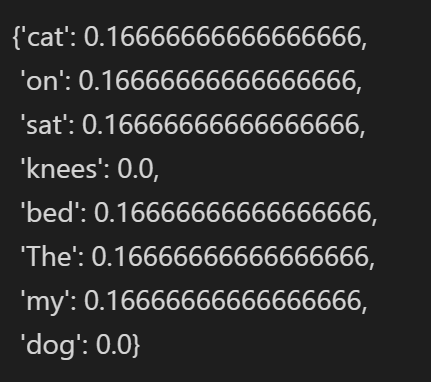
def computeTF(wordDict, doc):

    sumCount = len(doc.split())

    tfDict = dict()

    for word, count in wordDict:

        dict[word] = count / sumCount

	return tfDict

tf1 = computeTF(dict1, doc1)

tf2 = computeTF(dict2, doc2)
4.逆文档频率IDF, 全局只有一份逆文档频率,对所有文档统计
def computeIDF(dicts, wordSet):

	"""传入的是文档的字典集和词库,即全部文档"""

    docNum = len(docs) #文档总数

    #对每个词语查看有几个文档包含它

    IDFDict = dict.fromkeys(wordSet, 0)

    for word in wordSet:

        for _dict in dicts:

            IDFDict[word] += (_dict[word] > 0)#该文档中有这个词就加1

    for word, idf in IDFDict:

        IDFDict[word] = math.log10((docNum + 1) / (IDFDict[word] + 1))

    return IDFDict

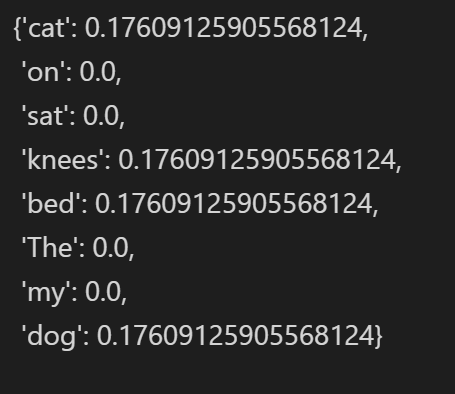
IDF = computeIDF([dict1, dict2], wordSet)

IDF
5.最终计算
def computeTFIDF( tf, idfs ):

    tfidf = {}

    for word, tfval in tf.items():

        tfidf[word] = tfval * idfs[word]

    return tfidf

tfidf1 = computeTFIDF( tf1, idf )

tfidf2 = computeTFIDF( tf2, idf )
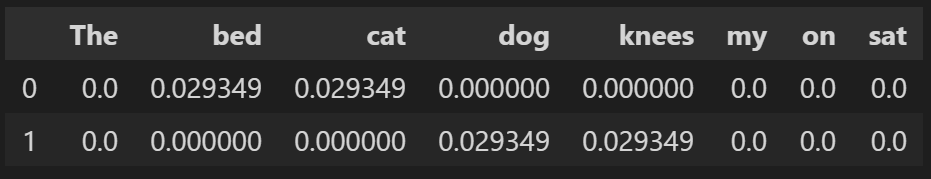
可以看到由于单词The,dog,my,on,set在两个文档中都存在故TF-IDF值为0,而其他单词因为具有一定的分辨能力,所以TF-IDF有一定的数值可以用来分辨两句话。
以上内容参考自视频B站,点击即可前往。
TF-IDF定义及实现的更多相关文章
- tf–idf算法解释及其python代码实现(上)
tf–idf算法解释 tf–idf, 是term frequency–inverse document frequency的缩写,它通常用来衡量一个词对在一个语料库中对它所在的文档有多重要,常用在信息 ...
- tf idf公式及sklearn中TfidfVectorizer
在文本挖掘预处理之向量化与Hash Trick中我们讲到在文本挖掘的预处理中,向量化之后一般都伴随着TF-IDF的处理,那么什么是TF-IDF,为什么一般我们要加这一步预处理呢?这里就对TF-IDF的 ...
- TF/IDF(term frequency/inverse document frequency)
TF/IDF(term frequency/inverse document frequency) 的概念被公认为信息检索中最重要的发明. 一. TF/IDF描述单个term与特定document的相 ...
- 基于TF/IDF的聚类算法原理
一.TF/IDF描述单个term与特定document的相关性TF(Term Frequency): 表示一个term与某个document的相关性. 公式为这个term在document中出 ...
- 使用solr的函数查询,并获取tf*idf值
1. 使用函数df(field,keyword) 和idf(field,keyword). http://118.85.207.11:11100/solr/mobile/select?q={!func ...
- TF/IDF计算方法
FROM:http://blog.csdn.net/pennyliang/article/details/1231028 我们已经谈过了如何自动下载网页.如何建立索引.如何衡量网页的质量(Page R ...
- tf–idf算法解释及其python代码实现(下)
tf–idf算法python代码实现 这是我写的一个tf-idf的简单实现的代码,我们知道tfidf=tf*idf,所以可以分别计算tf和idf值在相乘,首先我们创建一个简单的语料库,作为例子,只有四 ...
- 文本分类学习(三) 特征权重(TF/IDF)和特征提取
上一篇中,主要说的就是词袋模型.回顾一下,在进行文本分类之前,我们需要把待分类文本先用词袋模型进行文本表示.首先是将训练集中的所有单词经过去停用词之后组合成一个词袋,或者叫做字典,实际上一个维度很大的 ...
- 信息检索中的TF/IDF概念与算法的解释
https://blog.csdn.net/class_brick/article/details/79135909 概念 TF-IDF(term frequency–inverse document ...
- Elasticsearch学习之相关度评分TF&IDF
relevance score算法,简单来说,就是计算出,一个索引中的文本,与搜索文本,他们之间的关联匹配程度 Elasticsearch使用的是 term frequency/inverse doc ...
随机推荐
- Tomcat后端无法返回数据
以前使用的是Tomcat8和9,这次使用的10怎么就无法返回数据呢? 一开始以为是因为这个错误:Using CATALINA_OPTS: "" 但是后来发现怎么尝试都无法取出这 ...
- [Leetcode 111]二叉树的最短深度 BFS/DFS
题目 给定二叉树,求最短路径包含的节点个数 https://leetcode.com/problems/minimum-depth-of-binary-tree/ Given a binary tre ...
- create_generated_clock 的用法
本文转载自:create_generated_clock_亓磊的博客-CSDN博客_create_generated_clock 文章目录 参数source和master_clock区别 create ...
- Mybatis二级缓存问题
一.缓存介绍. Mybatis提供了缓存服务,以减缓数据库压力: Mybatis的查询缓存总共有两级,我们称之为一级缓存和二级缓存,如图: 1.一级缓存是SqlSession级别的缓存.在操作数据 ...
- 统信桌面端专业版开启cron日志,确认定时任务执行情况
默认没有开启cron日志记录 1. 修改rsyslog vi /etc/rsyslog.conf #将cron前面的注释符去掉 cron.* /var/log/cron.log 排查完毕需关闭,重新注 ...
- Django Models字段设置为空,界面上还校验必填问题
models.CharField(max_length=1000,null=True,blank=True) 其中blank=True是admin管理后台自动校验放开
- Vue2使用axios,request.js和vue.config.js
1.配置request.js,用来请求数据 import axios from 'axios' // 1:利用axios对象的方法create,创建一个axios实例 // 2:request就是ax ...
- Node.js server使用
一.创建项目 #创建项目目录 cd /data mkdir webroot cd webroot #初始化git git init vim .gitignore 输入: node_modules/ 保 ...
- SAP BADI总结
SAP里标准拼法是BAdI,区分大小写.太麻烦,文章里全用大写. BADI技术的底层是接口,类等面向对象开发的内容. Classic BADI是一个BADI包了一个接口.实现它的话,需要一个接口的实现 ...
- vite不能用@做为路径的解决方法
vite创建vue3后,发现原来用@做为路径的不能用了,报错信息是 Internal server error: Failed to resolve import "@ 在网上查了一下资料, ...