
hive -- 自定义函数和Transform
hive -- 自定义函数和Transform
UDF操作单行数据,
UDAF:聚合函数,接受多行数据,并产生一个输出数据行
UDTF:操作单个数据
使用udf方法:
第一种:
add jar xxx.jar
cteate temporary function 方法名;
注销一个jar方法:drop temporay function 方法名;
第二种:写一个脚本
vi cat hive_init
add jar /home/data/xxx.jar
create temporary fucntion 方法名 as '类的全限定名'
hive -i hive_init
第三种:
自定义UDF注册为hive的内置函数
自定义函数:(UDF)
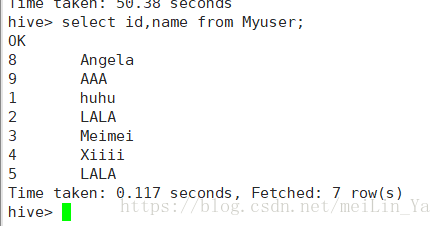
数据:
package UDF;

import java.util.HashMap;

import org.apache.hadoop.hive.ql.exec.UDF;

/**

 *

 * @author huhu_k

 *

 */

public class ToLowerCase extends UDF {

	public static HashMap<String, String> provinceMap = new HashMap<>();

	static {

		provinceMap.put("136", "beijing");

		provinceMap.put("137", "shanghai");

		provinceMap.put("138", "shenzhen");

	}

	// 必须是public

	public String evaluate(String field) {

		String lowerCase = field.toLowerCase();

		return lowerCase;

	}

	// 必须是public

	public String evaluate(int field) {

		String pn = String.valueOf(field);

		return provinceMap.get(pn.substring(0, 3)) == null ? "huoxing" : provinceMap.get(pn.substring(0, 3));

	}

}
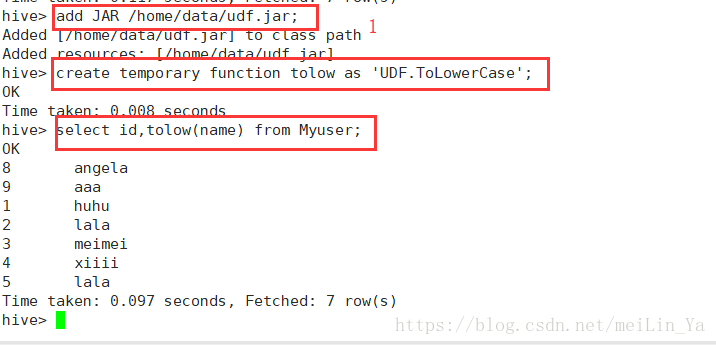
1.将name大写变为小写:
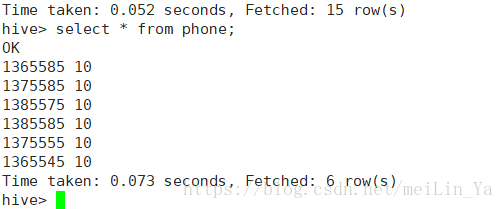
2.数据:
通过手机号获取手机地址:
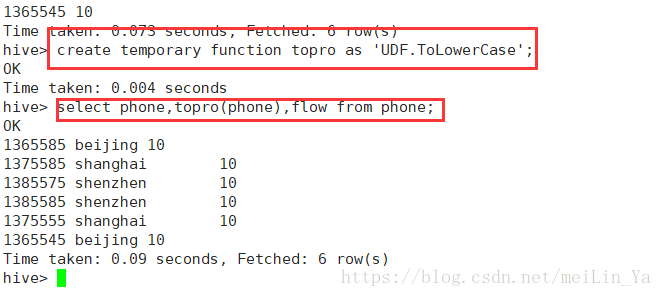
当你在一个类中再次写了方法时,再次导入jar时,要先推出hive,然后在进入hive,然后进行add JAR XXXXX;
3.数据:
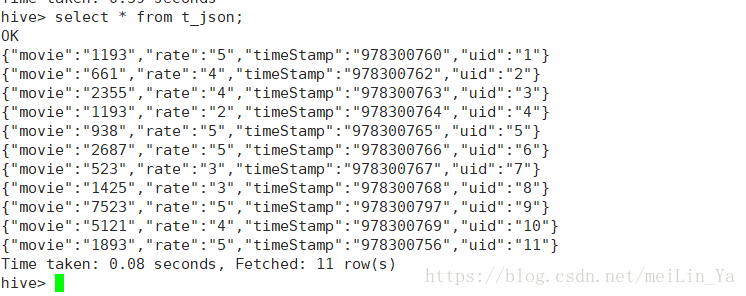
使用json数据
package UDF;

import org.apache.hadoop.hive.ql.exec.UDF;

import org.codehaus.jackson.map.ObjectMapper;

public class JsonParser extends UDF {

	public String evaluate(String json) {

		ObjectMapper objectMapper = new ObjectMapper();

		try {

			Moive readValue = objectMapper.readValue(json, Moive.class);

			return readValue.toString();

		} catch (Exception e) {

			e.printStackTrace();

		}

		return null;

	}

}
package UDF;

public class Moive {

	private String movie;

	private String rate;

	private String timeStamp;

	private String uid;

	public String getMovie() {

		return movie;

	}

	public void setMovie(String movie) {

		this.movie = movie;

	}

	public String getRate() {

		return rate;

	}

	public void setRate(String rate) {

		this.rate = rate;

	}

	public String getTimeStamp() {

		return timeStamp;

	}

	public void setTimeStamp(String timeStamp) {

		this.timeStamp = timeStamp;

	}

	public String getUid() {

		return uid;

	}

	public void setUid(String uid) {

		this.uid = uid;

	}

	@Override

	public String toString() {

		return  movie + "\t" + rate + "\t" + timeStamp + "\t" + uid;

	}

}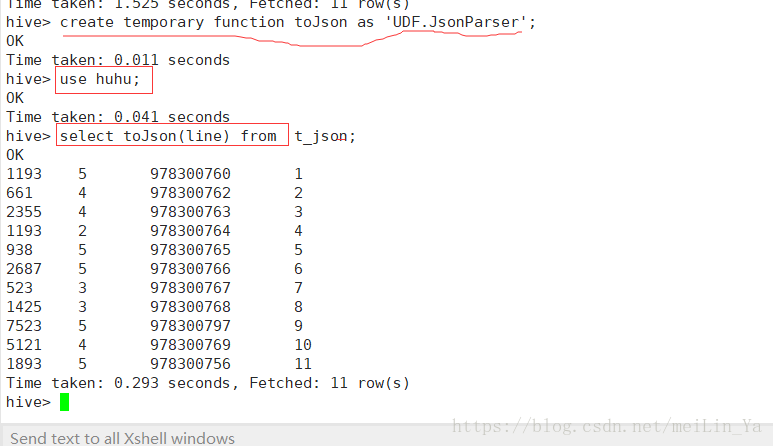
然后将查询出来的数据插入到一张表中
1.使用hive中的自带函数可以解析简单的json数据格式
create table t_json2 as select get_json_object(line,'$.movie')as movie,get_json_object(line,'$.rate')as rate,get_json_object(line,'$.timeStamp')as timeStamps,get_json_object(line,'$.uid')as uid from t_json;
2.使用自定义函数
create table t_json1 as select split(toJson(line),'\t')[0]as movieid,split(toJson(line),'\t')[1]as,split(toJson(line),'\t')[2]as timestring,split(toJson(line),'\t')[3]as uid from t_json;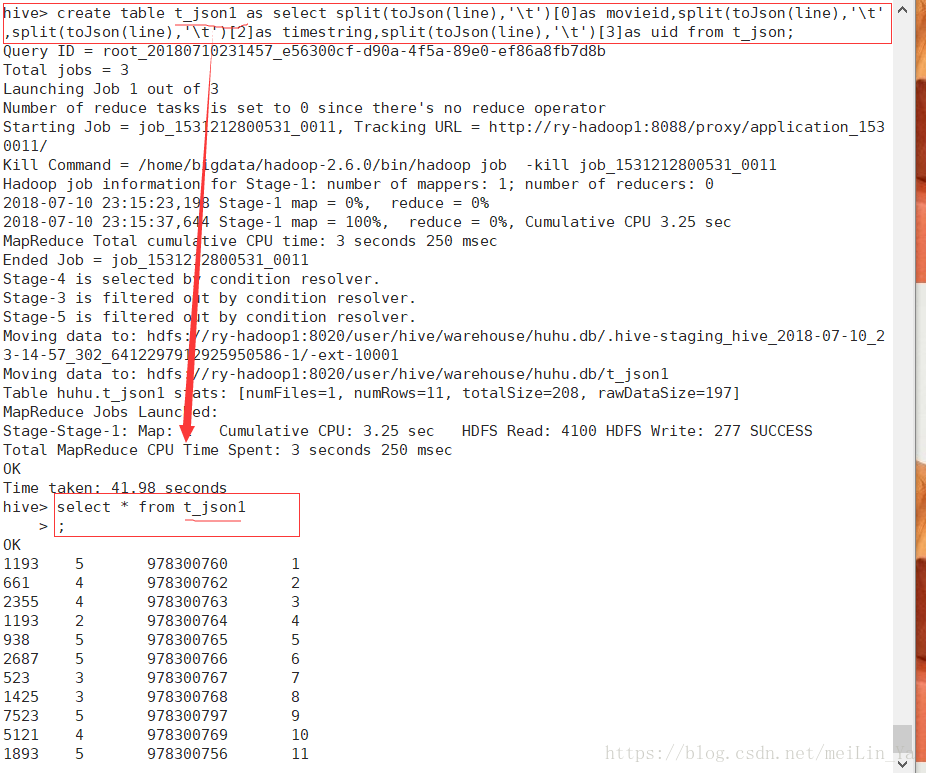
ok!!!
Transform:
Hive的Transform关键字提供了在SQL中调用自写脚本的功能
例子:
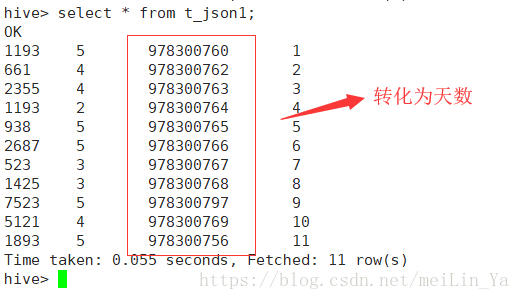
先编辑一个python脚本文件
#!/bin/python

import sys

import datetime

for line in sys.stdin:

  line = line.strip()

  movieid, rating, unixtime,userid = line.split('\t')

  weekday = datetime.datetime.fromtimestamp(float(unixtime)).isoweekday()

  print '\t'.join([movieid, rating, str(weekday),userid])
将文件加入hive的路径classpath
add file /home/data/weekday_mapper.py;创建一个表:
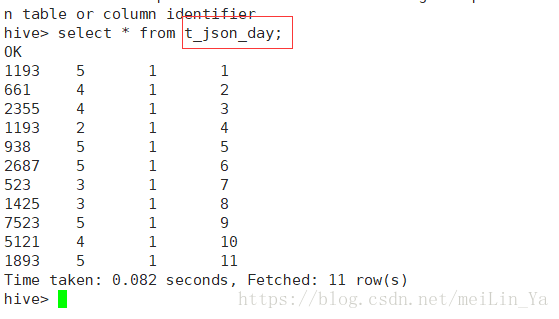
create table t_json_day as select transform (movieid,rate,timestring,uid) using 'python weekday_mapper.py' as (movieid,rate,weekday,uid) from t_json1;
hive -- 自定义函数和Transform的更多相关文章
- Hive自定义函数的学习笔记(1)
前言: hive本身提供了丰富的函数集, 有普通函数(求平方sqrt), 聚合函数(求和sum), 以及表生成函数(explode, json_tuple)等等. 但不是所有的业务需求都能涉及和覆盖到 ...
- hive自定义函数(UDF)
首先什么是UDF,UDF的全称为user-defined function,用户定义函数,为什么有它的存在呢?有的时候 你要写的查询无法轻松地使用Hive提供的内置函数来表示,通过写UDF,Hive就 ...
- hive自定义函数学习
1介绍 Hive自定义函数包括三种UDF.UDAF.UDTF UDF(User-Defined-Function) 一进一出 UDAF(User- Defined Aggregation Funcat ...
- hive自定义函数UDF UDTF UDAF
Hive 自定义函数 UDF UDTF UDAF 1.UDF:用户定义(普通)函数,只对单行数值产生作用: UDF只能实现一进一出的操作. 定义udf 计算两个数最小值 public class Mi ...
- Hive 自定义函数(转)
Hive是一种构建在Hadoop上的数据仓库,Hive把SQL查询转换为一系列在Hadoop集群中运行的MapReduce作业,是MapReduce更高层次的抽象,不用编写具体的MapReduce方法 ...
- Hive 自定义函数
hive 支持自定义UDF,UDTF,UDAF函数 以自定义UDF为例: 使用一个名为evaluate的方法 package com.hive.custom; import org.apache.ha ...
- hive自定义函数——hive streaming
Hadoop Streaming提供了一个便于进行MapReduce编程的工具包,使用它可以基于一些可执行命令.脚本语言或其他编程语言来实现Mapper和 Reducer,Streaming方式是基于 ...
- Hive 自定义函数 UDF UDAF UDTF
1.UDF:用户定义(普通)函数,只对单行数值产生作用: 继承UDF类,添加方法 evaluate() /** * @function 自定义UDF统计最小值 * @author John * */ ...
- Hadoop之Hive自定义函数的陷阱
A left join B, 这个B会连到A. 如<A1,B>, <A2,B>,在处理第一条记录的时候将B.clear(),则第二条记录的B是[]空的这是自定义UDF函数必须注 ...
随机推荐
- UnicodeDecodeError: 'gbk' codec can't decode byte 0xa7 in position 166: illegal multibyte sequence
# -*- coding: utf-8 -*-# encoding = utf-8import unittestimport random class TestSequenceFunctions(un ...
- [转载]Oracle之xml的增删改查操作
tip: xmltype函数是将clob字段转成xmltype类型的函数,若字段本身为xmltype类型则不需要引用xmltype()函数 同名标签用数组取值的方式获取,但起始值从1开始 一.查询(Q ...
- vscode中添加git
步骤: 下载Git客户端 配置环境变量 设置vscode与Git的关联 重启 步骤一: 该网址,下载即可. https://git-scm.com/downloads 步骤二: 计算机 > 属性 ...
- 练手——用Python写的时间戳转换为北京时间的小工具
#北京时间需加上8小时bj = 8*3600 def time_stamp(times): #一天总秒数 nonDaySeconds = 24*3600 leapmonths = [ ...
- 使用GoldenGate EVENTACTIONS执行数据的实时触发和定制化
Oracle GoldenGate不仅可以在线实时同步数据(包括增量和存量),也内置有一套事件触发流程,允许用户根据某张表某条记录的某个特殊字段值,触发相应的自定义执行流程,比如接收到某个银行账号的大 ...
- callable函数 stride的意义 Math.round(),Math.ceil(),Math.floor()用法
callable()函数检查一个函数是否可以调用 如果返回True,object仍然可能调用失败:但如果返回False,调用对象ojbect绝对不会成功. 对于函数, 方法, lambda 函式, 类 ...
- P3440 [POI2006]SZK-Schools(费用流)
P3440 [POI2006]SZK-Schools 每所学校$i$开一个点,$link(S,i,1,0)$ 每个编号$j$开一个点,$link(i,T,1,0)$ 蓝后学校向编号连边,$link(i ...
- 自制操作系统Antz(9)——实现内核 (下) 实现图形化界面
Antz系统更新地址: https://www.cnblogs.com/LexMoon/category/1262287.html Linux内核源码分析地址:https://www.cnblogs. ...
- python实现单例模式的三种方式及相关知识解释
python实现单例模式的三种方式及相关知识解释 模块模式 装饰器模式 父类重写new继承 单例模式作为最常用的设计模式,在面试中很可能遇到要求手写.从最近的学习python的经验而言,singlet ...
- nginx 1.14.2 配置文件优化精选
user nobody; worker_processes ; worker_rlimit_nofile ; events { use epoll; worker_connections ; } ht ...