
Java常用的并发类-总结列表
一、java集合框架概述
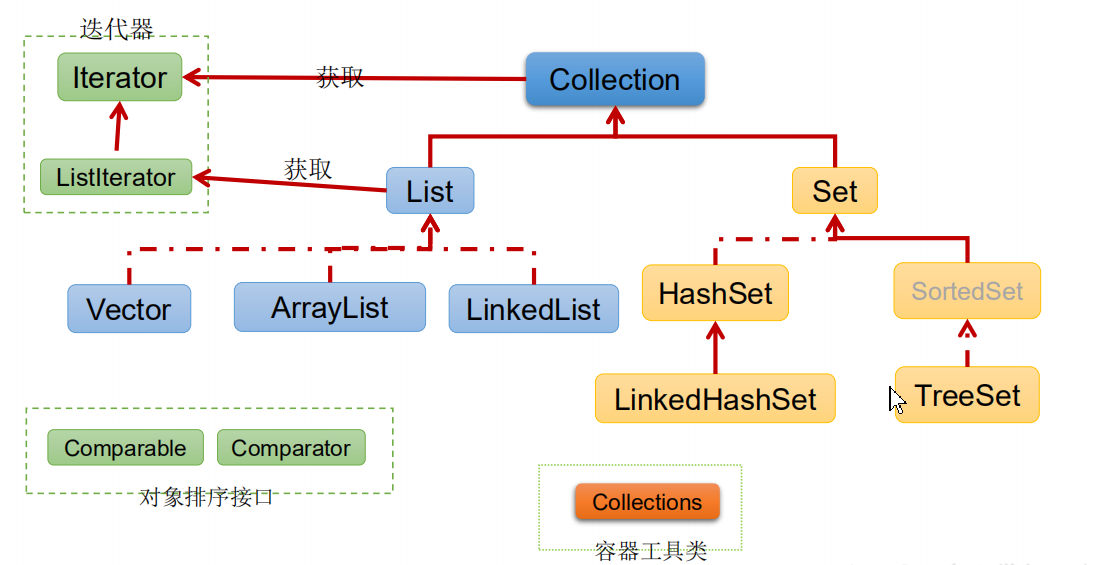
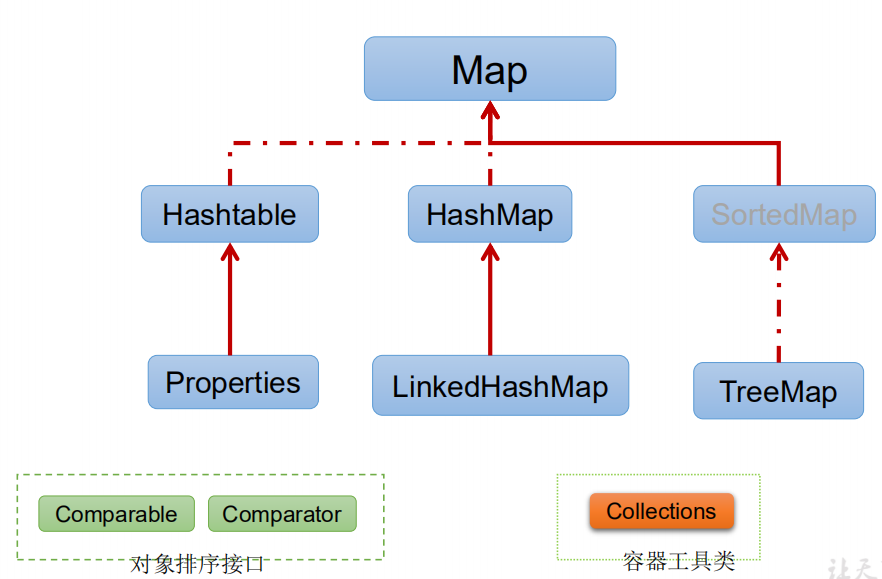
java集合可分为Collection和Map两种体系,其中:
1、Collection接口:单列数据,定义了存取一组对象的方法的集合;
- List:元素有序、可重复的集合
- Set:元素无序,不可重复的集合
2、Map接口:双列数据,保存具有映射关系“key-value对”的集合;
3、Collection接口继承树
4、Map接口的继承树
二、Collection接口常用方法
回顾目录:
- Collection总览
- List集合就这么简单【源码剖析】
- Map集合、散列表、红黑树介绍
- HashMap就是这么简单【源码剖析】
- LinkedHashMap就这么简单【源码剖析】
- TreeMap就这么简单【源码剖析】
- ConcurrentHashMap基于JDK1.8源码剖析
- Set集合就这么简单!
Java容器可分为两大类:
- Collection
- List
- ArrayList
- LinkedList
- Vector(了解,已过时)
- Set
- TreeSet
- HashSet
- LinkedHashSet
- List
- Map
- HashMap
- LinkedHashMap
- TreeMap
- ConcurrentHashMap
- Hashtable(了解,,已过时)
- HashMap
着重标出的那些就是我们用得最多的容器。
其实,我也不知道要怎么总结好,因为之前写每一篇的时候都总结过了。现在又把他们重新罗列出来好像有点水,所以,我决定去回答一些Java容器的面试题!
当然了,我的答案未必就是正确的。如果有错误的地方大家多多包含,希望不吝在评论区留言指正~~
一、ArrayList和Vector的区别
共同点:
- 这两个类都实现了List接口,它们都是有序的集合(存储有序),底层是数组。我们可以按位置索引号取出某个元素,允许元素重复和为null。
区别:
- 同步性:
- ArrayList是非同步的
- Vector是同步的
- 即便需要同步的时候,我们可以使用Collections工具类来构建出同步的ArrayList而不用Vector
- 扩容大小:
- Vector增长原来的一倍,ArrayList增长原来的0.5倍
二、HashMap和Hashtable的区别
共同点:
- 从存储结构和实现来讲基本上都是相同的,都是实现Map接口~
区别:
- 同步性:
- HashMap是非同步的
- Hashtable是同步的
- 需要同步的时候,我们往往不使用,而使用ConcurrentHashMapConcurrentHashMap基于JDK1.8源码剖析
- 是否允许为null:
- HashMap允许为null
- Hashtable不允许为null
- contains方法
- 这知识点是在牛客网刷到的,没想到这种题还会有(我不太喜欢)….
- Hashtable有contains方法
- HashMap把Hashtable的contains方法去掉了,改成了containsValue和containsKey
- 继承不同:
- HashMap extends AbstractMap
- public class Hashtable extends Dictionary
三、List和Map的区别
共同点:
- 都是Java常用的容器,都是接口(ps:写出来感觉好像和没写一样…..)
不同点:
- 存储结构不同:
- List是存储单列的集合
- Map存储的是key-value键值对的集合
- 元素是否可重复:
- List允许元素重复
- Map不允许key重复
- 是否有序:
- List集合是有序的(存储有序)
- Map集合是无序的(存储无序)
四、Set里的元素是不能重复的,那么用什么方法来区分重复与否呢? 是用==还是equals()?
我们知道Set集合实际大都使用的是Map集合的put方法来添加元素。
以HashSet为例,HashSet里的元素不能重复,在源码(HashMap)是这样体现的:
    // 1. 如果key 相等

    if (p.hash == hash &&

        ((k = p.key) == key || (key != null && key.equals(k))))

        e = p;

    // 2. 修改对应的value

       if (e != null) { // existing mapping for key

            V oldValue = e.value;

            if (!onlyIfAbsent || oldValue == null)

                e.value = value;

            afterNodeAccess(e);

            return oldValue;

       }
添加元素的时候,如果key(也对应的Set集合的元素)相等,那么则修改value值。而在Set集合中,value值仅仅是一个Object对象罢了(该对象对Set本身而言是无用的)。
也就是说:Set集合如果添加的元素相同时,是根本没有插入的(仅修改了一个无用的value值)!从源码(HashMap)中也看出来,==和equals()方法都有使用!
五、Collection和Collections的区别
- Collection是集合的上级接口,继承它的有Set和List接口
- Collections是集合的工具类,提供了一系列的静态方法对集合的搜索、查找、同步等操作
六、说出ArrayList,LinkedList的存储性能和特性
ArrayList的底层是数组,LinkedList的底层是双向链表。
- ArrayList它支持以角标位置进行索引出对应的元素(随机访问),而LinkedList则需要遍历整个链表来获取对应的元素。因此一般来说ArrayList的访问速度是要比LinkedList要快的
- ArrayList由于是数组,对于删除和修改而言消耗是比较大(复制和移动数组实现),LinkedList是双向链表删除和修改只需要修改对应的指针即可,消耗是很小的。因此一般来说LinkedList的增删速度是要比ArrayList要快的
6.1扩展:
ArrayList的增删未必就是比LinkedList要慢。
- 如果增删都是在末尾来操作【每次调用的都是remove()和add()】,此时ArrayList就不需要移动和复制数组来进行操作了。如果数据量有百万级的时,速度是会比LinkedList要快的。(我测试过)
- 如果删除操作的位置是在中间。由于LinkedList的消耗主要是在遍历上,ArrayList的消耗主要是在移动和复制上(底层调用的是arraycopy()方法,是native方法)。
- LinkedList的遍历速度是要慢于ArrayList的复制移动速度的
- 如果数据量有百万级的时,还是ArrayList要快。(我测试过)
七、Enumeration和Iterator接口的区别
这个我在前面的文章中也没有详细去讲它们,只是大概知道的是:Iterator替代了Enumeration,Enumeration是一个旧的迭代器了。
与Enumeration相比,Iterator更加安全,因为当一个集合正在被遍历的时候,它会阻止其它线程去修改集合。
- 我们在做练习的时候,迭代时会不会经常出错,抛出ConcurrentModificationException异常,说我们在遍历的时候还在修改元素。
- 这其实就是fail-fast机制~具体可参考博文:https://blog.csdn.net/panweiwei1994/article/details/77051261
区别有三点:
- Iterator的方法名比Enumeration更科学
- Iterator有fail-fast机制,比Enumeration更安全
- Iterator能够删除元素,Enumeration并不能删除元素
八、ListIterator有什么特点
- ListIterator继承了Iterator接口,它用于遍历List集合的元素。
- ListIterator可以实现双向遍历,添加元素,设置元素
看一下源码的方法就知道了:

九、并发集合类是什么?
Java1.5并发包(java.util.concurrent)包含线程安全集合类,允许在迭代时修改集合。
- 迭代器被设计为fail-fast的,会抛出ConcurrentModificationException。
- 一部分类为:
- CopyOnWriteArrayList
- ConcurrentHashMap
- CopyOnWriteArraySet
十、Java中HashMap的key值要是为类对象则该类需要满足什么条件?
需要同时重写该类的hashCode()方法和它的equals()方法。
- 从源码可以得知,在插入元素的时候是先算出该对象的hashCode。如果hashcode相等话的。那么表明该对象是存储在同一个位置上的。
- 如果调用equals()方法,两个key相同,则替换元素
- 如果调用equals()方法,两个key不相同,则说明该hashCode仅仅是碰巧相同,此时是散列冲突,将新增的元素放在桶子上
一般来说,我们会认为:只要两个对象的成员变量的值是相等的,那么我们就认为这两个对象是相等的!因为,Object底层比较的是两个对象的地址,而对我们开发来说这样的意义并不大~这也就为什么我们要重写equals()方法
重写了equals()方法,就要重写hashCode()的方法。因为equals()认定了这两个对象相同,而同一个对象调用hashCode()方法时,是应该返回相同的值的!
十一、与Java集合框架相关的有哪些最好的实践
- 根据需要确定集合的类型。如果是单列的集合,我们考虑用Collection下的子接口ArrayList和Set。如果是映射,我们就考虑使用Map~
- 确定完我们的集合类型,我们接下来确定使用该集合类型下的哪个子类~我认为可以简单分成几个步骤:
- 去找Tree红黑树类型的(JDK1.8)
- 去找Linked双向列表结构的
- 去找线程安全的集合类使用
- 是否需要同步
- 迭代时是否需要有序(插入顺序有序)
- 是否需要排序(自然顺序或者手动排序)
- 估算存放集合的数据量有多大,无论是List还是Map,它们实现动态增长,都是有性能消耗的。在初始集合的时候给出一个合理的容量会减少动态增长时的消耗~
- 使用泛型,避免在运行时出现ClassCastException
- 尽可能使用Collections工具类,或者获取只读、同步或空的集合,而非编写自己的实现。它将会提供代码重用性,它有着更好的稳定性和可维护性
十二、ArrayList集合加入1万条数据,应该怎么提高效率
ArrayList的默认初始容量为10,要插入大量数据的时候需要不断扩容,而扩容是非常影响性能的。因此,现在明确了10万条数据了,我们可以直接在初始化的时候就设置ArrayList的容量!
这样就可以提高效率了~
ArrayList、Vector、LinkedList和CopyOnWriteArrayList的分析
1.ArrayList和LinkedList的区别
(1) ArrayList 基于动态数组实现,数组支持随机访问,但插入删除的代价很高,需要移动大量元素。
(2) LinkedList 基于双向链表实现,链表不支持随机访问,但插入删除只需要改变指针。
2. Vector和ArrayList的区别
(1) Vector的实现与 ArrayList 类似,但是使用了 synchronized 进行同步。因此开销就比 ArrayList 要大,访问速度更慢。最好使用 ArrayList 而不是 Vector,因为同步操作完全可以由程序员自己来控制;
(2) 当Vector或ArrayList中的元素超过它的初始大小时,Vector 每次扩容请求其大小的 2 倍(也可以通过构造函数设置增长的容量),而 ArrayList 是 1.5 倍,ArrayList就有利于节约内存空间。
备注: 对于Vector&ArrayList、Hashtable&HashMap,要记住线程安全的问题,记住Vector与Hashtable是旧的,是java一诞生就提供了的,它们是线程安全的,ArrayList与HashMap是java2时才提供的,它们是线程不安全的。
数据增长:
ArrayList与Vector都有一个初始的容量大小,当存储进它们里面的元素的个数超过了容量时,就需要增加ArrayList与Vector的存储空间,每次要增加存储空间时,不是只增加一个存储单元,而是增加多个存储单元,每次增加的存储单元的个数在内存空间利用与程序效率之间要取得一定的平衡。Vector默认增长为原来两倍,而ArrayList的增长策略在文档中没有明确规定(从源代码看到的是增长为原来的1.5倍)。ArrayList与Vector都可以设置初始的空间大小,Vector还可以设置增长的空间大小,而ArrayList没有提供设置增长空间的方法。
3.CopyOnWriteList
3.1 读写分离
(1) 写操作在一个复制的数组上进行,读操作还是在原始数组中进行,读写分离,互不影响。
(2) 写操作需要加锁,防止并发写入时导致写入数据丢失。
(3) 写操作结束之后需要把原始数组指向新的复制数组。
3.2 使用场景
缺陷:
内存占用: 在写操作时需要复制一个新的数组,使得内存占用为原来的两倍左右;
数据不一致:读操作不能读取实时性的数据,因为部分写操作的数据还未同步到读数组中。
(1) CopyOnWriteArrayList 不适合内存敏感以及对实时性要求很高的场景。
(2) CopyOnWriteArrayList 在写操作的同时允许读操作,大大提高了读操作的性能,因此很适合读多写少的应用场景。
4. ArrayList & Vector & LinkedList & CopyOnWriteArrayList
这四个集合类都继承List接口
(1) ArrayList和LinkedList是线程不安全的
(2) Vector是比较古老的线程安全的,但性能不行;
(3) CopyOnWriteArrayList在兼顾了线程安全的同时,又提高了并发性,性能比Vector有不少提高
1、Java最常用的集合类
- Collection接口
- List接口(允许有重复元素):ArrayList、LinkedList、Vector、Stack
- Set接口(不允许有重复元素,可用于去重操作):HashSet、TreeSet
- Map接口
- HashMap
- TreeMap(具有按key排序的功能)
2、对于Collection需要掌握的七点内容
- Collection的创建:即构造器,掌握在构造器方法中Collection的实现类做了一些什么
- 往Collection中添加对象:即add(E)方法-->类的实现方式决定了此方法的性能
- 删除Collection中的对象:即remove(E)方法-->类的实现方式决定了此方法的性能
- 获取Collection中的单个对象:即get(int index)方法-->类的实现方式决定了此方法的性能
- 遍历Collection中的对象:即iterator,在实际中更常用的是增强型的for循环去做遍历
- 判断对象是否存在于Collection中:contain(E)-->类的实现方式决定了此方法的性能
- Collection中对象的排序:主要取决于所采取的排序算法
对于Collection的分析就会按照以上几点作分析。
3、对于Map需要掌握的七点内容
- Map的创建:即构造器,掌握在构造器方法中Map的实现类做了一些什么
- 往Map中添加键值对:即put(Object key, Object value)方法
- 删除Map中的对象:即remove(Object key)方法
- 获取Map中的单个对象:即get(Object key)方法
- 判断对象是否存在于Map中:containsKey(Object key)
- 遍历Map中的对象:即keySet()和iterator,在实际中更常用的是增强型的for循环去做遍历
- Map中对象的排序:主要取决于所采取的排序算法
对于Map的分析就会按照以上几点作分析。
注意:
- 本系列内容很多都会参考于《分布式Java应用:基础与实践》,说一句,这本书是林昊写的。
- 本系列的内容都是基于JDK1.6.45,建议把源代码关联到eclipse中去。
1、常用的并发集合类
- ConcurrentHashMap:线程安全的HashMap的实现
- CopyOnWriteArrayList:线程安全且在读操作时无锁的ArrayList
- CopyOnWriteArraySet:基于CopyOnWriteArrayList,不添加重复元素
- ArrayBlockingQueue:基于数组、先进先出、线程安全,可实现指定时间的阻塞读写,并且容量可以限制
- LinkedBlockingQueue:基于链表实现,读写各用一把锁,在高并发读写操作都多的情况下,性能优于ArrayBlockingQueue
2、原子类
- AtomicInteger:线程安全的Integer,基于CAS(无阻塞,CPU原语),优于使用同步锁的Integer
3、线程池
- ThreadPoolExecutor:一个高效的支持并发的线程池,可以很容易的讲一个实现了Runnable接口的任务放入线程池执行,但要用好这个线程池,必须合理配置corePoolSize、最大线程数、任务缓冲队列,以及队列满了+线程池满时的回绝策略,一般而言对于这些参数的配置,需考虑两类需求:高性能和缓冲执行。
- Executor:提供了一些方便的创建ThreadPoolExecutor的方法。
- FutureTask:可用于异步获取执行结果或取消执行任务的场景,基于CAS,避免锁的使用
4、锁
- ReentrantLock:与synchronized效果一致,但是又更加灵活,支持公平/非公平锁、支持可中断的锁、支持非阻塞的tryLock(可超时)、支持锁条件等,需要手工释放锁,基于AbstractQueueSynchronizer
- ReentrantReadWriteLock:与ReentrantLock没有关系,采用两把锁,用于读多写少的情形
1、常用的五种并发包
- ConcurrentHashMap
- CopyOnWriteArrayList
- CopyOnWriteArraySet
- ArrayBlockingQueue
- LinkedBlockingQueue
2、ConcurrentHashMap
- 线程安全的HashMap的实现
- 数据结构:一个指定个数的Segment数组,数组中的每一个元素Segment相当于一个HashTable(一个HashEntry[])
- 扩容的话,只需要扩自己的Segment而非整个table扩容
- key与value均不可以为null,而hashMap可以
- 向map添加元素
- 根据key获取key.hashCode的hash值
- 根据hash值算出将要插入的Segment
- 根据hash值与Segment中的HashEntry的容量-1按位与获取将要插入的HashEntry的index
- 若HashEntry[index]中的HashEntry链表有与插入元素相同的key和hash值,根据onlyIfAbsent决定是否替换旧值
- 若没有相同的key和hash,直接返回将新节点插入链头,原来的头节点设为新节点的next(采用的方式与HashMap一致,都是HashEntry替换的方法)
- ConcurrentHashMap基于concurrencyLevel划分出多个Segment来存储key-value,这样的话put的时候只锁住当前的Segment,可以避免put的时候锁住整个map,从而减少了并发时的阻塞现象
- 从map中获取元素
- 根据key获取key.hashCode的hash值
- 根据hash值与找到相应的Segment
- 根据hash值与Segment中的HashEntry的容量-1按位与获取HashEntry的index
- 遍历整个HashEntry[index]链表,找出hash和key与给定参数相等的HashEntry,例如e
- 如没找到e,返回null
- 如找到e,获取e.value
- 如果e.value!=null,直接返回
- 如果e.value==null,则先加锁,等并发的put操作将value设置成功后,再返回value值
- 对于get操作而言,基本没有锁,只有当找到了e且e.value等于null,有可能是当下的这个HashEntry刚刚被创建,value属性还没有设置成功,这时候我们读到是该HashEntry的value的默认值null,所以这里加锁,等待put结束后,返回value值
- 加锁情况(分段锁):
- put
- get中找到了hash与key都与指定参数相同的HashEntry,但是value==null的情况
- remove
- size():三次尝试后,还未成功,遍历所有Segment,分别加锁(即建立全局锁)
3、CopyOnWriteArrayList
- 线程安全且在读操作时无锁的ArrayList
- 采用的模式就是"CopyOnWrite"(即写操作-->包括增加、删除,使用复制完成)
- 底层数据结构是一个Object[],初始容量为0,之后每增加一个元素,容量+1,数组复制一遍
- 遍历的只是全局数组的一个副本,即使全局数组发生了增删改变化,副本也不会变化,所以不会发生并发异常。但是,可能在遍历的过程中读到一些刚刚被删除的对象
- 增删改上锁、读不上锁
- 读多写少且脏数据影响不大的并发情况下,选择CopyOnWriteArrayList
4、CopyOnWriteArraySet
- 基于CopyOnWriteArrayList,不添加重复元素
5、ArrayBlockingQueue
- 基于数组、先进先出、线程安全,可实现指定时间的阻塞读写,并且容量可以限制
- 组成:一个对象数组+1把锁ReentrantLock+2个条件Condition
- 三种入队对比
- offer(E e):如果队列没满,立即返回true; 如果队列满了,立即返回false-->不阻塞
- put(E e):如果队列满了,一直阻塞,直到数组不满了或者线程被中断-->阻塞
- offer(E e, long timeout, TimeUnit unit):在队尾插入一个元素,,如果数组已满,则进入等待,直到出现以下三种情况:-->阻塞
- 被唤醒
- 等待时间超时
- 当前线程被中断
- 三种出对对比
- poll():如果没有元素,直接返回null;如果有元素,出队
- take():如果队列空了,一直阻塞,直到数组不为空或者线程被中断-->阻塞
- poll(long timeout, TimeUnit unit):如果数组不空,出队;如果数组已空且已经超时,返回null;如果数组已空且时间未超时,则进入等待,直到出现以下三种情况:
- 被唤醒
- 等待时间超时
- 当前线程被中断
- 需要注意的是,数组是一个必须指定长度的数组,在整个过程中,数组的长度不变,队头随着出入队操作一直循环后移
- 锁的形式有公平与非公平两种
- 在只有入队高并发或出队高并发的情况下,因为操作数组,且不需要扩容,性能很高
6、LinkedBlockingQueue
- 基于链表实现,读写各用一把锁,在高并发读写操作都多的情况下,性能优于ArrayBlockingQueue
- 组成一个链表+两把锁+两个条件
- 默认容量为整数最大值,可以看做没有容量限制
- 三种入队与三种出队与上边完全一样,只是由于LinkedBlockingQueue的的容量无限,在入队过程中,没有阻塞等待
线程池的选用与线程数的指定
1、选用的两个角度
- 高性能:将提交到线程池中的任务直接交给线程去处理(前提:线程数小于最大线程数),不入队
- 缓冲执行:希望提交到线程池的任务尽量被核心线程(corePoolSize)执行掉
2、高性能
- 队列:SynchronousQueue
- 最大线程数:一般设为Integer.MAX_VALUE(整数最大值),防止回绝任务
- 典型案例:newCachedThreadPool
- 尤其适合于执行耗时短的任务
注意:
- 设置好闲置失效时间,keepAliveTime,用于避免资源大量耗费
- 对于出现大量耗时长的任务,容易造成线程数迅速增加,这种情况要衡量使用该类线程池是否合适
3、缓冲执行
- 队列:LinkedBlockingQueue和ArrayBlockingQueue
- 典型案例:newFixedThreadPool(int threadSize)
注意:
- 使用该类线程池,最好使用LinkedBlockingQueue(无界队列),但是当大量并发任务的涌入,导致核心线程处理不过来,队列元素会大量增加,可能会报内存溢出
- 当然,对于上边这种情况的话,如果是ArrayBlockingQueue的话,如果设置得当,可以回绝一些任务,而不报内存溢出
4、线程数的确定
- 公式:启动线程数=[任务执行时间/(任务执行时间-IO等待时间)]*CPU核数
注意:
- 如果任务大都是CPU计算型任务,启动线程数=CPU核数+1
- 如果任务大多需要等待磁盘操作,网络响应,(IO密集型),启动线程数
- 可以参照公式估算,当然>CPU核数
- 2*cpu
- cpu/(1-0.8~0.9), eg 8核/(1-0.9)=80
总结:
一般使用线程池,按照如下顺序依次考虑(只有前者不满足场景需求,才考虑后者):
newCachedThreadPool-->newFixedThreadPool(int threadSize)-->ThreadPoolExecutor
- newCachedThreadPool不需要指定任何参数
- newFixedThreadPool需要指定线程池数(核心线程数==最大线程数)
- ThreadPoolExecutor需要指定核心线程数、最大线程数、闲置超时时间、队列、队列容量,甚至还有回绝策略和线程工厂
对于:newFixedThreadPool和ThreadPoolExecutor的核心数可以参照上述给出的公式进行估算。
1、Java内存模型(JMM)
Java内存模型的主要目标:定义在虚拟机中将变量存储到内存和从内存中取出变量这样的底层细节。
注意:上边的变量指的是共享变量(实例字段、静态字段、数组对象元素),不包括线程私有变量(局部变量、方法参数),因为私有变量不会存在竞争关系。
1.1、内存模型就是一张图:

说明:
- 所有共享变量存于主内存
- 每一条线程都有自己的工作内存(就是上图所说的本地内存)
- 工作内存中保存了被该线程使用到的变量的主内存副本
注意:
- 线程对变量的操作都要在工作内存中进行,不能直接操作主内存
- 不同的线程之间无法直接访问对方的工作内存中的变量
- 不同线程之间的变量的传递必须通过主内存
类比:(注意:主内存与工作内存只是一个概念,与堆栈内存没有关系,下边的类比只是帮助理解)
- 主内存:对应于Java堆中的对象实例数据部分(注意:堆中还保存了对象的其他信息,eg.Mark Word、Klass Point和用于字节对其补白的填充数据)
- 工作内存:对应于栈中的部分区域
1.2、8条内存屏障指令:
下面只列出6条与之后内容相关的,其余的查看《深入理解Java虚拟机》
- lock:作用于主内存,把一个变量标识为一条线程独占的状态
- unlock:作用于主内存,把一个处于锁定的变量解锁
下边四条是与volatile实现内存可见性直接相关的四条(store、write、read、load)
- store:把工作内存中的变量的值传送到主内存中
- write:把store操作从工作内存中得到的变量值放入到主内存的变量中
- read:把一个变量的值从主内存中传输到线程的工作内存
- load:把read操作从主内存中获取到的变量值放入工作内存的变量中去
注意:
- 一个变量在同一时刻只允许一条线程对其进行lock操作
- lock操作会将该变量在所有线程工作内存中的变量副本清空,否则就起不到锁的作用了
- lock操作可被同一条线程多次进行,lock几次,就要unlock几次(可重入锁)
- unlock之前必须先执行store-write
- store-write必须成对出现(工作内存-->主内存)
- read-load必须成对出现(主内存-->工作内存)
2、变量对所有线程的可见性
可见性:线程1对共享变量的修改能及时被线程2看到
2.1、共享变量不可见的原因
- 共享变量更新后的值没有在工作内存和主内存之间及时更新
- 线程交错执行
- 指令重排序结合线程交错执行
2.2、实现共享变量及时更新的措施
线程1修改过共享变量后,将共享变量刷到主内存,然后,线程2从主内存读取该共享变量,将该共享变量载入到工作内存中
注意:在短时间内的高并发情况下,如果发生下列三种情况,则线程2就读不到线程1修改过的最新的值了,
- 可能线程1根本来不及将修改过后的共享变量刷到主内存(这个时间非常短,但是还是有)的时候,线程2就已经读取了原有的主内存变量到其工作内存中。
- 可能线程1虽然将修改过后的值刷到了主内存中,但是线程2的工作内存中的变量副本还没来得及从CPU刷新回来,所以线程2读取到的还是原来的工作内存中的变量副本
- 可能线程1根本来不及将修改过后的共享变量刷到主内存的时候,同时,线程2的工作内存中的变量副本还没来得及从CPU刷新回来
注意:工作内存中的变量副本在使用之后,不会立刻消失掉,会一直存在,这样其值也一直不变,直到对其进行写操作或数据从CPU中刷新回来(类比volatile-read的作用)。
2.3、指令重排序:代码书写顺序与实际执行顺序不同(编译器或处理器为提高程序性能做的优化)
eg.
书写代码的顺序如下:
int a = 12;

2         int b = 13;

3         int c = a+b;
可能实际执行代码的顺序如下:
int b = 13;

2         int a = 12;

3         int c = a+b;
总结:本文大概介绍了一下Java内存模型以及与共享变量可见性的一些概念,为下边的volatile做准备。
2、具体的实现原理
- 对volatile变量执行写操作时,会在写操作后加入一条store屏障指令
- 对volatile变量执行读操作时,会在读操作前加入一条load屏障指令
说人话:
- 对volatile变量执行读操作时,都要强制的先从主内存读取最新的变量值到工作内存,然后再读工作内存中所存储的变量副本
- 对volatile变量执行写操作时,又会强制的将工作内存中的刚刚改变的值写到主内存中去
通过上边这样模式,每个线程拿到的volatile变量值都是最新的。
注意:
volatile无法实现原子性:
eg.
private volatile int count = 0;
假设现在有两条线程分别对count执行加1操作,那么期待的结果最后count==2,但是看下边的分析:
假设有如下流程:
1)线程a获取了count==0;
2)线程b获取了count==0;
3)线程b对count+1,之后写入主内存count==1;
4)线程a对count+1,之后写入主内存count==1;
结果count==1而非count==2,原因就是线程a获取count后,volatile不能实现原子性,这个时候b也能去操作count。
想要实现原子性,使用synchronized去锁住增加方法,或者使用ReentrantLock去锁住增加代码;当然,以上场景使用AtomicInteger更好。
3、volatile使用场景
- 运算结果并不依赖当前值,例如Boolean就可,而number++这样的就不行,这样的情况使用锁
- 运算结果依赖当前值但是能够确保只有单一线程修改变量的值,例如ConcurrentHashMap中Segment的count变量
- count变量只能由单一线程来改变(因为put和remove都是加锁的),但是修改后未必能及时刷新到主内存;这时候读线程去读取的话就可能读到旧数据。所以需要volatile来保证可见性。
- 变量不需要与其他的状态变量共同参与不变约束,例如low<up这样的场景就不行
- 在访问变量时需要使用锁,就不要使用volatile(《java并发编程实战》)
所以说,volatile只能实现部分线程安全(实际上只能实现可见性)。 如果volatile用得好的话,比synchronized强不少,因为不需要上下文切换。
注:
- 关于volatile禁止指令重排序的介绍去看《深入理解Java虚拟机(第二版)》第十二章"Java内存模型与线程"
- 通常情况下,能用volatile解决的就不去用synchronized了
十三、总结
| 方法描述 | 方法名 |
| 添加 | add/addAll |
| 获取有效元素的个数 | size |
| 判断集合是否为空 | isEmpty |
| 是否包含某个元素 | contains/containsAll |
| 删除 | remove/removeAll |
| 获取两个集合的交集 | retainAll |
| 判断两个集合是否相等 | equals |
| 集合转换成数组 | toArray |
| 清空集合 | clear |
| 遍历 | iterator |
Java常用的并发类-总结列表的更多相关文章
- 第一章 Java常用的并发类
注:本系列博客主要参考于<分布式Java应用:基础与实践>,林昊 著 1.常用的并发集合类 ConcurrentHashMap:线程安全的HashMap的实现 CopyOnWriteArr ...
- Java常用API(Math类)
Java常用API(Math类) Math类的作用 java.lang.Math 类包含用于执行基本数学运算的方法,如初等指数.对数.平方根和三角函数.类似这样的工具 类,其所有方法均为静态方法,并且 ...
- Java常用API(Arrays类)
Java常用API(Arrays类) 什么是Arrays类? java.util.Arrays 此类包含用来操作数组的各种方法,比如排序和搜索等.其所有方法均为静态方法,调用起来 非常简单. 这里我们 ...
- Java常用API(String类)
Java常用API(String类) 概述: java.lang.String 类代表字符串.Java程序中所有的字符串文字(例如 "abc" )都可以被看作是实现此类的实例 1. ...
- Java常用API(ArrayList类)
Java常用API(ArrayList类) 我们为什么要使用ArrayList类? 为了更加方便的储存对象,因为使用普通的数组来存储对象太过麻烦了,因为数组的一个很大的弱点就是长度从一开始就固定了,所 ...
- Java常用API(Random类)
Java常用API(Random类) Random:是一个用于生成随机数的类 构造方法 public Random() :创建一个新的随机数生成器. 返回随机数的方法 public int nextI ...
- Java常用API(Scanner类)
Java常用API( Scanner类)1 1.Scanner类 首先给大家介绍一下什么是JavaAPI API(Application Programming Interface),应用程序编程接口 ...
- Java 常用对象-Math类
2017-11-02 21:26:18 Math类:Math 类包含用于执行基本数学运算的方法,如初等指数.对数.平方根和三角函数. *属性摘要 *常用方法 random() : 返回[0.0,1.0 ...
- Java常用API——时间类
前言:Java.util.*工具包中,包含了集合框架,旧集合类,事件模型,日期和时间设施,国际化和其他使用程序类 (字符串.随机数生成器和位数组) 一.日期类Date 1.概述 Date是一个薄包装类 ...
- java常用开发工具类之 图片水印,文字水印,缩放,补白工具类
import java.awt.AlphaComposite; import java.awt.Color; import java.awt.Font; import java.awt.Graphic ...
随机推荐
- for Qbert sometimes we stay in lives == 0 condtion for a few frames —— baselines中环境包装器EpisodicLifeEnv的分析
相关: baselines中环境包装器EpisodicLifeEnv的分析 一直不是很理解在reinforcement leanrning算法在atari游戏的observation的交互过程中对li ...
- 如何挑选海外4G模组?这里有秘籍!
今天我会告诉大家如何挑选海外4G模组,我会把优势给贴出作为参考.去过国外的都知道国外4G网络各种状况实在让人无力吐槽,做海外设备的朋友,是时候了解一下Air780EEN/EEU/EEJ系列海外模组-- ...
- MySQL注入之Fuzz测试&Bypass WAF小结
目录 BurpSuite Fuzz测试 内联注释 绕过union[]select联合查询 绕过敏感函数 绕过from[]information_schema查表 报错注入示例 常规绕过思路总结 空格绕 ...
- 使用缓存构建更快的 Web 应用程序
使用 Java 缓存系统缓存频繁查看的数据 使用 Java 技术的 Web 开发人员可以使用缓存实用程序快速提升他们的应用程序的性能.Java 缓存系统(Java Caching System,JCS ...
- 无快不破,在本地 docker 运行 IDEA 里面的项目?
目录 前言 Docker Compose 1. Docker Compose是什么? 2. Docker Compose 的具体步骤 3. 如何在IDEA项目里面使用Docker Compose 启动 ...
- ASP.NET Core 9.0 中新增的MapStaticAssets() 中间件
前言 在Core 9.0版本中新增的内容不算多,除了内置OpenAPI 外 应该就属MapStaticAssets中间件最有价值了,最初MapStaticAssets主要是为了解决Blazor静态资源 ...
- HarmonyOS Next 入门实战 - 导航框架:页面路由、组件导航(Navigation)
页面路由 官方不推荐使用页面路由,这里仅做简单介绍. 页面路由用于标识 @Entry 注解的页面间的跳转. 包引入 import { router } from'@kit.ArkUI'; 页面跳转 r ...
- 【快慢指针】LeetCode 143. 重排链表
题解 用快慢指针先找到中间结点,然后断开前后两条链,用头插法的思路逆转后面那条链,最后两条链依次从前往后遍历插入即可. 参考代码 /** * Definition for singly-linked ...
- Fleck:一个轻量级的C#开源WebSocket服务端库
推荐一个简单易用.轻量级的C#开源WebSocket服务端库,方便我们快速实现WebSocket的开发. 01 项目简介 Fleck 是一个用 C# 编写的轻量级 WebSocket 服务器库.它提供 ...
- 开启生态新姿势 | 使用 WordPress 远程附件存储到 COS
在看到这篇文章前,你大概已经听说过 WordPress 了,它是使用 PHP 语言开发的博客平台,用户可以在支持 PHP 和 MySQL 数据库的服务器上架设属于自己的网站,也可以把 WordPres ...