
双数组字典树(Double Array Trie)
参考文献
3.论文《基于双数组Trie树算法的字典改进和实现》
DAT的基本内容介绍这里就不展开说了,从Trie过来的同学应该比较熟悉,Trie对内存的消耗比较大,DAT正是为了优化该问题而提出。此文重点说一下如何去理解DAT的base数组和check数组,希望能给诸位些帮助,DAT中定义base数组、check数组满足的条件为:
base[s] + c = t
check[t] = s
这里s指转移前的状态,c指字符的编码,t指转移后的状态,下面逐个理解这两个公式表示的逻辑。
1. base[s] + c = t
理解这个式子时,不能单纯的从数组取值上去理解,比如直接将s当成base数组的下标,因为 s 和 t 都是状态,而 c 是字符编码,此时就会疑惑,为啥等式两边输出类型都不一致呢?这到底是怎么个计算关系?如果有类似的疑惑,那么可以先摒弃这种的想法。
base数组维护的是Trie树上节点的信息,这个公式想表达的意思是:状态 s (也就是一个节点,Trie树上每个节点都表示一个状态,不理解的可以先了解一下状态机的概念)接收一个字符 c 后,就得到状态 t ,而并不是base数组中下标为 s 处的取值加上 c值 等于 t 值,所以说不能从仅仅从数值计算上理解这个公式。那么这个公式是如何用在DAT的创建中的呢?我们从如下几个问题入手,来了解这个公式的作用。
1.1 s、t 具体是什么意思?
s、t 表示DAT上的一种状态、base数组中的元素,实际上就是Trie上的一个个节点,这个节点上包含很多信息,创建过Trie树的同学知道,Trie树节点上一般包含:属性值value(可以用来记录词性)、叶子节点标记flag(是否为词语的未字符)、子节点数组(用来存储子节点的信息)等等
1.2 base数组中存储的是什么?
base数组维护的是各个状态的信息,即数组中存储的是各节点的信息,但是具体内容与1.1节中所说的Trie节点信息不一致,以参考文献1中实现为例,每个状态下包含的信息包括
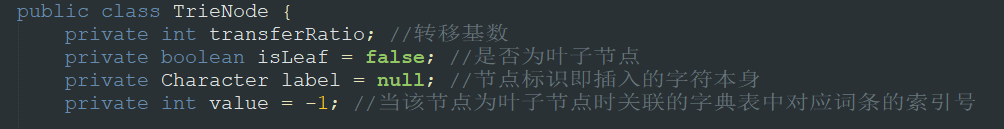
transferRatio:计算子节点在base数组中下标时的转移基数,为了解决节点存储位置冲突而引入的,初始值为0
isLeaf:节点是否为词语的叶子节点。该内容可选,也可以用其它方式表示叶子节点
label:节点存储的字符,可以理解为该节点是通过插入哪个字符得到的。该内容可选,也可以不要
value:如果该节点为叶子节点,那么其对应的词语在词典中序号。该内容为可选,也可以不要
1.3 base数组的下标表示什么意思
base数组的下标是基于字符的编码做加减运算得到的数值。参照1.2节中的例子,创建DAT存储词语“中华”,先创建一个base数组,
TrieNode base[10] //假设存储10个节点
令根节点root = new TrieNode ,很自然的将根节点root存入base[0]。令 root. transferRatio=1 (这里设为1,也可以设个其他值,初始值随便,保证base数组不溢出即可)
接着插入字符“中”,假如采用unicode编码,那么“中”的码值为20013,那么存储 字符“中”的节点在base数组中的下标就为
0 + base[0].transferRatio + unicode("中")=0+1+20013=20014
令 base[20014].transferRatio=1 (这里设为1主要是为了和初始时的0区分开,表示base[20014]这个位置已经有节点占据了)
然后插入字符“华”,unicode('华')=21326,因为是节点“中”接收字符“华”,存储 字符“华”的节点在base数组中的下标就为
20014+ base[20014].transferRatio + unicode('华')=20014+0+21326=41340,
令base[41340].transferRatio=1 ,原因同上。
1.4 c值怎么计算
c值得计算除了1.3中说的计算字符得unicode值,你还可以计算字符hash值得到,只要保证每个字符(中文、英文、日文等等文字的字符)有一个唯一且确定得编码值即可。
通过以上几个问题的说明可知,DAT中每个状态的下标是唯一的(解决位置冲突之后),可以用base数组的下标表示状态,通过索引base数组的下标即可得到各个状态的信息。此时,我们再来从数值计算的角度来理解这个公式,即状态 s 的下标(还要加上偏移transferRatio)加上字符c的编码值,等于状态 t (由状态s 接收字符c 得到)的下标。
2. check[t] = s
理解这个等式,先要从DAT的查询逻辑说起。在Trie中,我们是怎么判断词语存在的?从根节点开始,依次查询词语中的每个字符,若各个字符均存在于当前节点的子节点中,则表明该词语存在。如果在DAT上也按照这个逻辑来判断词语是否存在,则查询过程是这样的:还是以1.3节为例,查询词语 “中华” 是否存在。从根节点开始,首先查询 “中”字,
0 + base[0].transferRatio + unicode("中")=0+1+20013=20014
若base[20014].transferRatio ≠ 0 ,则表明字符“中”存在。(判断base数组中一个位置上是否有数据可以采用很多方式,这里采用参考文献1中的实现方式,即判断TrieNode.transferRatio是否非0)
接着查询字符“华”,
20014+ base[20014].transferRatio + unicode('华')=20014+0+21326=41340
若base[20014].transferRatio ≠ 0,则表明“华”存在。那么这个逻辑在DAT上是否可靠呢?答案是不可靠,因为在DAT上节点转移是通过在base数组上索引字符unicode码值进行的,这就会存在以下的情况
unicode(A) ≠ unicode(B)
unicode(A)+unicode(C) = unicode(B)+unicode(D)
其中 A、B、C、D指unicode编码规范中收录的某个字符,此种情况下的查询逻辑就会出错,所以在DAT中引入了check数组,在check数组中保存的是当前状态的父状态(即当前节点的父节点),还是以1.3节中词语“中华”为例,以base数组的下标表示状态,字符“中”所在节点的父节点为根节点,所以check[20014]=0;字符“华”所在节点的父节点下标为20014,即check[41340]=20014,这样可以确定当前节点的父节点是哪一个,从而解决 unicode(A)+unicode(C) = unicode(B)+unicode(D) 带来的问题。
双数组字典树(Double Array Trie)的更多相关文章
- sphinx索引分析——文件格式和字典是double array trie 检索树,索引存储 – 多路归并排序,文档id压缩 – Variable Byte Coding
1 概述 这是基于开源的sphinx全文检索引擎的架构代码分析,本篇主要描述index索引服务的分析.当前分析的版本 sphinx-2.0.4 2 index 功能 3 文件表 4 索引文件结构 4. ...
- 中文分词系列(二) 基于双数组Tire树的AC自动机
秉着能偷懒就偷懒的精神,关于AC自动机本来不想看的,但是HanLp的源码中用户自定义词典的识别是用的AC自动机实现的.唉-没办法,还是看看吧 AC自动机理论 Aho Corasick自动机,简称AC自 ...
- 【转】B树、B-树、B+树、B*树、红黑树、 二叉排序树、trie树Double Array 字典查找树简介
B 树 即二叉搜索树: 1.所有非叶子结点至多拥有两个儿子(Left和Right): 2.所有结点存储一个关键字: 3.非叶子结点的左指针指向小于其关键字的子树,右指针指向大于其关键字的子树: 如: ...
- 中文分词系列(一) 双数组Tire树(DART)详解
1 双数组Tire树简介 双数组Tire树是Tire树的升级版,Tire取自英文Retrieval中的一部分,即检索树,又称作字典树或者键树.下面简单介绍一下Tire树. 1.1 Tire树 Trie ...
- double array trie 插入结点总结
双数组Trie树索引的可操作性研究.pdf 提示:任一状态点的移动,会影响其Trie树中父节点的base值的选择以及兄弟结点位置的变动,而兄弟结点的移动又须变更相应的子节点的check值. 设待插入的 ...
- 双01字典树最小XOR(three arrays)--2019 Multi-University Training Contest 5(hdu杭电多校第5场)
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=6625 题意: 给你两串数 a串,b串,让你一一配对XOR使得新的 C 串字典序最小. 思路: 首先这边 ...
- [一本通学习笔记] 字典树与 0-1 Trie
字典树中根到每个结点对应原串集合的一个前缀,这个前缀由路径上所有转移边对应的字母构成.我们可以对每个结点维护一些需要的信息,这样即可以去做很多事情. #10049. 「一本通 2.3 例 1」Phon ...
- Double Array Trie 的Python实现
不多介绍,可自行Google,或者其它关键词: "datrie" 放代码链接: double_array_trie.py 因为也是一段学习代码,参考的文章都记在里面了,主要参考gi ...
- 双数组Trie树(DoubleArrayTrie)Java实现
http://www.hankcs.com/program/java/%E5%8F%8C%E6%95%B0%E7%BB%84trie%E6%A0%91doublearraytriejava%E5%AE ...
随机推荐
- .NetCore 异步编程 - async/await
前言: 这段时间开始用.netcore做公司项目,发现前辈搭的框架通篇运用了异步编程方式,也就是async/await方式,作为一个刚接触的小白,自然不太明白其中原理,最重要的是,这个玩意如果不明白基 ...
- pytest文档49-命令行参数--tb的使用
前言 pytest 使用命令行执行用例的时候,有些用例执行失败的时候,屏幕上会出现一大堆的报错内容,不方便快速查看是哪些用例失败. --tb=style 参数可以设置报错的时候回溯打印内容,可以设置参 ...
- C语言中数组与指针的异同之处!你不知道的编程奥秘~
C语言的数组和指针一直是两个容易混淆的东西,当初在学习的时候,也许为了通过考试会对指针和数组的一些考点进行突击,但是很多极其细节的东西也许并不是那么清楚.本篇侧重点在于分析数组与指针的关系,什么时候数 ...
- go 继承
package main import "fmt" type Animal struct { Color string } // 继承动物结构体 type Dog struct { ...
- deepin vue安装步骤
deepin安装node.js sudo wget https://nodejs.org/dist/v9.2.0/node-v9.2.0-linux-x64.tar.xz tar xJf node-v ...
- Drone 安装教程
Drone 安装教程 一. CentOS设置 1. 更换阿里源 curl -o /etc/yum.repos.d/CentOS-Base.repo http://mirrors.aliyun.com/ ...
- js 实现 input file 文件上传
<!DOCTYPE html> <html xmlns="http://www.w3.org/1999/xhtml"> <head runat=&qu ...
- .net core迁移实践:项目文件csproj的转换
随着net core的不断更新和生产可用,越来越多的人把现有的应用迁移和部署到net core平台.本文将分享迁移过程中的一个环节,给大家做一下参考. 背景说明 先来介绍一下什么是SDK样式的文件结构 ...
- Lambda表达式(一)
Lambda表达式其实就是实现SAM接口的语法糖,作用就是简化代码的冗余,同时可读性也好过匿名内部类. 以下先一步步演示是如何把大段的代码变成一句代码的,加强理解! 第一种正常的写法 1 public ...
- Jupyter Notebook使用教程
关于安装我就不说了,可以参考知乎https://zhuanlan.zhihu.com/p/33105153(总结的很全面) 首先打开Jupyter Notebook后,新建notebook:点击右上角 ...