
debezium同步postgresql数据至kafka
0 实验环境
全部部署于本地虚拟机
debezium docker部署
postgresql、kafka本机部署
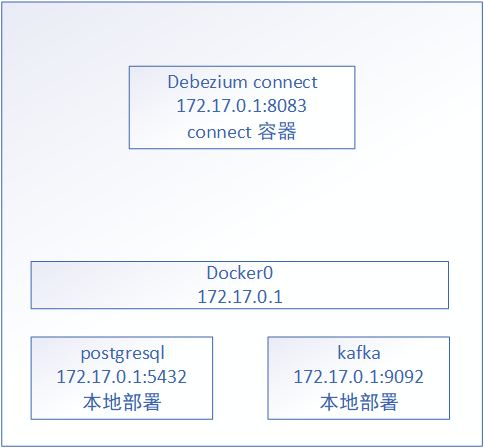
1 postgresql
1.1 配置
设置postgres密码为123
仿照example,创建database postgres,scheme inventory,table customers
因为postgres用户有replication权限,所以可以直接使用
修改postgresql.conf文件
listen_addresses = '*' #确保容器可以访问到

shared_preload_libraries = '' #使用默认的pgoutput

wal_level = logical
以postgres用户重启pg
pg_ctl restart
1.2 测试
show wal_level;
2 kafka
2.1 启动
参考博文
单节点kafka部署笔记
2.2 配置
修改kafka目录下的config/kraft/server.properties,确保容器可以访问到
listeners=PLAINTEXT://:9092,CONTROLLER://:9093

advertised.listeners=PLAINTEXT://172.17.0.1:9092
启动后无需创建topic,connect启动后会自动创建
如果手工创建,注意cleanup.policy一定要设置为compact模式,否则connect会出错停止
bin/kafka-topics.sh --create --topic debezium --config cleanup.policy=compact --bootstrap-server 172.17.0.1:9092
2.3 测试
列出所有topic
bin/kafka-topics.sh --bootstrap-server 172.17.0.1:9092 --list
3 启动connector
3.1 启动
下载docker镜像并启动,通过BOOTSTRAP_SERVERS指定kafka
docker pull debezium/postgres

docker run -d --name connect -p 8083:8083 -e GROUP_ID=1 -e CONFIG_STORAGE_TOPIC=debezium_configs -e OFFSET_STORAGE_TOPIC=debezium_offsets -e STATUS_STORAGE_TOPIC=debezium_statuses -e BOOTSTRAP_SERVERS=172.17.0.1:9092 debezium/connect:latest
3.2 配置
由于默认数据格式是avro,非常长,改为json格式会简洁很多
修改容器中的配置文件/kafka/config/connect-standalone.properties
key.converter.schemas.enable设置为false

value.converter.schemas.enable设置为false
可以通过docker cp将文件拷贝出来,修改后再复制进去,或者直接挂载配置文件
3.3 创建connect
在pgsql-inventory-connector.json中写入请求数据,通过database.hostname确定postgresql
{

  "name": "inventory-connector",

  "config": {

    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",

    "plugin.name": "pgoutput",

    "database.hostname": "172.17.0.1",

    "database.port": "5432",

    "database.user": "postgres",

    "database.password": "123",

    "database.dbname" : "postgres",

    "topic.prefix": "dbserver1",

    "table.include.list": "inventory.customers"

  }

}
添加
curl -i -X POST -H "Accept:application/json" -H "Content-Type:application/json" 172.17.0.1:8083/connectors/ -d @pgsql-inventory-connector.json
删除
curl -i -X DELETE 172.17.0.1:8083/connectors/inventory-connector/
查询
curl -i -X GET -H "Accept:application/json" 172.17.0.1:8083/connectors/inventory-connector
重启
curl -X POST -H "Accept:application/json" 172.17.0.1:8083/connectors/inventory-connector/restart
4 测试
postgresql、kakfa、connect启动完成后
4.1 kafka消费
bin/kafka-console-consumer.sh --topic dbserver1.inventory.customers --from-beginning --bootstrap-server 172.17.0.1:9092
4.2 postgresql修改
insert into inventory.customers values (1005,'aA','bB','aAbB@home.com');
4.3 kafka结果
Avro格式
{"schema":{"type":"struct","fields":[{"type":"struct","fields":[{"type":"int32","optional":false,"default":0,"field":"id"},{"type":"string","optional":false,"field":"first_name"},{"type":"string","optional":false,"field":"last_name"},{"type":"string","optional":false,"field":"email"}],"optional":true,"name":"dbserver1.inventory.customers.Value","field":"before"},{"type":"struct","fields":[{"type":"int32","optional":false,"default":0,"field":"id"},{"type":"string","optional":false,"field":"first_name"},{"type":"string","optional":false,"field":"last_name"},{"type":"string","optional":false,"field":"email"}],"optional":true,"name":"dbserver1.inventory.customers.Value","field":"after"},{"type":"struct","fields":[{"type":"string","optional":false,"field":"version"},{"type":"string","optional":false,"field":"connector"},{"type":"string","optional":false,"field":"name"},{"type":"int64","optional":false,"field":"ts_ms"},{"type":"string","optional":true,"name":"io.debezium.data.Enum","version":1,"parameters":{"allowed":"true,last,false,incremental"},"default":"false","field":"snapshot"},{"type":"string","optional":false,"field":"db"},{"type":"string","optional":true,"field":"sequence"},{"type":"string","optional":false,"field":"schema"},{"type":"string","optional":false,"field":"table"},{"type":"int64","optional":true,"field":"txId"},{"type":"int64","optional":true,"field":"lsn"},{"type":"int64","optional":true,"field":"xmin"}],"optional":false,"name":"io.debezium.connector.postgresql.Source","field":"source"},{"type":"string","optional":false,"field":"op"},{"type":"int64","optional":true,"field":"ts_ms"},{"type":"struct","fields":[{"type":"string","optional":false,"field":"id"},{"type":"int64","optional":false,"field":"total_order"},{"type":"int64","optional":false,"field":"data_collection_order"}],"optional":true,"name":"event.block","version":1,"field":"transaction"}],"optional":false,"name":"dbserver1.inventory.customers.Envelope","version":1},"payload":{"before":null,"after":{"id":1005,"first_name":"aA","last_name":"bB","email":"aAbB@home.com"},"source":{"version":"2.2.0.Alpha3","connector":"postgresql","name":"dbserver1","ts_ms":1687946054175,"snapshot":"false","db":"postgres","sequence":"[\"34244288\",\"34244576\"]","schema":"inventory","table":"customers","txId":758,"lsn":34244576,"xmin":null},"op":"c","ts_ms":1687946054536,"transaction":null}}
JSON格式
瞬间简洁很多
{"before":null,"after":{"id":1005,"first_name":"aA","last_name":"bB","email":"aAbB@home.com"},"source":{"version":"2.2.0.Alpha3","connector":"postgresql","name":"dbserver1","ts_ms":1688112418157,"snapshot":"false","db":"postgres","sequence":"[\"85230368\",\"85230656\"]","schema":"inventory","table":"customers","txId":1637,"lsn":85230656,"xmin":null},"op":"c","ts_ms":1688112418467,"transaction":null}
debezium同步postgresql数据至kafka的更多相关文章
- 使用maxwell实时同步mysql数据到kafka
一.软件环境: 操作系统:CentOS release 6.5 (Final) java版本: jdk1.8 zookeeper版本: zookeeper-3.4.11 kafka 版本: kafka ...
- flink-cdc同步mysql数据到kafka
本文首发于我的个人博客网站 等待下一个秋-Flink 什么是CDC? CDC是(Change Data Capture 变更数据获取)的简称.核心思想是,监测并捕获数据库的变动(包括数据 或 数据表的 ...
- OGG 从Oracle备库同步数据至kafka
OGG 从Oracle备库同步数据至kafka Table of Contents 1. 目的 2. 环境及规划 3. 安装配置JDK 3.1. 安装jdk 3.2. 配置环境变量 4. 安装Data ...
- MongoDB -> kafka 高性能实时同步(采集)mongodb数据到kafka解决方案
写这篇博客的目的 让更多的人了解 阿里开源的MongoShake可以很好满足mongodb到kafka高性能高可用实时同步需求(项目地址:https://github.com/alibaba/Mong ...
- MongoDB -> kafka 高性能实时同步(sync 采集)mongodb数据到kafka解决方案
写这篇博客的目的 让更多的人了解 阿里开源的MongoShake可以很好满足mongodb到kafka高性能高可用实时同步需求(项目地址:https://github.com/alibaba/Mong ...
- SQLServer数据实时同步PostgreSQL
SQLServer数据实时同步至PostgreSQL 前言: 为迎合工作需求有时候传送的数据保存在SQLServer中但由于工作需要需要保存到PostgreSQL中进行处理,本文主要通过在SQLSer ...
- 使用logstash同步MySQL数据到ES
使用logstash同步MySQL数据到ES 版权声明:[分享也是一种提高]个人转载请在正文开头明显位置注明出处,未经作者同意禁止企业/组织转载,禁止私自更改原文,禁止用于商业目的. https:// ...
- HttpServer发送数据到kafka
文件夹 1.需求 2.框架结构图和步鄹图 3.代码结构 4.代码展现 ------------------------ 1.需求 1.1.解析路径,将路径的最后一个字符串作为Appkey: 1.2.数 ...
- 【大数据】Kafka学习笔记
第1章 Kafka概述 1.1 消息队列 (1)点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除) 点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息 ...
- Debezium SQL Server Source Connector+Kafka+Spark+MySQL 实时数据处理
写在前面 前段时间在实时获取SQLServer数据库变化时候,整个过程可谓是坎坷.然后就想在这里记录一下. 本文的技术栈: Debezium SQL Server Source Connector+K ...
随机推荐
- 苹果怎么查看UDID iPhone/iPad查看UDID教程【详解】
在开发iPhone和iPad软件的时候,要使用UDID来做真机测试,那么如何查看iPhone或者iPad的UDID呢?下面介绍三种最简单的查看UDID的方法,供大家参考!下面就详情来看看. 1.使 ...
- 读《mysql是怎样运行的》有感
最近读了一本书<mysql是怎样运行的>,读完后在大体上对mysql的运行有一定的了解.在以前,我对mysql有以下的为什么: InnoDB中的表空间.段.区和页是什么? redo log ...
- sklearn数据预处理中fit(),transform()与fit_transform()的区别
1 概述 注意这是数据预处理中的方法: Fit(): Method calculates the parameters μ and σ and saves them as internal objec ...
- ES6模块化之import的使用方式
1.引入外部文件: <script src='文件路径' type='module'><!--PS:这个type="module" 必须要写,否则浏览器会报错-- ...
- 逍遥自在学C语言 | 条件控制的正确使用姿势
前言 在C语言中,有三种条件判断结构:if语句.if-else语句和switch语句. 一.人物简介 第一位闪亮登场,有请今后会一直教我们C语言的老师 -- 自在. 第二位上场的是和我们一起学习的小白 ...
- 文心一言 VS chatgpt (3)-- 算法导论2.1
一.以图 2-2 为模型,说明INSERTION-SORT 在数组 A=(31,41,59,26,41,58)上的执行过程. 文心一言: 以图 2-2 为模型,说明INSERTION-SORT 在数组 ...
- 2022-05-15:N个学校之间有单向的网络,每个学校得到一套软件后,可以通过单向网络向周边的学校传输。 问题1:初始至少需要向多少个学校发放软件,使得网络内所有的学校最终都能得到软件; 问题2:至
2022-05-15:N个学校之间有单向的网络,每个学校得到一套软件后,可以通过单向网络向周边的学校传输. 问题1:初始至少需要向多少个学校发放软件,使得网络内所有的学校最终都能得到软件: 问题2:至 ...
- distribute by在spark中的一些应用
一.在二次排序当中的应用 1.1 说到排序当然第一想到的就是sort by和order by这两者的区别,也分情况. 在算子当中,两者没有区别,orderby()调用的也是sort.order by就 ...
- [C#]插件编程框架 MAF 开发总结
1. 什么是MAF和MEF? MEF和MEF微软官方介绍:https://learn.microsoft.com/zh-cn/dotnet/framework/mef/ MEF是轻量化的插件框架,MA ...
- 基于electron25+vite4创建多窗口|vue3+electron25新开模态窗体
在写这篇文章的时候,查看了下electron最新稳定版本由几天前24.4.0升级到了25了,不得不说electron团队迭代速度之快! 前几天有分享一篇electron24整合vite4全家桶技术构建 ...