
redis百万级数据存取
       Jedis jedis0 = new Jedis("localhost", 6379);

        jedis0.auth("123456");

        Pipeline pipelined = jedis0.pipelined();

        Set<String> keys = jedis0.keys("batch*");

        for (String key:keys){

            pipelined.get(key);

        }

                List<Object> objects = pipelined.syncAndReturnAll();

                long l1 = System.currentTimeMillis();

                for (Object src:objects){

                    System.out.println(src);

                }

                long l2 = System.currentTimeMillis();

                System.out.println("耗时:"+(l2-l1)+"ms");

            }

使用Pipeline百万级数据7

        Jedis jedis0 = new Jedis("localhost", 6379);

        jedis0.auth("123456");

        long l1 = System.currentTimeMillis();

        for (int i = 0; i < 1000000; i++) {

            jedis0.get("batch" + i);

        }

        long l2 = System.currentTimeMillis();

        System.out.println("耗时:" + (l2 - l1) + "ms");

普通get去获取耗时:耗时:48622ms

前提redis版本要支持缓存,redis源码每次缓存8192个字节,

# client-output-buffer-limit <class> <hard limit> <soft limit> <soft seconds>超过这个限制直接断开连接,不然存了

client-output-buffer-limit normal 0 0 0

client-output-buffer-limit slave 256mb 64mb 60

client-output-buffer-limit pubsub 32mb 8mb 60
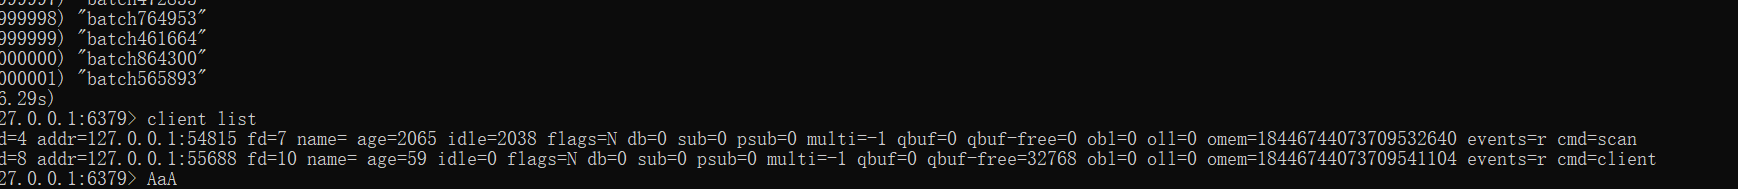
obl:输出缓存区长度
oll: 使用缓存的数量
omen:obl和oll占用的内内存
使用时要控制内存,因为使用Pipeline即使用本地客户端内存,也用服务端内存,适合用实施性不高的场景
redis百万级数据存取的更多相关文章
- 实战手记:让百万级数据瞬间导入SQL Server
想必每个DBA都喜欢挑战数据导入时间,用时越短工作效率越高,也充分的能够证明自己的实力.实际工作中有时候需要把大量数据导入数据库,然后用于各种程序计算,本文将向大家推荐一个挑战4秒极限让百万级数据瞬间 ...
- 【转 】实战手记:让百万级数据瞬间导入SQL Server
想必每个DBA都喜欢挑战数据导入时间,用时越短工作效率越高,也充分的能够证明自己的实力.实际工作中有时候需要把大量数据导入数据库,然后用于各种程序计算,本文将向大家推荐一个挑战4秒极限让百万级数据瞬间 ...
- 构建ASP.NET MVC4+EF5+EasyUI+Unity2.x注入的后台管理系统(37)-文章发布系统④-百万级数据和千万级数据简单测试
原文:构建ASP.NET MVC4+EF5+EasyUI+Unity2.x注入的后台管理系统(37)-文章发布系统④-百万级数据和千万级数据简单测试 系列目录 我想测试EF在一百万条数据下的显示时间! ...
- EF查询百万级数据的性能测试--多表连接复杂查询
相关文章:EF查询百万级数据的性能测试--单表查询 一.起因 上次做的是EF百万级数据的单表查询,总结了一下,在200w以下的数据量的情况(Sql Server 2012),EF是可以使用,但是由于 ...
- poi实现百万级数据导出
注意使用 SXSSFWorkbook 此类在构造表格和处理行高的时候效率极高,刚开始时我使用的 XSSFWorkbook 就出现构造表格效率极低,一万行基本需要3秒左右,那当导出百万级数据就慢的要死啦 ...
- redis通过json方案存取对象com.alibaba.fastjson.JSONException: syntax error, expect
问题描述: redis基于json方案存取对象时报错:com.alibaba.fastjson.JSONException: syntax error, expect com.alibaba.fast ...
- Sql Server中百万级数据的查询优化
原文:Sql Server中百万级数据的查询优化 万级别的数据真的算不上什么大数据,但是这个档的数据确实考核了普通的查询语句的性能,不同的书写方法有着千差万别的性能,都在这个级别中显现出来了,它不仅考 ...
- Mongo查询百万级数据性能问题及JAVA优化问题
Mongo查询百万级数据 使用分页 skip和limit 效率会相当慢 那么怎么解决呢 上代码 全部查询数据也会特别慢 Criteria criteria = new Criteria(); ...
- 详解如何挑战4秒内百万级数据导入SQL Server(转)
对于大数据量的导入,是DBA们经常会碰到的问题,在这里我们讨论的是SQL Server环境下百万级数据量的导入,希望对大家有所帮助.51CTO编辑向您推荐<SQL Server入门到精通&g ...
随机推荐
- P2015
二叉苹果树 1 #include<iostream> 2 #include<cstdio> 3 #include<algorithm> 4 #include< ...
- webpack 命令行报错“webpack” 不是内部或外部命令的解决方法
1. NodeJS安装,笔者安装在D盘.安装目录中有两个文件夹node_cache,node_global如下: 2. 配置 npm安装路径,输入如下命令: npm config set prefix ...
- Ubuntu 19.10安装Wine软件
======================================== 我使用的操作系统版本为Ubuntu 19.10 64位,如果是32位Ubuntu19.10则可以跳过步骤一 1.添加 ...
- Python入门 -- 001
在Windows系统下安装python: 从Python的官方网站(http://www.python.org/)下载最新版的程序安装包. 安装完成后设置路径,使得在Windows系统的CMD中能够通 ...
- HCIA-网络层包结构
网络层 关心-->转发 IPV4协议 IPV6协议 寻址 转发 标识位置 IPV6: 86DD MAC定位局部 网络定位全局 对于上层数据如果过大,网络层可以分组,实现分组转发 环路:发送了一个 ...
- Spring Boot 与 R2DBC 整合
R2DBC 是 "Reactive Relational Database Connectivity"的简称.R2DBC 是一个 API 规范的倡议,声明对于访问关系型数据库驱动实 ...
- Java和Groovy脚本互相调用实例
本实例是GODU动态脚本的一个技术简化版,演示了java调groovy,groovy又调java的运行过程. 测试用例: package com.boco.godu.integration; impo ...
- ES6继承和ES5继承是完全一样的么?
继承方式 ES5 prototype 继承 通过原型链(构造函数 + [[prototype]])指向实现继承. (备注:后续__proto__我都会写成[[prototype]]这种形式) 子类的 ...
- SpringCloud升级之路2020.0.x版-16.Eureka架构和核心概念
本系列代码地址:https://github.com/HashZhang/spring-cloud-scaffold/tree/master/spring-cloud-iiford Eureka 目前 ...
- 【C语言】浮点型在内存中的存储
1. 摘要 在了解到C语言中整型是以二进制补码形式存储在内存中后,我们不禁很好奇:那么浮点型的数据是以什么形式存储在内存中的呢? 实际上,早在1985年,电气电子工程师学会就制定了IEEE 754标准 ...