
python列表中中文编码的问题
在python2列表中,有时候,想打印一个列表,会出现如下显示:
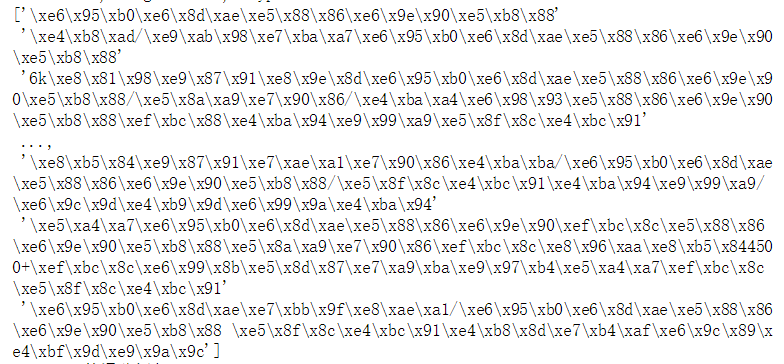
这个是由于:
print一个对象,是输出其“为了给人(最终用户)阅读”而设计的输出形式,那么字符串中的转义字符需要转出来,而且 也不要带标识字符串边界的引号。
因此,单独打印列表中的某一项,譬如:list[0],他可以很好的转义出中文字符。而一个list对象,本身就是个数据结构,如果要把它显示给最终用户看,它不会对里面的数据进行润色。
解决办法参考:https://www.zhihu.com/question/20413029
由此进一步思考:
1、我们在定义字符串的时候,u"中文"的u是什么意思?
string = u"中文"

string.decode('utf8')
可以看到会出异常:
---------------------------------------------------------------------------

UnicodeEncodeError                        Traceback (most recent call last)

<ipython-input-41-b3abdaf47d60> in <module>()

      1 string = u"中文"

----> 2 string.decode('utf8')

C:\ProgramData\Anaconda2\lib\encodings\utf_8.pyc in decode(input, errors)

     14

     15 def decode(input, errors='strict'):

---> 16     return codecs.utf_8_decode(input, errors, True)

     17

     18 class IncrementalEncoder(codecs.IncrementalEncoder):

UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-1: ordinal not in range(128)
这说明,string的编码方式并不是utf-8。
我之前一直以为是指的是utf-8的编码方式,其实不然。
2、# -*- coding: utf-8 -*- 和 sys.setdefaultencoding("utf-8")的区别是什么?
# -*- coding: utf-8 -*- :作用于源代码,如果没有定义,源码不能包含中文字符。https://www.python.org/dev/peps/pep-0263/
sys.setdefaultencoding("utf-8") :设置默认的string编码方式
3、decode\encode指定编码解码方式
# -*- coding: utf-8 -*-

import sys

#Python2.5 初始化后删除了 sys.setdefaultencoding 方法,我们需要重新载入

reload(sys)

sys.setdefaultencoding('utf-8')

string = "中文"

print repr(string.decode('utf-8'))
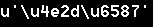
4、unicode编码
字符串通常包含str、unicode两种类型,通常str指字符串编码方式。在Python程序内部,通常使用的字符串为unicode编码,这样的字符串字符是一种内存编码格式,如果将这些数据存储到文件或是记录日志的时候,就需要将unicode编码的字符串转换为特定字符集的存储编码格式,比如:UTF-8、GBK等。
unicode编码:编码表的编号从0一直算到了100多万(三个字节)。每一个区间都对应着一种语言的编码。目前几乎收纳了全世界大部分的字符。所有的字符都有唯一的编号,事实上是一种字符集。但是,unicode把大家都归纳进来,却没有为编码的二进制传输和二进制解码做出规定。于是,就出现了如下解决方案:uft-8,utf-16,utf-32这些编码方案,主要还是为了解决一个信息传输效率的问题,因为如果直接根据字符集进行传输的话,三个字节的表示就会比较低效了。
str 转 unicode
string = "asdf"

string.decode("utf-8")

所以,u就是unicode
unicode转 str
string = u"asdf"

string.encode("utf-8")

5、unicode-escape
在将unicode存储到文本的过程中,还有一种存储方式,不需要将unicode转换为实际的文本存储字符集,而是将unicode的内存编码值进行存储,读取文件的时候再反向转换回来,是采用:unicode-escape的转换方式。
unicode到unicode-escape
string = "中文"  #  或 u"中文",不影响,因为最终都是unicode的内存编码

string.encode("unicode-escape")
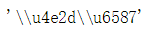
unicode-escape到unicode
string = "中文"

string.decode("unicode-escape")
>> u'\xe4\xb8\xad\xe6\x96\x87
6、string-escape
对于utf-8编码的字符串,在存储的时候,通常是直接存储,而实际上也还有一种存储utf-8编码值的方法,即:string-escape。
str(utf8)到string-escape
string = "中文"

string.encode("string-escape")
>> '\\xe4\\xb8\\xad\\xe6\\x96\\x87'
string-escape到str(utf8)
string = "中文"

string.decode("string-escape")
>>'\xe4\xb8\xad\xe6\x96\x87'
//-------------由上,进一步分析:
a = "中文"

print repr(a.decode("utf-8"))

a = "中文"

print repr(a.decode("unicode-escape"))

print repr(u"中文")

print repr(a)
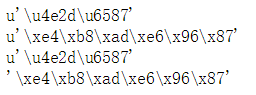
可以看到,从str转unicode和从unicode-escape转unicode的差距。再比如:
string = '\u4e2d\u6587'

print repr(string.decode("unicode-escape"))

print repr(string.decode("utf8"))

更为清楚的看到,从unicode-escape转unicode,两者没有文本转化的过程,是一个内存转化的过程。而通过str转unicode,会有文本转化,譬如对转义字符的操作。
对于列表中中文编码的解释:
arr = [u"中文"]

print arr

print repr(arr)

pp =  str(arr).decode("unicode-escape")#

print pp

print repr(pp)

tt = str(arr).decode("utf-8")

print tt

print repr(tt)
>>[u'\u4e2d\u6587']
>>[u'\u4e2d\u6587']
>>[u'中文']
>>u"[u'\u4e2d\u6587']"
>>[u'\u4e2d\u6587']
>>u"[u'\\u4e2d\\u6587']"
由此可见,想要打印list中的中文,思路是:
通过字符串化处理,将list转化为str(utf-8)文本编码的方式,同时要保留list里面的unicode,避免通过字符处理导致的转义操作,破坏掉中文的unicode,因此选择了unicode-escape
python列表中中文编码的问题的更多相关文章
- 如何在python列表中查找某个元素的索引
如何在python列表中查找某个元素的索引 2019-03-15 百度上回复别人的问题,几种方式的回答: 1) print('*'*15,'想找出里面有重复数据的索引值','*'*15) listA ...
- python 列表中[ ]中冒号‘:’的作用
中括号[ ]:用于定义列表或引用列表.数组.字符串及元组中元素位置 list1 = [, ] list2 = [, , , , , , ] print ] print :] 冒号: 用于定义分片. ...
- python列表中的pop函数
再python的列表中,有许多的内置方法,而在这里我主要向大家介绍一下pop函数. pop函数主要是用于删除列表中的数据.而其删除值时会返回删除的值.如果没有参数传入时, 则会默认认为删除列表的最后一 ...
- Python列表中的字典按照该字典下的键值进行排序
列表中的字典按照该字典下的键值进行排序 这算是排序中比较复杂的一种情况吧,多重嵌套,按照某种规则进行排序.如下面这个json(注:这里这是该列表中的一个项): [ { "stat" ...
- python列表中,多次追加元素
在列表中追加元素,可以使用append(),列表相加也可以用extend()函数,多次追加元素可以用“+”实现 l=[1,2,3,4,5] x=6 y=7 z=8 l=l+[x]+[y]+[z] pr ...
- 在python列表中删除所有空元素
今天在测试数据的时候偶然发现一个问题,如下: test = ['a','','b','','c','',''] for i in test: if i == '': test.remove(i) pr ...
- python 列表中字符串排序故事一则
a = ["bca","cab","abc"] 有时候需要对列表排序 如果是对列表中整个元素 直接用sort()排序 如果想按元素的某一段排 ...
- python列表中的深浅copy
列表中的赋值和平常的赋值是不一样的,看下面的代码: In [1]: a = 1 In [2]: b = a In [3]: a Out[3]: 1 In [4]: b Out[4]: 1 In [5] ...
- Python列表中去重的多种方法
怎么快速的对列表进行去重呢,去重之后原来的顺序会不会改变呢? 去重之后顺序会改变 set去重 列表去重改变原列表的顺序了 l1 = [1,4,4,2,3,4,5,6,1] l2 = list(set( ...
随机推荐
- asp.net 调用post方法并获取返回值
/// <summary> /// http协议 post数据 接受返回结果 /// </summary> /// <param ...
- Vue项目按需打包Lodash
使用的是 webpack 模板 1. 首先安装 npm install lodash --save npm install lodash-webpack-plugin babel-plugin-lod ...
- 20155303 《Java程序设计》实验一(Java开发环境的熟悉)实验报告
20155303 <Java程序设计>实验一(Java开发环境的熟悉)实验报告 一.实验内容及步骤 (一)使用JDK编译.运行简单的java程序 命令行下的程序开发 步骤一(新建文件夹): ...
- 【bzoj题解】2186 莎拉公主的困惑
题目传送门. 题意:求\([1,n!]\)中与\(m!\)互质的数的个数,对质数\(R\)取模,\(n\geq m\). 答案应该等于\(\frac{n!}{m!}\phi(m!)=\frac{n!} ...
- MFC将二进制文件导入资源后释放
1.前言 前一篇笔记记录了怎么修改PE,此篇记录下如何利用自身的资源文件. 2.编程思路 获得资源句柄 - 获得资源文件大小 - 加载资源文件 - 锁定资源并获得其指针. 3.实践代码 1)编译以下代 ...
- KL散度(Kullback–Leibler divergence)
KL散度是度量两个分布之间差异的函数.在各种变分方法中,都有它的身影. 转自:https://zhuanlan.zhihu.com/p/22464760 一维高斯分布的KL散度 多维高斯分布的KL散度 ...
- python网络编程-线程队列queue
一:线程queu作用 Python中,queue是线程间最常用的交换数据的形式. 队列两个作用:一个是解耦,一个是提高效率 二:语法 1)队列的类 class queue.Queue(maxsize= ...
- java基础39 增强for循环(也叫foreach循环)
增强for循环是jdk1.5出现的新功能 1.增强for循环的作用 简化了迭代器的书写格式(注意:增强for循环底层还是使用了迭代器遍历) 2.增强for循环的格式 for(数据类型 变量名:遍历的目 ...
- No.4 selenium学习之路之iframe
查看iframe: 1.top window ——可以直接进行定位
- Sublime Text 3 web 开发常用配置
前沿 Sublime Text 是一个代码编辑器(Sublime Text 2是收费软件,但可以无限期试用),也是HTML和散文先进的文本编辑器.Sublime Text是由程序员Jon Skinne ...