
深入理解KS
一、概述
KS(Kolmogorov-Smirnov)评价指标,通过衡量好坏样本累计分布之间的差值,来评估模型的风险区分能力。
KS、AUC、PR曲线对比:
1)ks和AUC一样,都是利用TPR、FPR两个指标来评价模型的整体训练效果。
2)不同之处在于,ks取的是TPR和FPR差值的最大值,能够找到一个最优的阈值;AUC只评价了模型的整体训练效果,并没有指出如何划分类别让预估的效果达到最好,就是没有找到好的切分阈值。
3)与PR曲线相比,AUC和KS受样本不均衡的影响较小,而PR受其影响较大。(详看P-R曲线及与ROC曲线区别)
KS的曲线图走势大概如下:
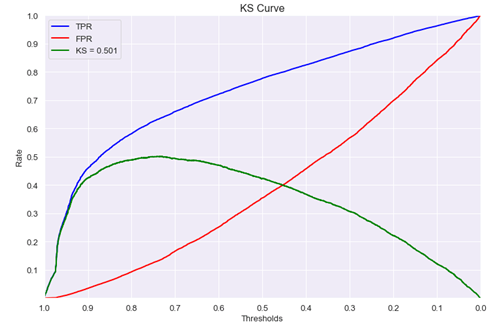
ks值<0.2,一般认为模型没有区分能力。
ks值[0.2,0.3],模型具有一定区分能力,勉强可以接受
ks值[0.3,0.5],模型具有较强的区分能力。
ks值大于0.75,往往表示模型有异常。
二、直观理解KS
1)如何直观的理解ks呢?
参考上述ks曲线图,可以这样理解,随着阈值从大逐渐的变小,TPR的提升速度高于FPR的提升速度,直到一个临界阈值threshold,之后TPR提升速度低于FPR,这个临界threshold便是最佳阈值。在前期TPR越快提升,模型效果越好;反之,FPR越快提升,模型效果就越差。
2)公式推导KS
前提假设:正负样本在当前模型下的预测值分布,都服从高斯分布。

令:
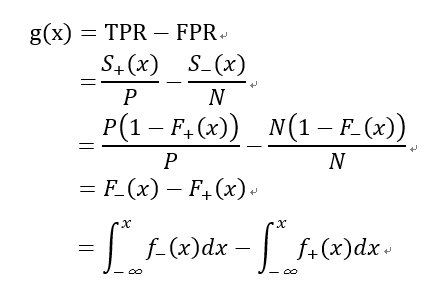
根据上述ks曲线图,可知ks曲线是一个凹函数,存在极大值,所以对g(x)求导,令其导数为0:
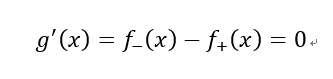
由此可知,当f-(x)=f+(x)的时候,g(x)取值最大,即为所求的KS值。
注:
g(x)表示大于阈值x情况下的TPR-FPR的值,
s+(x)表示大于阈值x情况下实际为正样本的个数
P表示正样本的总量
s-(x)表示大于阈值x情况下实际为负样本的个数
N表示负样本的总量
F+(x)表示在当前模型下实际正样本的概率分布函数,为什么要强调当前模型下,因为不同的模型对样本预测的值不一样,其概率分布也不一样。
F-(x)表示在当前模型下实际负样本的概率分布函数
f+(x)表示在当前模型下实际正样本的概率密度函数
f-(x)表示在当前模型下实际负样本的概率密度函数
3)用概率密度函数直观展示KS值
从2)公式推导中我们发现,在当前模型预测下,正负样本的概率密度函数值相等时候,KS值最大。可以利用二元分类样本数据构建模型进行验证。
我们利用《西南财经大学新网银行杯数据科学竞赛》的数据进行验证,训练数据共15000条,筛选后有效特征122个,训练集、验证集、测试集按8:1:1切分,利用xgboost构建模型后对测试集进行打分,最终ks=0.52,最优阈值=0.0539,auc=0.82。将测试集的正负样本分开,根据其预测值分别画出对应的概率密度曲线,再画出x=0.0539直线,看最优阈值线是否与两个概率密度曲线的相交处也相交。如下图:
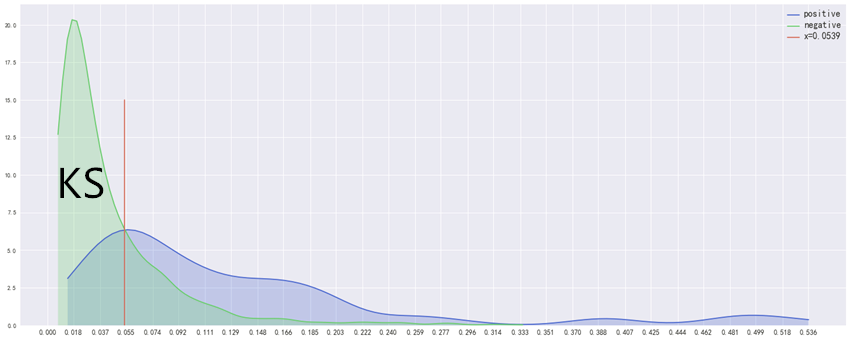
从2)中的g(x)我们知道,g(x)值等于在阈值x下,负样本<=x的概率减去正样本<=x的概率。
对应图中的概率密度曲线而言,就是在<=x条件下,绿色曲线下的面积减去蓝色去曲线下的面积。从图上也可以看出,两个分布交点处的阈值,是KS值最大对应的阈值,其KS值就等于红线左侧蓝线上方绿线下面的面积,阈值向左切或者往右切,所求面积都会变小。
红线就是我们所求的ks值最优阈值线,在图形上也与预期一致,三者相交于一点;从图中也看出ks值与正负样本比例无关系,只与模型对正负样本的预测值分布有关系。,但是如果样本量太小的话,其预测值的分布无法准确反应模型的性能,因此样本还是要达到一定数量。
另外,从正负样本预测值的概率密度函数,我们也能直观看出模型是否有效,如果模型比较有效,两个分布就会分的比较开,KS值自然比较大,所以这也是一种直观评测模型的方式。
深入理解KS的更多相关文章
- 【转】风控中的特征评价指标(三)——KS值
转自:https://zhuanlan.zhihu.com/p/79934510 风控业务背景 在风控中,我们常用KS指标来评估模型的区分度(discrimination).这也是风控模型同学最为追求 ...
- 对target="framename"的理解(实现分页的demo)
先上图,说明一下我主要想实现什么功能. 一.演示图 演示首页: 演示内容页(包括按钮切换页+模板内容页): 演示首页到演示内容页的一个演变过程:
- (翻译)理解Java当中的回调机制
原文地址:http://cleancodedevelopment-qualityseal.blogspot.com/2012/10/understanding-callbacks-with-java. ...
- uboot: 理解uboot要看哪些书
概览:
- SQL Server-聚焦深入理解死锁以及避免死锁建议(三十三)
前言 终于进入死锁系列,前面也提到过我一直对隔离级别和死锁以及如何避免死锁等问题模棱两可,所以才鼓起了重新学习SQL Server系列的勇气,本节我们来讲讲SQL Server中的死锁,看到许多文章都 ...
- java 线程 理解 解析
1 线程的概述 进程:正在运行的程序,负责了这个程序的内存分配,代表了内存中的执行区域. 线程:就是在一个进程中负者一个执行路径. 多线程:就是在一个进程中多个执行路径同时执行. 假象: 电脑上的程序 ...
- 理解OpenShift(5):从 Docker Volume 到 OpenShift Persistent Volume
理解OpenShift(1):网络之 Router 和 Route 理解OpenShift(2):网络之 DNS(域名服务) 理解OpenShift(3):网络之 SDN 理解OpenShift(4) ...
- SQL Server-聚焦深入理解死锁以及避免死锁建议(转载)
前言 终于进入死锁系列,前面也提到过我一直对隔离级别和死锁以及如何避免死锁等问题模棱两可,所以才鼓起了重新学习SQL Server系列的勇气,本节我们来讲讲SQL Server中的死锁,看到许多文章都 ...
- JUC回顾之-ConcurrentHashMap源码解读及原理理解
ConcurrentHashMap结构图如下: ConcurrentHashMap实现类图如下: segment的结构图如下: package concurrentMy.juc_collections ...
随机推荐
- LINQ to SQL和Entity Framework
LINQ to SQL和Entity Framework都是一种包含LINQ功能的对象关系映射技术. 那么为什么会有LINQ这个东西的出现呢. 简单来说LINQ是为了满足不知道怎么操作数据库的程序员开 ...
- 在动作类上加上SkipValidation 在反射时候会获取到该反射信息 就不会执行validate方法
在动作类上加上SkipValidation 在反射时候会获取到该反射信息 就不会执行validate方法
- Python之路3【第零篇】目录
Web应用框架篇 1.Web应用框架前戏
- python中OS模块操作文件和目录
在python中执行和操作目录和文件的操作是通过内置的python OS模块封装的函数实现的. 首先导入模块,并查看操作系统的类型: >>> import os os.name # ...
- 学习Spring Boot:(七)集成Mybatis
前面都是用的是spring data JPA,现在学习下Mybatis,而且现在Mybatis也像JPA那样支持注解形式了,也非常方便,学习一下. 数据库 mysql 5.7 添加依赖 在pom文件中 ...
- 《深入理解计算机系统》学习总结 Chap7
第七章 链接 链接是将各种代码和数据部分收集起来并组合成为一个单一文件的过程,这个文件可被加载(或拷贝)到存储器并执行.链接可以执行于编译时,也就是在源代码被翻译成机器代码时:也可以执行于加载时,也就 ...
- sublime_Text3中snippet设置信息头(包括作者、日期)
1.tool->new snippet(工具->新代码段) 创建一个新的snippet,并保存为author.sublime-snippet(最好在该目录(User)下再创建一个MySni ...
- python检测服务器是否ping通
好想在2014结束前再赶出个10篇博文来,~(>_<)~,不写博客真不是一个好兆头,至少说明对学习的欲望和对知识的研究都不是那么积极了,如果说这1天的时间我能赶出几篇精致的博文,你们信不信 ...
- Activiti工作流的应用示例 (官方guide项目方式)
转: Activiti工作流的应用示例 1.新建流程模型 模型管理->模型工作区 点击“创建”后会立即跳转到“流程在线设计器”页面,请参考下一节 2.在线流程设计器 模型管理->模型工作区 ...
- Chapter12(动态内存)--C++Prime笔记
1.分配再静态或栈内存中的对象由编译器自动创建销毁. 2.C++中动态内存的管理是通过 new:前者为对象非配空间并返回一个指向该对象的指针. delete:接受一个动态对象的指针,摧毁该对象,并释放 ...