
python 面对post分页爬虫
分享一则对于网抓中面对post请求访问的页面或者在分页过程中需要post请求才可以访问的内容!
面的post请求的网址是不可以零参访问网址的,所以我们在网抓的过程中需要给请求传表单数据,下面看一下网页中post请求的网址:

post请求状态码和get请求的状态码一致,但是在参数中我们可以看到表单数据有很多的参数:
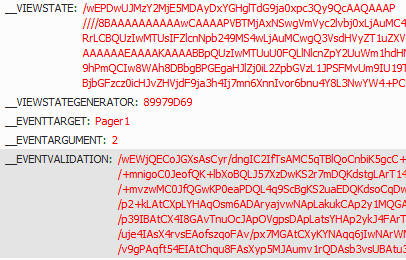
其中的__VIEWSTATE是必须要传的参数,而这个参数是在源码中能获取到的,这个__VIEWSTATE是asp.net中特有的,所以只有在访问asp.net的网站的时候这个参数是必须传的,其他的网站,只要有参数变化的表单数据就需要传到post请求中!
我们在转页的过程中会看到类似于这样的 表单,那后面的数字就是我们转页后的页码!所以我们的这个参数也要传,获取转页的页码的总数,同样可以在源码中获取,如果只显示了1234页,那就需要计算你需要的内容有多少个,每一页的内容个数,做一个取余算法就可以算出来了!
现在定义一个post_data:
post_data={"__EVENTTARGET":"Pager1","__EVENTARGUMENT":page_num,"ddlManufacturer":"","Pager1_input":str(page_num-1)}
这是我自定义的post参数,page_num代表着分页的页码。
__VIEWSTATE是在源码中,这里分享的是xpath方法:
 a = doc.xpath('//input[@id="__VIEWSTATE"]')

 if len(a) > 0:

     post_data['__VIEWSTATE'] = a[0].get('value')
使用BeautifulSoup就是:
 soup = BeautifulSoup(h,"html.parser")

 a = soup.find('input',id='__VIEWSTATE')

 if a:

     post_data['__VIEWSTATE'] = a['value']
获取到重要的表单数据后,我们就只需要传参访问网页源码了!
 r2 = requests.post(url,data=post_data,headers=headers,timeout=20)

 ht2 = r2.content  #这里就是访问的网页源码!
xpath的解析代码: doc2 = HTML.document_fromstring(网页源码)
网页的简单post请求就是这样来传递参数,访问的!我自己还有很多的学习资料分享在607021567qq群里面了!还有微信飞机大战的源代码分享!
python 面对post分页爬虫的更多相关文章
- Python初学者之网络爬虫(二)
声明:本文内容和涉及到的代码仅限于个人学习,任何人不得作为商业用途.转载请附上此文章地址 本篇文章Python初学者之网络爬虫的继续,最新代码已提交到https://github.com/octans ...
- 零基础入门Python实战:四周实现爬虫网站 Django项目视频教程
点击了解更多Python课程>>> 零基础入门Python实战:四周实现爬虫网站 Django项目视频教程 适用人群: 即将毕业的大学生,工资低工作重的白领,渴望崭露头角的职场新人, ...
- Python - 面对对象(进阶)
目录 Python - 面对对象(进阶) 类的成员 一. 字段 二. 方法 三. 属性 类的修饰符 类的特殊成员 Python - 面对对象(进阶) 类的成员 一. 字段 字段包括:普通字段和静态字段 ...
- 【Python】:简单爬虫作业
使用Python编写的图片爬虫作业: #coding=utf-8 import urllib import re def getPage(url): #urllib.urlopen(url[, dat ...
- 使用python/casperjs编写终极爬虫-客户端App的抓取-ZOL技术频道
使用python/casperjs编写终极爬虫-客户端App的抓取-ZOL技术频道 使用python/casperjs编写终极爬虫-客户端App的抓取
- [Python学习] 简单网络爬虫抓取博客文章及思想介绍
前面一直强调Python运用到网络爬虫方面很有效,这篇文章也是结合学习的Python视频知识及我研究生数据挖掘方向的知识.从而简介下Python是怎样爬去网络数据的,文章知识很easy ...
- 洗礼灵魂,修炼python(69)--爬虫篇—番外篇之feedparser模块
feedparser模块 1.简介 feedparser是一个Python的Feed解析库,可以处理RSS ,CDF,Atom .使用它我们可从任何 RSS 或 Atom 订阅源得到标题.链接和文章的 ...
- 洗礼灵魂,修炼python(50)--爬虫篇—基础认识
爬虫 1.什么是爬虫 爬虫就是昆虫一类的其中一个爬行物种,擅长爬行. 哈哈,开玩笑,在编程里,爬虫其实全名叫网络爬虫,网络爬虫,又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者 ...
- 使用Python + Selenium打造浏览器爬虫
Selenium 是一款强大的基于浏览器的开源自动化测试工具,最初由 Jason Huggins 于 2004 年在 ThoughtWorks 发起,它提供了一套简单易用的 API,模拟浏览器的各种操 ...
随机推荐
- win10 UWP 你写我读
想要电脑读出我们写的内容,在win10,很简单 其实这个技术在windows7就有了,但是现在win10让写出一个你写我读的软件很简单. 我们需要一个类MediaElement来播放,因为window ...
- HiveQL简单操作DDL
hive-2.1.1 DDL操作 Create/Drop/Alter/Use Database 创建数据库 //官方指导 CREATE (DATABASE|SCHEMA) [IF NOT EXISTS ...
- 如何利用Oracle VM Templates 在几分钟内部署Oracle Real Application Clusters (RAC)
本文未经授权,禁止一切形式的转载.如果对本文有任何疑问可以通过以下方式和我交流: 邮箱: jiangxinnju@163.com 博客园地址: http://www.cnblogs.com/jiang ...
- JS难点--组件开发
p.p1 { margin: 0.0px 0.0px 0.0px 0.0px; font: 15.0px Consolas; color: #a5b2b9 } span.Apple-tab-span ...
- LeetCode 59. Spiral Matrix II (螺旋矩阵之二)
Given an integer n, generate a square matrix filled with elements from 1 to n2 in spiral order. For ...
- Mysql 用户,权限管理的几点理解。
前两天项目数据库要移植到mysql,为此临时抓了几天很久没用的mysql. 公司的数据库比较简单,从oracle迁移到mysql很简单,但是,中间的权限管理让我感觉既简单又复杂..简单是因为网上关于m ...
- Ubuntu16.04卸载opencv2.4.9并安装opencv3.2.0+contrib
本文为作者原创,转载请注明出处(http://www.cnblogs.com/mar-q/)by 负赑屃 需要用到opencv中的surf和sift算法,机器上只有opencv3.2,没有扩展包,于是 ...
- .xlsx文件总是默认用2007 Microsoft Office component 打开,且无法更改用EXCEL打开的解决方法
之前装了OFFICE2003,后来改装了 OFFICE2007,之后XLSX文件双击总是用2007 Microsoft Office component 打开,导致无法打开. 解决方法: 打开注册表R ...
- Java企业微信开发_Exception_02_java.security.InvalidKeyException: Illegal key size
今天换了重新装了一个jdk,然后运行昨天还好好的企业微信工程,结果启动的时候就给我报了这么个错: java.security.InvalidKeyException: Illegal key size ...
- web消息推送-goesay
原文:http://www.upwqy.com/details/22.html 1 GoEasy简介: GoEasy - Web实时消息推送服务专家 最简单的方式将消息从服务器端推送至客户端 最简单的 ...