
ES系列十三、Elasticsearch Suggester API(自动补全)
1.概念
1.补全api主要分为四类
- Term Suggester(纠错补全,输入错误的情况下补全正确的单词)
- Phrase Suggester(自动补全短语,输入一个单词补全整个短语)
- Completion Suggester(完成补全单词,输出如前半部分,补全整个单词)
- Context Suggester(上下文补全)
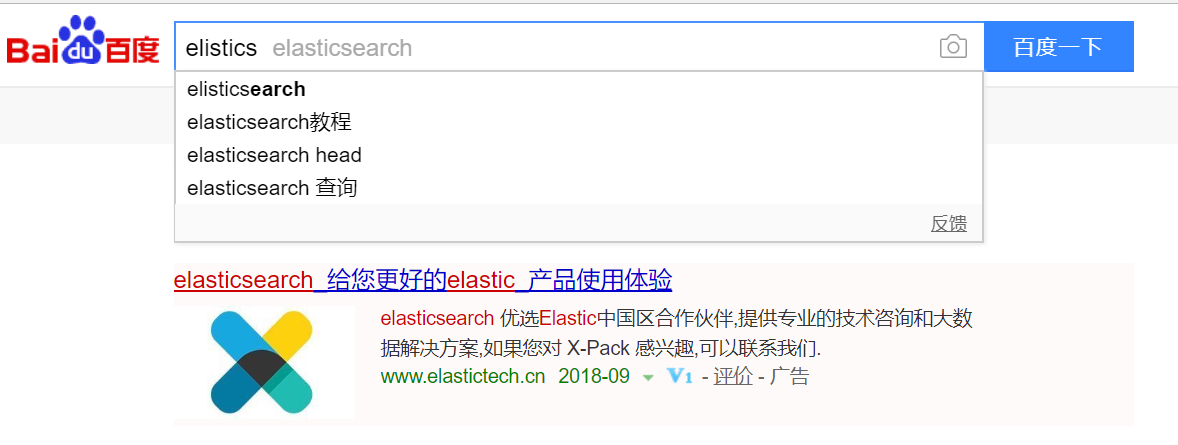
整体效果类似百度搜索,如图:
2.Term Suggester(纠错补全)
2.1.api
1.建立索引
PUT /book4

{

  "mappings": {

    "english": {

      "properties": {

        "passage": {

          "type": "text"

        }

      }

    }

  }

}
2.插入数据
curl -H "Content-Type: application/json" -XPOST 'http:localhost:9200/_bulk' -d'

{ "index" : { "_index" : "book4", "_type" : "english" } }

{ "passage": "Lucene is cool"}

{ "index" : { "_index" : "book4", "_type" : "english" } }

{ "passage": "Elasticsearch builds on top of lucene"}

{ "index" : { "_index" : "book4", "_type" : "english" } }

{ "passage": "Elasticsearch rocks"}

{ "index" : { "_index" : "book4", "_type" : "english" } }

{ "passage": "Elastic is the company behind ELK stack"}

{ "index" : { "_index" : "book4", "_type" : "english" } }

{ "passage": "elk rocks"}

{ "index" : { "_index" : "book4", "_type" : "english" } }

{  "passage": "elasticsearch is rock solid"}

'
3.看下储存的分词有哪些
post /_analyze

{

  "text": [

    "Lucene is cool",

    "Elasticsearch builds on top of lucene",

    "Elasticsearch rocks",

    "Elastic is the company behind ELK stack",

    "elk rocks",

    "elasticsearch is rock solid"

  ]

}
结果:
{

    "tokens": [

        {

            "token": "lucene",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "is",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "cool",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "elasticsearch",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "builds",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "on",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "top",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "of",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "lucene",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "elasticsearch",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "rocks",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "elastic",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "is",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "the",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "company",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "behind",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "elk",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "stack",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "elk",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "rocks",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "elasticsearch",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "is",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "rock",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        },

        {

            "token": "solid",

            "start_offset": ,

            "end_offset": ,

            "type": "<ALPHANUM>",

            "position":

        }

    ]

}
4.term suggest api(搜索单个字段)
搜索下试试,给出错误单词Elasticsearaach
POST /book4/_search

{

    "suggest" : {

    "my-suggestion" : {

      "text" : "Elasticsearaach",

      "term" : {

        "field" : "passage",
     "suggest_mode": "popular"

      }

    }

  }

}
response:
{

    "took": ,

    "timed_out": false,

    "_shards": {

        "total": ,

        "successful": ,

        "skipped": ,

        "failed":

    },

    "hits": {

        "total": ,

        "max_score": ,

        "hits": []

    },

    "suggest": {

        "my-suggestion": [

            {

                "text": "elasticsearaach",

                "offset": ,

                "length": ,

                "options": [

                    {

                        "text": "elasticsearch",

                        "score": 0.84615386,

                        "freq": 3

                    }

                ]

            }

        ]

    }

}
5.搜索多个字段分别给出提示:
POST _search

{

  "suggest": {

    "my-suggest-1" : {

      "text" : "tring out Elasticsearch",

      "term" : {

        "field" : "message"

      }

    },

    "my-suggest-2" : {

      "text" : "kmichy",

      "term" : {

        "field" : "user"

      }

    }

  }

}
该term建议者提出基于编辑距离条款。在建议术语之前分析提供的建议文本。建议的术语是根据分析的建议文本标记提供的。该term建议者不走查询到的是是的请求部分。
常见建议选项:
|
|
建议文字。建议文本是必需的选项,需要全局或按建议设置。 |
|
|
从中获取候选建议的字段。这是一个必需的选项,需要全局设置或根据建议设置。 |
|
|
用于分析建议文本的分析器。默认为建议字段的搜索分析器。 |
|
|
每个建议文本标记返回的最大更正。 |
|
|
定义如何根据建议文本术语对建议进行排序。两个可能的值:
|
|
|
建议模式控制包含哪些建议或控制建议的文本术语,建议。可以指定三个可能的值:
|
其他术语建议选项:
|
|
在文本分析之后,建议文本术语小写。 |
|
|
最大编辑距离候选建议可以具有以便被视为建议。只能是介于1和2之间的值。任何其他值都会导致抛出错误的请求错误。默认为2。 |
|
|
必须匹配的最小前缀字符的数量才是候选建议。默认为1.增加此数字可提高拼写检查性能。通常拼写错误不会出现在术语的开头。(旧名“prefix_len”已弃用) |
|
|
建议文本术语必须具有的最小长度才能包含在内。默认为4.(旧名称“min_word_len”已弃用) |
|
|
设置从每个单独分片中检索的最大建议数。在减少阶段,仅根据 |
|
|
用于乘以的因子, |
|
|
建议应出现的文档数量的最小阈值。可以指定为绝对数字或文档数量的相对百分比。这可以仅通过建议高频项来提高质量。默认为0f且未启用。如果指定的值大于1,则该数字不能是小数。分片级文档频率用于此选项。 |
|
|
建议文本令牌可以存在的文档数量的最大阈值,以便包括在内。可以是表示文档频率的相对百分比数(例如0.4)或绝对数。如果指定的值大于1,则不能指定小数。默认为0.01f。这可用于排除高频术语的拼写检查。高频术语通常拼写正确,这也提高了拼写检查的性能。分片级文档频率用于此选项。 |
|
|
用于比较类似建议术语的字符串距离实现。可以指定五个可能的值: |
2.phase sguesster:短语纠错
phrase 短语建议,在term的基础上,会考量多个term之间的关系,比如是否同时出现在索引的原文里,相邻程度,以及词频等
示例1:
POST book4/_search
"text": "Elasticsearch rock",
"phrase": {
"field": "passage"
}
}
}
}
{

    "took": ,

    "timed_out": false,

    "_shards": {

        "total": ,

        "successful": ,

        "skipped": ,

        "failed":

    },

    "hits": {

        "total": ,

        "max_score": ,

        "hits": []

    },

    "suggest": {

        "myss": [

            {

                "text": "Elasticsearch rock",

                "offset": ,

                "length": ,

                "options": [

                    {

                        "text": "elasticsearch rocks",

                        "score": 0.3467123

                    }

                ]

            }

        ]

    }

}
3. Completion suggester 自动补全
针对自动补全场景而设计的建议器。此场景下用户每输入一个字符的时候,就需要即时发送一次查询请求到后端查找匹配项,在用户输入速度较高的情况下对后端响应速度要求比较苛刻。因此实现上它和前面两个Suggester采用了不同的数据结构,索引并非通过倒排来完成,而是将analyze过的数据编码成FST和索引一起存放。对于一个open状态的索引,FST会被ES整个装载到内存里的,进行前缀查找速度极快。但是FST只能用于前缀查找,这也是Completion Suggester的局限所在。
1.建立索引
POST /book5

{

    "mappings": {

        "music" : {

            "properties" : {

                "suggest" : {

                    "type" : "completion"

                },

                "title" : {

                    "type": "keyword"

                }

            }

        }

    }

}
插入数据:
POST /book5/music

{

    "suggest":"test my book"

}
Input 指定输入词 Weight 指定排序值(可选)
PUT music/music/5nupmmUBYLvVFwGWH3cu?refresh

{

    "suggest" : {

        "input": [ "test", "book" ],

        "weight" :

    }

}
指定不同的排序值:
PUT music/_doc/6Hu2mmUBYLvVFwGWxXef?refresh

{

    "suggest" : [

        {

            "input": "test",

            "weight" :

        },

        {

            "input": "good",

            "weight" :

        }

    ]}
示例1:查询建议根据前缀查询
POST book5/_search?pretty

{

    "suggest": {

        "song-suggest" : {

            "prefix" : "te",

            "completion" : {

                "field" : "suggest"

            }

        }

    }

}
{

    "took": ,

    "timed_out": false,

    "_shards": {

        "total": ,

        "successful": ,

        "skipped": ,

        "failed":

    },

    "hits": {

        "total": ,

        "max_score": ,

        "hits": []

    },

    "suggest": {

        "song-suggest": [

            {

                "text": "te",

                "offset": ,

                "length": ,

                "options": [

                    {

                        "text": "test my book1",

                        "_index": "book5",

                        "_type": "music",

                        "_id": "6Xu6mmUBYLvVFwGWpXeL",

                        "_score": ,

                        "_source": {

                            "suggest": "test my book1"

                        }

                    },

                    {

                        "text": "test my book1",

                        "_index": "book5",

                        "_type": "music",

                        "_id": "6nu8mmUBYLvVFwGWSndC",

                        "_score": ,

                        "_source": {

                            "suggest": "test my book1"

                        }

                    },

                    {

                        "text": "test my book1 english",

                        "_index": "book5",

                        "_type": "music",

                        "_id": "63u8mmUBYLvVFwGWZHdC",

                        "_score": ,

                        "_source": {

                            "suggest": "test my book1 english"

                        }

                    }

                ]

            }

        ]

    }

}
示例2:对建议查询结果去重
{

    "suggest": {

        "song-suggest" : {

            "prefix" : "te",

            "completion" : {

                "field" : "suggest" ,

                 "skip_duplicates": true

            }

        }

    }

}
示例3:查询建议文档存储短语
POST /book5/music/63u8mmUBYLvVFwGWZHdC?refresh

{

    "suggest" : {

        "input": [ "book1 english", "test english" ],

        "weight" :

    }

}
查询:
POST book5/_search?pretty

{

    "suggest": {

        "song-suggest" : {

            "prefix" : "test",

            "completion" : {

                "field" : "suggest" ,

                "skip_duplicates": true

            }

        }

    }

}
结果:
{

    "took": ,

    "timed_out": false,

    "_shards": {

        "total": ,

        "successful": ,

        "skipped": ,

        "failed":

    },

    "hits": {

        "total": ,

        "max_score": ,

        "hits": []

    },

    "suggest": {

        "song-suggest": [

            {

                "text": "test",

                "offset": ,

                "length": ,

                "options": [

                    {

                        "text": "test english",

                        "_index": "book5",

                        "_type": "music",

                        "_id": "63u8mmUBYLvVFwGWZHdC",

                        "_score": ,

                        "_source": {

                            "suggest": {

                                "input": [

                                    "book1 english",

                                    "test english"

                                ],

                                "weight":

                            }

                        }

                    },

                    {

                        "text": "test my book1",

                        "_index": "book5",

                        "_type": "music",

                        "_id": "6Xu6mmUBYLvVFwGWpXeL",

                        "_score": ,

                        "_source": {

                            "suggest": "test my book1"

                        }

                    }

                ]

            }

        ]

    }

}
4. 总结和建议
因此用好Completion Sugester并不是一件容易的事,实际应用开发过程中,需要根据数据特性和业务需要,灵活搭配analyzer和mapping参数,反复调试才可能获得理想的补全效果。
回到篇首搜索框的补全/纠错功能,如果用ES怎么实现呢?我能想到的一个的实现方式:
- 在用户刚开始输入的过程中,使用Completion Suggester进行关键词前缀匹配,刚开始匹配项会比较多,随着用户输入字符增多,匹配项越来越少。如果用户输入比较精准,可能Completion Suggester的结果已经够好,用户已经可以看到理想的备选项了。
- 如果Completion Suggester已经到了零匹配,那么可以猜测是否用户有输入错误,这时候可以尝试一下Phrase Suggester。
- 如果Phrase Suggester没有找到任何option,开始尝试term Suggester。
精准程度上(Precision)看: Completion > Phrase > term, 而召回率上(Recall)则反之。从性能上看,Completion Suggester是最快的,如果能满足业务需求,只用Completion Suggester做前缀匹配是最理想的。 Phrase和Term由于是做倒排索引的搜索,相比较而言性能应该要低不少,应尽量控制suggester用到的索引的数据量,最理想的状况是经过一定时间预热后,索引可以全量map到内存。
ES系列十三、Elasticsearch Suggester API(自动补全)的更多相关文章
- 【Qt编程】基于Qt的词典开发系列<十四>自动补全功能
最近写了一个查单词的类似有道词典的软件,里面就有一个自动补全功能(即当你输入一个字母时,就会出现几个候选项).这个自动补全功能十分常见,百度搜索关键词时就会出现.不过它们这些补全功能都是与你输入的进行 ...
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
- 四十七 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.elastic.co/guide/en/elasticsearch/reference/current/se ...
- java整合Elasticsearch,实现crud以及高级查询的分页,范围,排序功能,泰文分词器的使用,分组,最大,最小,平均值,以及自动补全功能
//为index创建mapping,index相当于mysql的数据库,数据库里的表也要给各个字段创建类型,所以index也要给字段事先设置好类型: 使用postMan或者其他工具创建:(此处我使用p ...
- kubernetes系列(小知识):kubectl命令自动补全
kubectl命令自动补全 linux系统 yum install -y bash-completion source /usr/share/bash-completion/completions/d ...
- bootstrap - typeahead自动补全插件
$('#Sale').typeahead({ ajax: { url: '@Url.Action("../Contract/GetSale")', //timeout: 300, ...
- Visual Studio Code使用typings拓展自动补全功能
转自:http://blog.csdn.net/liyijun4114/article/details/51658087 参考来源: 官方介绍: https://code.visualstudio.c ...
- StringBoot整合ELK实现日志收集和搜索自动补全功能(详细图文教程)
@ 目录 StringBoot整合ELK实现日志收集和搜索自动补全功能(详细图文教程) 一.下载ELK的安装包上传并解压 1.Elasticsearch下载 2.Logstash下载 3.Kibana ...
- jQuery AutoComplete 自动补全
jQuery.AutoComplete是一个基于jQuery的自动补全插件.借助于jQuery优秀的跨浏览器特性,可以兼容Chrome/IE/Firefox/Opera/Safari等多种浏览器. 特 ...
随机推荐
- SharePoint 2007 页面及用户控件
页面: <%@ Assembly Name="HP.EUSM.Self-ServiceUpgradeQuota.SPCustomAction, Version=1.0.0.0, Cul ...
- 洛谷 P1337 [JSOI2004]平衡点 / 吊打XXX 解题报告
P1337 [JSOI2004]平衡点 / 吊打XXX 题目描述 有 \(n\) 个重物,每个重物系在一条足够长的绳子上.每条绳子自上而下穿过桌面上的洞,然后系在一起.\(X\)处就是公共的绳结.假设 ...
- 牛客练习赛 小D的剑阵 解题报告
小D的剑阵 题意链接: https://ac.nowcoder.com/acm/contest/369/F 来源:牛客网 现在你有 \(n\) 把灵剑,其中选择第i把灵剑会得到的 \(w_i\) 攻击 ...
- Luogu 1351 NOIP 2014 联合权值(贪心,计数原理)
Luogu 1351 NOIP 2014 联合权值(贪心,计数原理) Description 无向连通图 G 有 n 个点,n-1 条边.点从 1 到 n 依次编号,编号为 i 的点的权值为 Wi, ...
- Flash:使用FileReference上传在Firefox上遇到的问题终于解决了
以前使用的是这样的一句话:var uploadURL:URLRequest = new URLRequest();uploadURL.url = "upload.asp"; 测试发 ...
- poj1185炮兵阵地 正确代码及错误代码分析
Solution:状态压缩 因为设置炮兵的局限性(同行两炮兵相差要大于2),一行10个数最多有60种可能性(程序计算) 其中判断可能性的好方法是: if ((i & (i << 1 ...
- js中if()条件中变量为false的情况
<html> <head> <script type="text/javascript" src="jquery-3.1.1.min.js& ...
- js动画最佳实现——requestAnimationFrame
我们经常用setInterval来实现动画,其实这种做法不是太好,因为不同浏览器的刷新频率也不一样(一般认为设置16为最佳,按每秒60帧算,1000/60≍16.67) var dis = 0,tim ...
- 8、Python-函数
定义 def printInfo(): print("人生苦短,我用Python") 调用 def printInfo(): print("人生苦短,我用Python&q ...
- 在 chrome 上导出 pdf
用html+css写出网页,然后在chrome上导出pdf 1. command + p:快捷呼出打印: 2. “目标打印机”:选择“更改”,之后选择“另存为PDF”: 3. 点“更多设置”,可以勾选 ...