
【Hadoop】大数据时代,我们为什么使用hadoop
博客已转移,请借一步说话。http://www.daniubiji.cn/archives/538
我们先来看看大数据时代,
什么叫大数据,“大”,说的并不仅是数据的“多”!不能用数据到了多少TB ,多少PB 来说。
对于大数据,可以用四个词来表示:大量,多样,实时,不确定。
也就是数据的量庞大,数据的种类繁杂多样话,数据的变化飞快,数据的真假存疑。
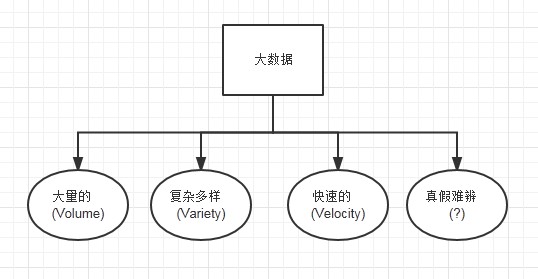
大量:这个大家都知道,想百度,淘宝,腾讯,Facebook,Twitter等网站上的一些信息,这肯定算是大数据了,都要存储下来。
多样:数据的多样性,是说数据可能是结构型的数据,也可能是非结构行的文本,图片,视频,语音,日志,邮件等。
实时:大数据需要快速的,实时的进行处理。如果说对时间要求低,那弄几个机器,对小数据进行处理,等个十天半月的出来结果,这样也没有什么意义了。
不确定: 数据是存在真伪的,各种各样的数据,有的有用,有的没用。很难辨析。
根据以上的特点,我们需要一个东西,来:
1存储大量数据
2快速的处理大量数据
3从大量数据中进行分析
于是就有了这样一个模型hadoop。
hadoop的历史就不说了。先来看看模型。

这就相当于一个生态系统,或者可以看成一个操作系统XP,win7.
HDFS和MapReduce为操作系统的核心,Hive,Pig,Mathout,Zookeeper,Flume,Sqoop,HBase等,都是操作系统上的一些软件,或应用。
HDFS:(Hadoop Distributed File System),Hadoop分布式文件系统。从名字上就看出了它的两点功能。
基本功能,存文件,是一个文件系统;另外这个文件系统是分布式的;
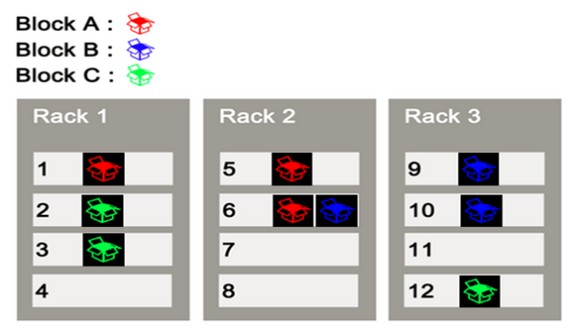
从图上来看,HDFS的简单原理。
Rack1,Rack2,Rack3是三个机架;
1,2,3,4,5,6,7,8,9,10,11,12 是机架上的十二台服务器。
Block A, Block B, Block C为三个信息块,也就是要存的数据。
从整体布局上来看,信息块被分配到机架上。看似很均匀。这样分配的目的,就是备份,防止某一个机器宕机后,单点故障的发生。
MapReduce,(Map + Reduce),就看成是计算的功能。可以对数据进行处理。
它加快了计算。主要也是通过上图的布局。将数据分布到多个服务器上。当有任务了,比如查询,或者比较大小,先让每台服务器,都处理自己的存储中文件。然后再将所有服务器的处理结果进行第二次处理。最后将结果返回。
其实,hadoop还有一点好处,就是省钱。
框架开源的,免费的,服务器也不用特别牛X的。
省钱才是硬道理。
另外,从别的资料看到一种解释mapreduce的方式,很简单
Goal: count the number of books in the library.
Map: You count up shelf #1, I count up shelf #2.
(The more people we get, the faster this part goes. )
Reduce: We all get together and add up our individual counts.
【Hadoop】大数据时代,我们为什么使用hadoop的更多相关文章
- 数据仓库和Hadoop大数据平台有什么差别?
广义上来说,Hadoop大数据平台也可以看做是新一代的数据仓库系统, 它也具有很多现代数据仓库的特征,也被企业所广泛使用.因为MPP架构的可扩展性,基于MPP的数据仓库系统有时候也被划分到大数据平台类 ...
- 大数据时代快速SQL引擎-Impala
背景 随着大数据时代的到来,Hadoop在过去几年以接近统治性的方式包揽的ETL和数据分析查询的工作,大家也无意间的想往大数据方向靠拢,即使每天数据也就几十.几百M也要放到Hadoop上作分析,只会适 ...
- 转:大数据时代快速SQL引擎-Impala
本文来自:http://blog.csdn.net/yu616568/article/details/52431835 如有侵权 可立即删除 背景 随着大数据时代的到来,Hadoop在过去几年以接近统 ...
- 大数据时代之hadoop(五):hadoop 分布式计算框架(MapReduce)
大数据时代之hadoop(一):hadoop安装 大数据时代之hadoop(二):hadoop脚本解析 大数据时代之hadoop(三):hadoop数据流(生命周期) 大数据时代之hadoop(四): ...
- 大数据时代,我们为什么使用hadoop
大数据时代,我们为什么使用hadoop 我们先来看看大数据时代, 什么叫大数据,“大”,说的并不仅是数据的“多”!不能用数据到了多少TB ,多少PB 来说. 对于大数据,可以用四个词来表示:大量,多样 ...
- 大数据项目实践:基于hadoop+spark+mongodb+mysql+c#开发医院临床知识库系统
一.前言 从20世纪90年代数字化医院概念提出到至今的20多年时间,数字化医院(Digital Hospital)在国内各大医院飞速的普及推广发展,并取得骄人成绩.不但有数字化医院管理信息系统(HIS ...
- 【大数据】Summingbird(Storm + Hadoop)的demo运行
一.前言 为了运行summingbird demo,笔者走了很多的弯路,并且在国内基本上是查阅不到任何的资料,耗时很久才搞定了demo的运行.真的是一把辛酸泪,有兴趣想要研究summingbird的园 ...
- hadoop大数据技术架构详解
大数据的时代已经来了,信息的爆炸式增长使得越来越多的行业面临这大量数据需要存储和分析的挑战.Hadoop作为一个开源的分布式并行处理平台,以其高拓展.高效率.高可靠等优点越来越受到欢迎.这同时也带动了 ...
- 大数据框架:Spark vs Hadoop vs Storm
大数据时代,TB级甚至PB级数据已经超过单机尺度的数据处理,分布式处理系统应运而生. 知识预热 「专治不明觉厉」之“大数据”: 大数据生态圈及其技术栈: 关于大数据的四大特征(4V) 海量的数据规模( ...
随机推荐
- JAVA之路(一)
距离做下复习JAVA并学好JAVA的决定已经过去一周了,我买了慕课网的JAVA入门视频,在图书馆借了三本关于JAVA的书——两本是JAVA入门经典,一本是JAVA WEB开发宝典.我的计划是短时间内复 ...
- [并查集] How Many Tables
题目描述 Today is Ignatius' birthday. He invites a lot of friends. Now it's dinner time. Ignatius wants ...
- 安装DHCP 服务器 指的是由服务器控制一段IP地址范围,客户机登录服务器时就可以自动获得服务器分配的IP地址和子网掩码
DHCP服务详解 前言:动态主机配置协议,给局域网内的主机分配IP地址,子网掩码,网关,DNS ARP协议 arp: address resolveing protocol (地址解析协议) 实现:I ...
- MAVEN项目标准目录结构 ;
http://blog.csdn.net/lengyue_wy/article/details/6718637 版权声明:本文为博主原创文章,未经博主允许不得转载. 1.标准目录结构: src ...
- python接口自动化测试框架实现之操作mysq数据库
python操作mysql数据库需要使用到mysqlclient库. 安装:pip install mysqlclient python连接mysql数据库分以下步骤: 1.与mysql建立连接: 2 ...
- 转载-C++ vector 用法
转自:http://www.cnblogs.com/wang7/archive/2012/04/27/2474138.html 在c++中,vector是一个十分有用的容器,下面对这个容器做一下总结. ...
- Android性能测试工具:Emmagee介绍
简介 Emmagee是监控指定被测应用在使用过程中占用机器的CPU.内存.流量资源的性能测试小工具.该工具的优势在于如同windows系统性能监视器类似,它提供的是数据采集的功能,而行为则基于用户真实 ...
- bzoj5039:[Jsoi2014]序列维护
做做bzoj上的新题(不存在的) 同bzoj1798: [Ahoi2009]维护序列,样例都一样的...我能想象到的唯一的新的考察意义就是模数是2e9不是1e9,于是加法的时候需要转long long ...
- 【JavaScript&jQuery】单选框radio,复选框checkbox,下拉选择框select
HTML: <!DOCTYPE html> <html> <head> <title></title> <meta charset=& ...
- BZOJ2716:[Violet 3]天使玩偶——题解
http://www.lydsy.com/JudgeOnline/problem.php?id=2716 样例输入 2 31 12 32 1 21 3 32 4 2 样例输出 1 2 ———————— ...