
一图看懂Hadoop中的MapReduce与Spark的区别:从单机数据系统到分布式数据系统经历了哪些?
今日博主思考了一个问题:Hadoop中的MapReduce与Spark他们之间到底有什么关系?
直到我看到了下面这张图
废话不多说先上图
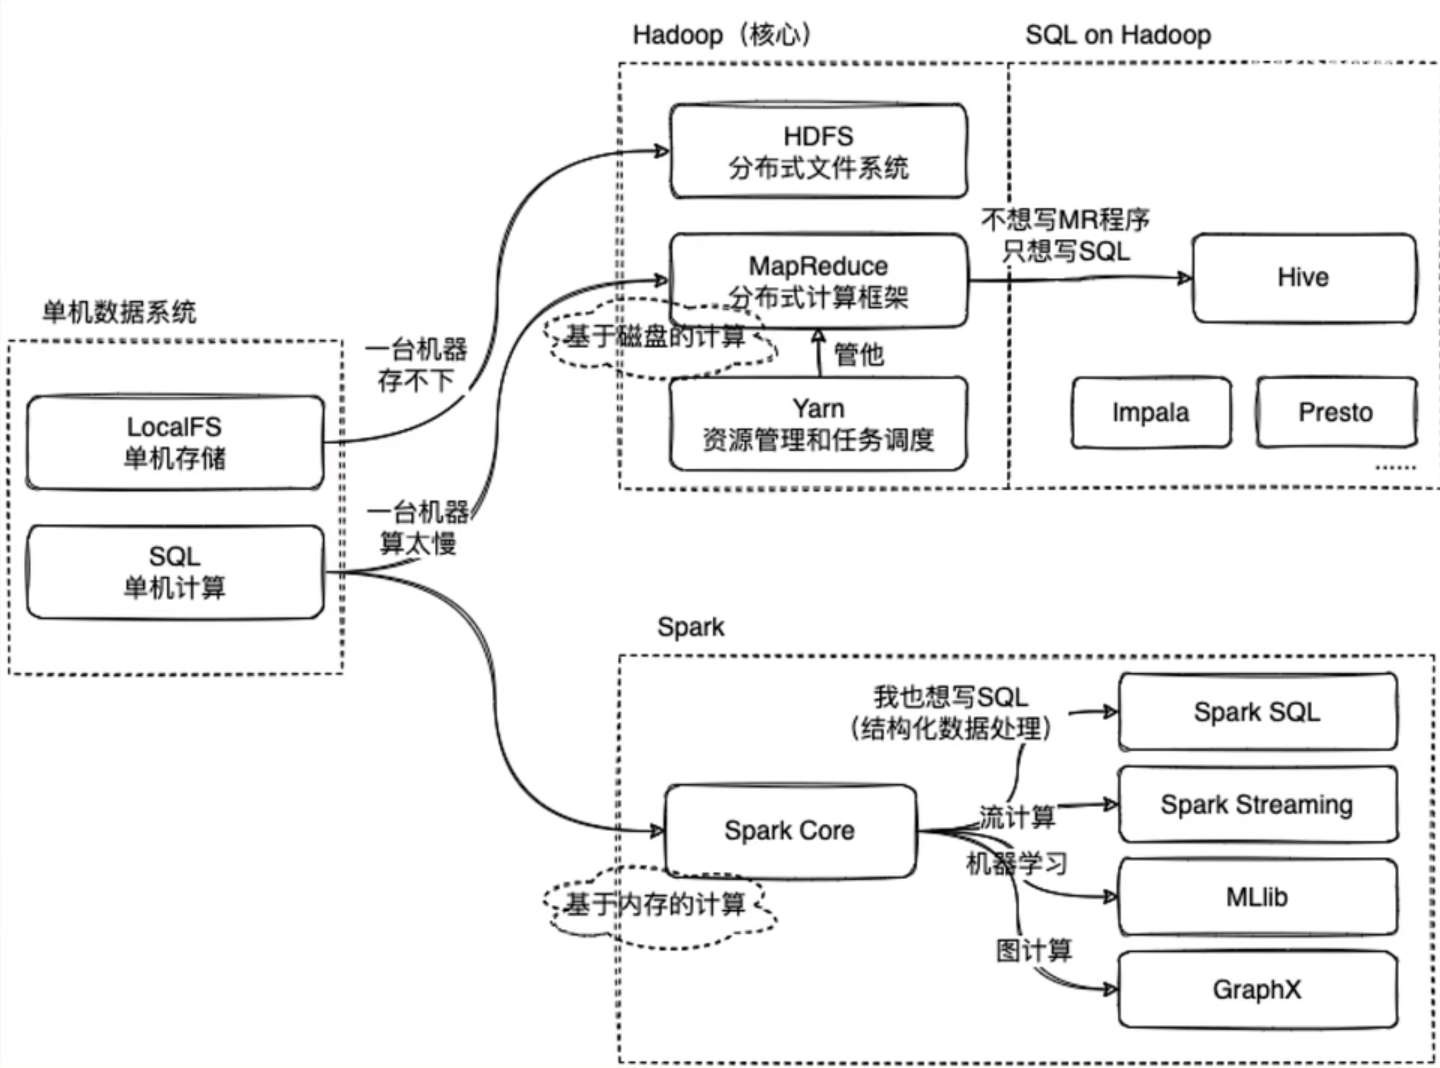
我们知道,单机数据系统,在本地主机上针对数据有单机本地存储操作(localFS)和单机计算操作(SQL)
这是在数据量比较小方便在一台主机就完成任务的情况。
那当我们的业务需要的数据足够大,一台机器完全应付不过来的时候应该怎么办?
我们很容易想到,既然一台机器办不到的事情,我们就交给10台机器、100台机器去办。
没错!
当我们的数据量足够庞大时,我们需要多台机器协同完成业务,此时我们就需要将数据一份份分成足够让一台机器能处理运行的小部分,布置给多台机器共同完成,这就是所谓的分布式数据系统
Hadoop就是为这样的业务场景服务的
Apache Hadoop是一款支持数据密集型分布式应用程序并以Apache 2.0许可协议发布的开源软件框架,有助于使用许多计算机组成的网络来解决数据、计算密集型的问题。基于MapReduce计算模型,它为大数据的分布式存储与处理提供了一个软件框架。所有的Hadoop模块都有一个基本假设,即硬件故障是常见情况,应该由框架自动处理。————wikipedia
Apache Hadoop的核心模块分为存储和计算模块,前者被称为Hadoop分布式文件系统(HDFS),后者即MapReduce计算模型。Hadoop框架先将文件分成数据块并分布式地存储在集群的计算节点中,接着将负责计算任务的代码传送给各节点,让其能够并行地处理数据。这种方法有效利用了数据局部性,令各节点分别处理其能够访问的数据。与传统的超级计算机架构相比,这使得数据集的处理速度更快、效率更高。
其中HDFS分布式文件系统做到了利用多台机器的分布式文件存储,而MapReduce则实现了对数据的计算,而我们还需要一个对他们实现调度管理的“帮手”——Yarn
Mapreduce的实现需要自己编写计算框架,这很麻烦。
所以为什么不能有像单机数据系统的SQL一样方便的操作呢?
于是Hive就诞生了。
那,Spark又是怎么回事?
Spark对标的是Hadoop中的计算模块MapReduce,而一般情况下Spark会比MapReduce快2~3倍,
这是因为,MapReduce是基于磁盘的计算,而Spark是基于内存的计算。
而Spark中也有像Hive一样为了方便而诞生的只用写SQL语句就能完成数据处理的方式——Spark SQL
在Spark中还有一些格外的功能,例如针对机器学习使用的Spark MLib、针对流计算的Spark streaming以及针对图计算的Spark GraphX等等
以上就是Hadoop中的MapReduce与Spark 的区别,以及他们实现为了实现结构化数据处理进行的SQL实现。
一图看懂Hadoop中的MapReduce与Spark的区别:从单机数据系统到分布式数据系统经历了哪些?的更多相关文章
- 一图看懂hadoop分布式文件存储系统HDFS工作原理
一图看懂hadoop分布式文件存储系统HDFS工作原理
- 一图看懂hadoop MapReduce工作原理
MapReduce执行流程及单词统计WordCount示例
- 一张图看懂JavaScript中数组的迭代方法:forEach、map、filter、reduce、every、some
好吧,竟然不能单发一张图,不够200字啊不够200字! 在<JavaScript高级程序设计>中,分门别类介绍了非常多数组方法,其中迭代方法里面有6种,这6种方法在实际项目有着非常广泛的作 ...
- 一图看懂hadoop Spark On Yarn工作原理
hadoop Spark On Yarn工作原理
- 一图看懂hadoop Yarn工作原理
Hadoop 资源调度框架Yarn运行流程
- 一张图看懂AI、机器学习和深度学习的区别
AI(人工智能)是未来,是科幻小说,是我们日常生活的一部分.所有论断都是正确的,只是要看你所谈到的AI到底是什么. 例如,当谷歌DeepMind开发的AlphaGo程序打败韩国职业围棋高手Lee Se ...
- 一图看懂Spring获取对象与java new对象区别
Spring获取对象与java new对象的区别,图片被压缩了,请点击图片放大查看
- 一张图看懂ANSYS17.0 流体 新功能与改进
一张图看懂ANSYS17.0 流体 新功能与改进 提交 我的留言 加载中 已留言 一张图看懂ANSYS17.0 流体 新功能与改进 原创2016-02-03ANSYS模拟在线模拟在线 模拟在线 ...
- 一篇文章一张思维导图看懂Android学习最佳路线
一篇文章一张思维导图看懂Android学习最佳路线 先上一张android开发知识点学习路线图思维导图 Android学习路线从4个阶段来对Android的学习过程做一个全面的分析:Android初级 ...
- 一张图看懂开源许可协议,开源许可证GPL、BSD、MIT、Mozilla、Apache和LGPL的区别
一张图看懂开源许可协议,开源许可证GPL.BSD.MIT.Mozilla.Apache和LGPL的区别 首先借用有心人士的一张相当直观清晰的图来划分各种协议:开源许可证GPL.BSD.MIT.Mozi ...
随机推荐
- Solutions:Elastic SIEM - 适用于家庭和企业的安全防护 ( 三)
- 移动端touch拖动事件和click事件冲突问题解决
通过一个悬浮球交互功能的案例来阐述问题,以及解决办法. 实现效果 类似微信里的悬浮窗效果,苹果手机的悬浮球功能效果 可以点击拖动,然后吸附在窗口边缘 点击悬浮球,可以跳转界面,或者更改悬浮球的形态 准 ...
- 文件内再分类到各txt文件
当老师叫我们帮他做事,比如文件内内容再分类,我们就可以建个面板,里面有各要导入文件按钮,先把分类内容copy下,再点按钮导入进txt文件就行啦. 以下为java代码,使用了tableLayout布局 ...
- 自定义ListView下拉刷新上拉加载更多
自定义ListView下拉刷新上拉加载更多 自定义RecyclerView下拉刷新上拉加载更多 Listview现在用的很少了,基本都是使用Recycleview,但是不得不说Listview具有划时 ...
- SpringBoot(三) - Slf4j+logback 日志,异步请求,定时任务
1.Slf4j+logback 日志 SpringBoot框架的默认日志实现:slf4j + logback: 默认日志级别:info,对应了实际生产环境日志级别: 1.1 日志级别 # 常见的日志框 ...
- uoj220【NOI2016】网格
刚了几个小时啊,这tm要是noi我怕不是直接滚粗了.我判答案为1的情况试了几种做法,最后终于想到了一个靠谱的做法,然后细节巨多,调了好久,刚拿到97分时代码有6.2KB了,后来发现有些东西好像没啥用就 ...
- 2流高手速成记(之四):SpringBoot整合redis及mongodb
最近很忙,好不容易才抽出了时间,咱们接上回 上次我们主要讲了如何通过SpringBoot快速集成mybatis/mybatis-plus,以实现业务交互中的数据持久化,而这一切都是基于关系型数据库(S ...
- python-windows下如何将单个py文件生成exe文件
这需要pyinstaller,在cmd执行pip install pyinstaller命令 安装完成后,执行 pyinstaller -F 目录 可执行文件于是就在同个目录下的dist目录顺利生成了 ...
- 5.pygame快速入门-精灵和精灵组
在之前案例中,图像加载.位置变化.绘制图像都需要编写代码分别处理 pygame提供了两个类简化开发步骤 pygame.sprite.Sprite #精灵,存储图像数据image和位置rect的对象 p ...
- 13-ORM-更新&删除
一.更改单个数据 修改单个实体的某些字段 1.查: - 通过get()得到要修改的实体对象 2.改: - 通过对象属性的=的方式修改数据 3.保存 - 通过对象.save()保存数据 二.批量 ...