
pandas read_sql与read_sql_table、read_sql_query 的区别
一:创建链接数据库引擎
from sqlalchemy import create_engine

db_info = {'user':'user',

    'password':'pwd',

    'host':'localhost',

    'database':'xx_db'  # 这里我们事先指定了数据库,后续操作只需要表即可

}

engine = create_engine('mysql+pymysql://%(user)s:%(password)s@%(host)s/%(database)s?charset=utf8' % db_info,encoding='utf-8')    #这里直接使用pymysql连接,echo=True,会显示在加载数据库所执行的SQL语句。
二:读取数据库数据,存储为DataFrame格式
部分来自于博客:http://blog.csdn.net/u011301133/article/details/52488690
1:读取自定义数据(通过SQL语句)
pandas.read_sql_query(sql, con, index_col=None, coerce_float=True, params=None, parse_dates=None,chunksize=None)
例如:data = pd.read_sql_query('select * from t_line ',con = engine),会返回一个数据库t_line表的DataFrame格式。如有有时间列可以parse_dates = [time_column]用于解析时间,并把此列作为索引index_col = [time_column]
read_sql_query()中可以接受SQL语句,包括增删改查。但是DELETE语句不会返回值(但是会在数据库中执行),UPDATE,SELECT,等会返回结果.
例如:data = pd.read_sql_query('delete from test_cjk where f_intime = 1309',con = engine),这条语句会执行,删除 test_cjk表中f_intime=1309的值,但不会返回data。
其他例子:
'''插入操作''' pd.read_sql_query("insert into cjk_test h values %(data)s",params={'data':v_split[11]},con=engine)
'''更新操作''' pd.read_sql_query("update cjk_test set a='粤11111' WHERE a='粤B30738'",con =engine)
'''删除操作'''pd.read_sql_query("delete from cjk_test where c='1'",con=engine)
删除插入更新操作没有返回值,程序会抛出SourceCodeCloseError,并终止程序。如果想继续运行,可以try捕捉此异常。
2:读取整张表于DataFrame格式(通过表名)
pd.read_sql_table(table_name, con, schema=None, index_col=None, coerce_float=True, parse_dates=None, columns=None, chunksize=None)
例如:data = pd.read_sql_table(table_name = 't_line',con = engine,parse_dates = 'time',index_col = 'time',columns = ['a','b','c'])
3:读数据库(通过SQL语句或者表名)
通过sql语句的见我另一篇文章:http://www.cnblogs.com/cymwill/articles/7576600.html
pd.read_sql(sql, con, index_col=None, coerce_float=True, params=None, parse_dates=None, columns=None, chunksize=None)
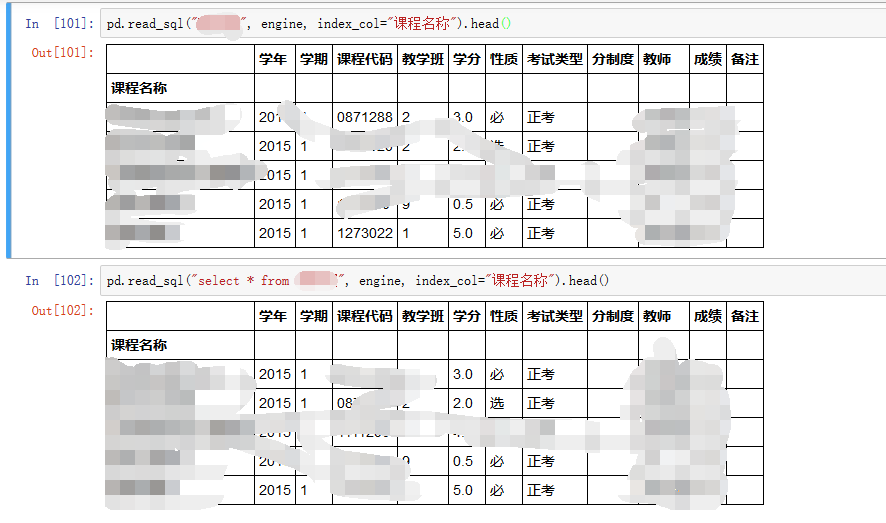
下面两个的作用又是相同的:
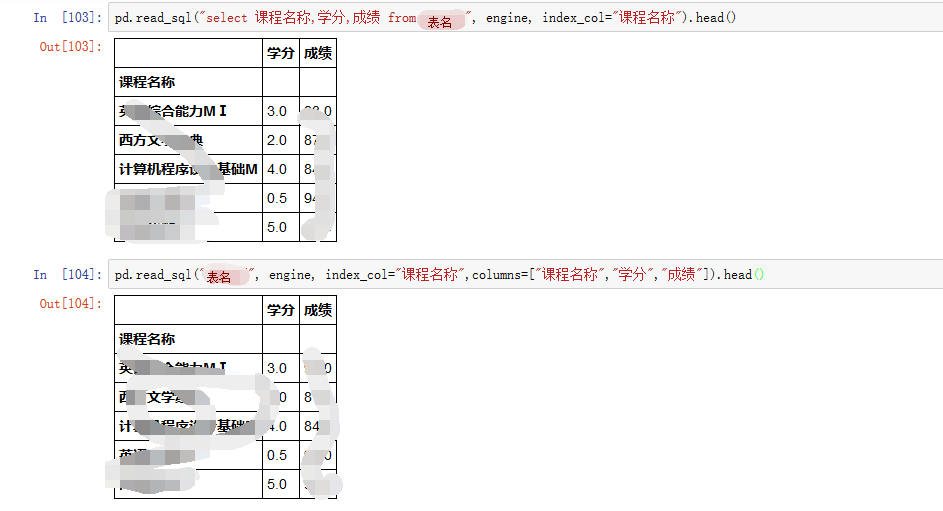
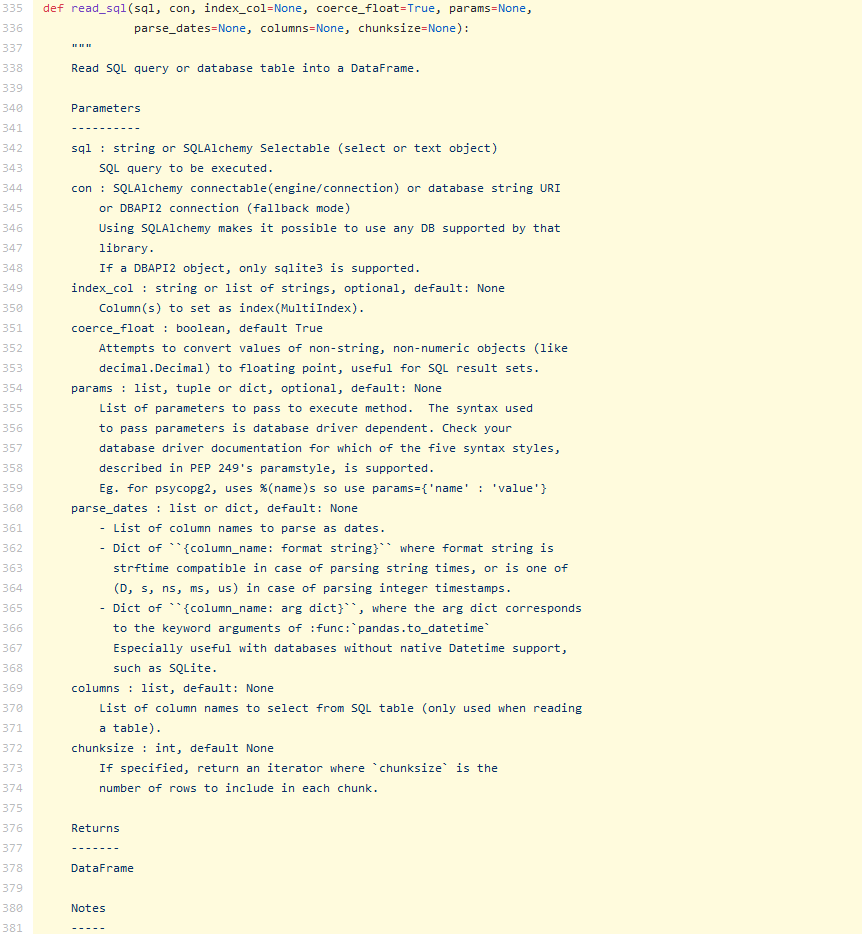
这个是官网的源代码里面的片段:
我们再将query与table相反的试一下:
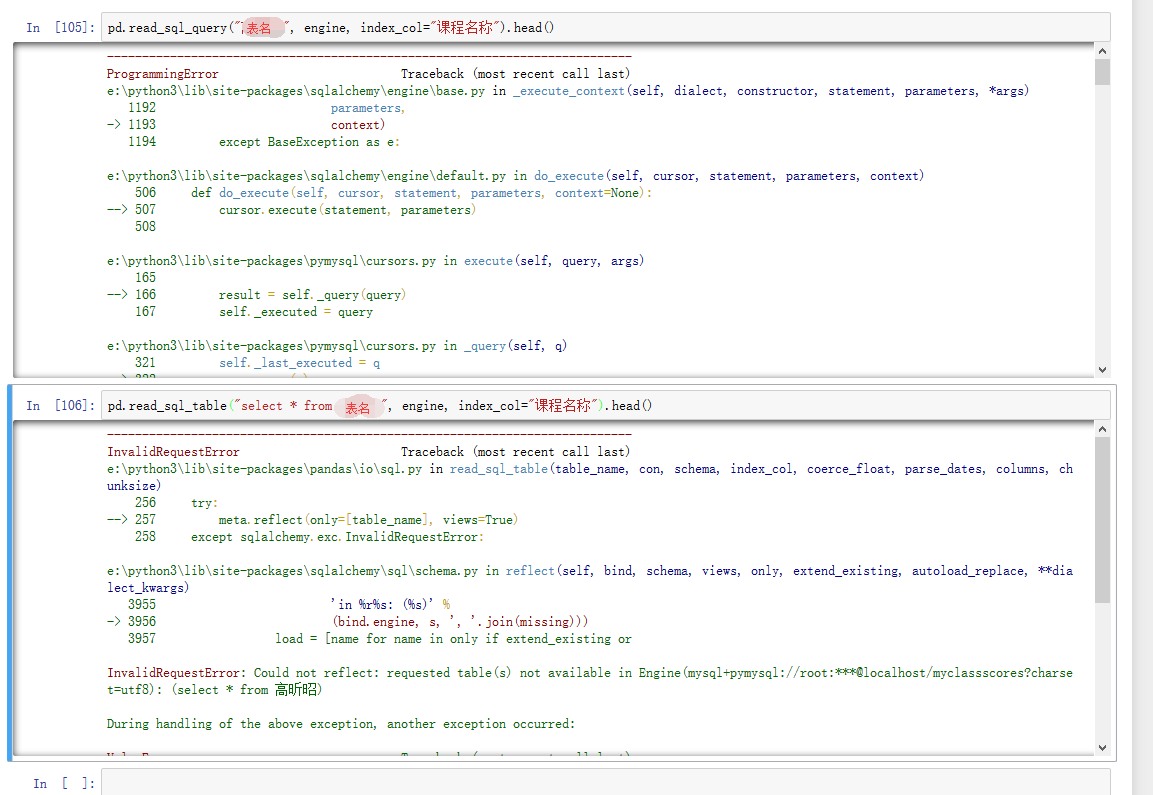
报错,故两者不能反过来。
从上面可以看到,其实read_sql是综合了read_sql_table和read_sql_query的,所以一般用read_sql就好了,省得再去区别那些东西。
三:数据写入于数据库
见我另一篇文章:http://www.cnblogs.com/cymwill/p/8288667.html
pandas read_sql与read_sql_table、read_sql_query 的区别的更多相关文章
- Pandas文件读取——Pandas.read_sql() 详解
目录 一.函数原型 二.常用参数说明 三.连接数据库方式--MySQL ①用sqlalchemy包构建数据库链接 ②用DBAPI构建数据库链接 ③将数据库敏感信息保存在文件中 一.函数原型 panda ...
- Pandas dataframe 与 Spark dataframe 的区别
区别 :http://www.voidcn.com/article/p-wsqbotem-boa.html 获取列名的列表: DataFrame.columns.values.tolist()
- [译]pandas中的iloc loc的区别?
loc 从特定的 gets rows (or columns) with particular labels from the index. iloc gets rows (or columns) a ...
- Pandas中merge和join的区别
可以说merge包含了join的操作,merge支持通过列或索引连表,而join只支持通过索引连表,只是简化了merge的索引连表的参数 示例 定义一个left的DataFrame left=pd.D ...
- Pandas中Series与Dataframe的区别
1. Series Series通俗来讲就是一维数组,索引(index)为每个元素的下标,值(value)为下标对应的值 例如: arr = ['Tom', 'Nancy', 'Jack', 'Ton ...
- read_sql_query, def read_sql_table
read_sql_query, read_sql_table def read_sql_query(sql, con, index_col=None, coerce_float=True, param ...
- Pandas:读取数据库read_sql
学习自:pandas.read_sql - pandas 1.2.4 documentation (10条消息) pd.read_sql()参数详解_pandas.read_csv()参数详解-CSD ...
- pandas DataFrame 索引(iloc 与 loc 的区别)
Pandas--ix vs loc vs iloc区别 0. DataFrame DataFrame 的构造主要依赖如下三个参数: data:表格数据: index:行索引: columns:列名: ...
- Pandas IO 操作
数据分析过程中经常需要进行读写操作,Pandas实现了很多 IO 操作的API 格式类型 数据描述 Reader Writer text CSV read_csv to_csv text JSON r ...
随机推荐
- F - 简单计算器(栈)
F - 简单计算器 Time Limit:1000MS Memory Limit:32768KB 64bit IO Format:%I64d & %I64u Descripti ...
- 第七课 nodejs请求响应
1 server.js 接收请求接收请求参数 和接收完成需要对request增加两个监听事件 var http = require('http');var url = require('url');f ...
- TestClass必须是public的
运行一个测试类遇到一下问题: namespace TestSample.Sample { [TestClass] class CynthiaTest { [Te ...
- 《挑战程序设计竞赛》2.1 广度优先搜索 AOJ0558 POJ3669 AOJ0121
AOJ0558 原文链接: AOJ0558 题意: 在H * W的地图上有N个奶酪工厂,分别生产硬度为1-N的奶酪.有一只吃货老鼠准备从老鼠洞出发吃遍每一个工厂的奶酪.老鼠有一个体力值,初始时为1,每 ...
- ECMAScript6箭头函数ArrowFunction"=>"
一.说明 ECMAScript6可以用箭头"=>"定义函数.x => x * x或(x) => {return x * x;}与匿名函数function(x){r ...
- NOIP2010~2017部分真题总结
NOIP2010~2017部分真题总结 2010 (吐槽)md这个时候的联赛还只有4题吗? 引水入城 只要发现对于有合法解的地图,每个蓄水厂贡献一段区间这个结论就很好做了 那么\(O(n^3)\)对每 ...
- MySQL中redo日志
重做日志用来实现事务的持久性,即ACID中的D,由两部分组成: 一是内存中的重做日志缓冲(redo log buffer) 易丢失 二是重做日志文件(redo log file) 持久的 InnoD ...
- Python操作Redis(二)
List操作 redis中的List在在内存中按照一个name对应一个List来存储.如图: lpush(name,values) # 在name对应的list中添加元素,每个新的元素都添加到列表的最 ...
- 怎样解决Please ensure that adb is correctly located at......
昨天下午搭建了Android开发环境,但是天公不作美--执行新建的Android项目总是提演示样例如以下问题: [2014-10-30 15:41:47 - ] The connection to a ...
- 【转】Linux下查看进程打开的文件句柄数
---查看系统默认的最大文件句柄数,系统默认是1024 # ulimit -n 1024 ----查看当前进程打开了多少句柄数 # lsof -n|awk '{print $2}'|sort|uniq ...