
Python实现结巴分词统计高频中文词汇
代码
 1 # 读取文件

 2 fn = open('youxi.txt', 'rt', encoding='utf-8')  # 打开文件

 3 string_data = fn.read()  # 读出整个文件

 4 fn.close()  # 关闭文件

 5

 6 # 文本预处理

 7 pattern = re.compile(u'\t|\n|\.|-|:|;|\)|\(|\?|"')  # 定义正则表达式匹配模式

 8 string_data = re.sub(pattern, '', string_data)  # 将符合模式的字符去除

 9

10 # 文本分词

11 seg_list_exact = jieba.cut(string_data, cut_all=False)  # 精确模式分词

12 object_list = []

13

14 # 分词并去除停用词

15 remove_words = set()

16 fr = open('stopword.txt', encoding = 'UTF-8')

17 for word in fr:

18     remove_words.add(str(word).strip())

19 fr.close()

20

21 for word in seg_list_exact:  # 循环读出每个分词

22     if word not in remove_words:  # 如果不在去除词库中

23         object_list.append(word)  # 分词追加到列表

24

25 # 词频统计

26 word_counts = collections.Counter(object_list)  # 对分词做词频统计

27 word_counts_top10 = word_counts.most_common(100)  # 获取前100最高频的词

28 print(word_counts_top10)  # 输出检查
需要引入的库
1 import re  # 正则表达式库

2 import collections  # 词频统计库

3 import numpy as np  # numpy数据处理库

4 import jieba  # 结巴分词
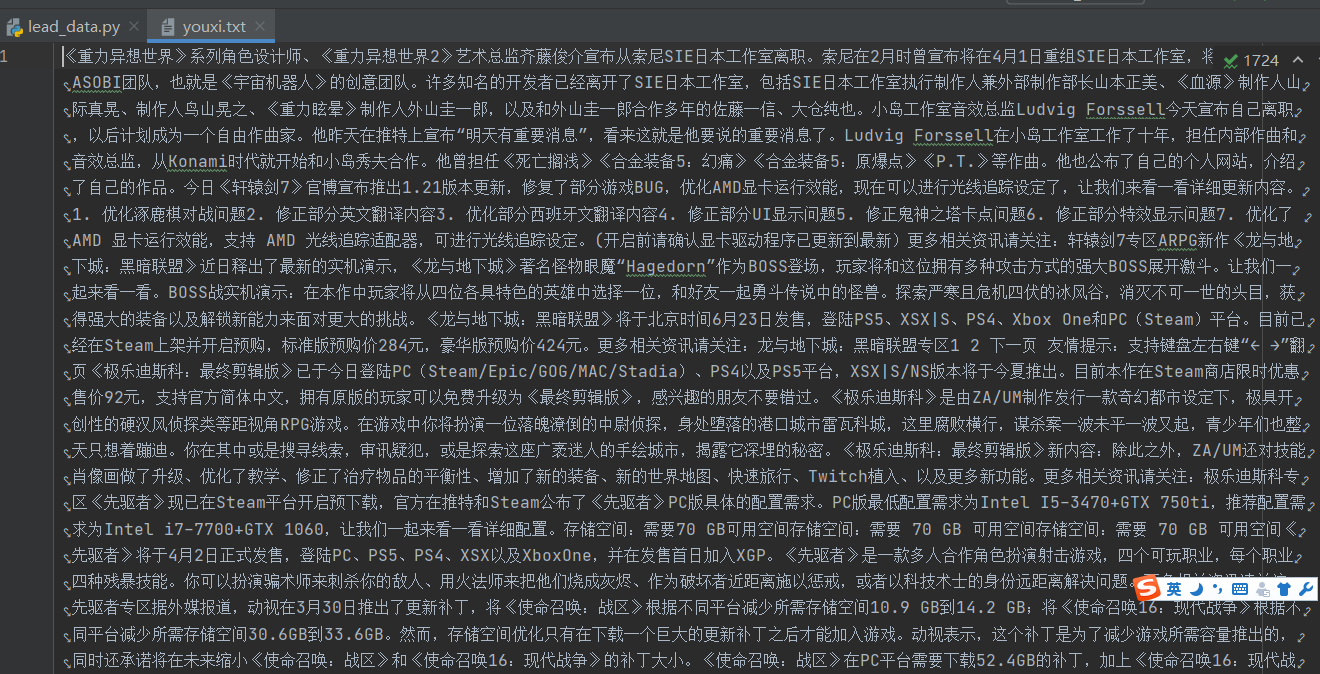
文件内容示例
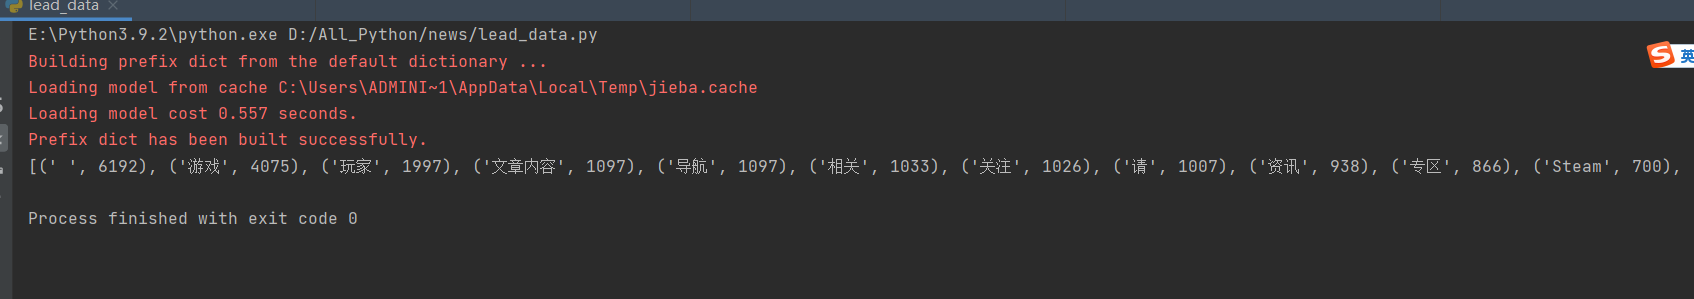
处理结果示例(前100)
Python实现结巴分词统计高频中文词汇的更多相关文章
- Python中结巴分词使用手记
手记实用系列文章: 1 结巴分词和自然语言处理HanLP处理手记 2 Python中文语料批量预处理手记 3 自然语言处理手记 4 Python中调用自然语言处理工具HanLP手记 5 Python中 ...
- 中文分词接口api,采用结巴分词PHP版中文分词接口
中文分词,分词就是将连续的字序列按照一定的规范重新组合成词序列的过程.我们知道,在英文的行文中,单词之间是以空格作为自然分界符的,而中文只是字.句和段能通过明显的分界符来简单划界,唯独词没有一个形式上 ...
- python中文分词:结巴分词
中文分词是中文文本处理的一个基础性工作,结巴分词利用进行中文分词.其基本实现原理有三点: 基于Trie树结构实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG) 采用了动态规 ...
- python 中文分词:结巴分词
中文分词是中文文本处理的一个基础性工作,结巴分词利用进行中文分词.其基本实现原理有三点: 基于Trie树结构实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG) 采用了动态规 ...
- Simple: SQLite3 中文结巴分词插件
一年前开发 simple 分词器,实现了微信在两篇文章中描述的,基于 SQLite 支持中文和拼音的搜索方案.具体背景参见这篇文章.项目发布后受到了一些朋友的关注,后续也发布了一些改进,提升了项目易用 ...
- 结巴分词和自然语言处理HanLP处理手记
手记实用系列文章: 1 结巴分词和自然语言处理HanLP处理手记 2 Python中文语料批量预处理手记 3 自然语言处理手记 4 Python中调用自然语言处理工具HanLP手记 5 Python中 ...
- python jieba分词(结巴分词)、提取词,加载词,修改词频,定义词库 -转载
转载请注明出处 “结巴”中文分词:做最好的 Python 中文分词组件,分词模块jieba,它是python比较好用的分词模块, 支持中文简体,繁体分词,还支持自定义词库. jieba的分词,提取关 ...
- 中文分词之结巴分词~~~附使用场景+demo(net)
常用技能(更新ing):http://www.cnblogs.com/dunitian/p/4822808.html#skill 技能总纲(更新ing):http://www.cnblogs.com/ ...
- Python 结巴分词(1)分词
利用结巴分词来进行词频的统计,并输出到文件中. 结巴分词github地址:结巴分词 结巴分词的特点: 支持三种分词模式: 精确模式,试图将句子最精确地切开,适合文本分析: 全模式,把句子中所有的可以成 ...
- 结巴(jieba)中文分词及其应用实践
中文文本分类不像英文文本分类一样只需要将单词一个个分开就可以了,中文文本分类需要将文字组成的词语分出来构成一个个向量.所以,需要分词. 这里使用网上流行的开源分词工具结巴分词(jieba),它可以有效 ...
随机推荐
- django中update_or_create()
update_or_create()方法中有一个defaults参数 模型字段会根据查询条件进行查询,如果查询到了,那么就用defaults对应的值去更新字段,如果没有查到就用defaults对应的值 ...
- Google Chrome 开启多下载下载,提高文件下载速度
在地址栏输入: chrome://flags/#enable-parallel-downloading Parallel downloading改为Enabled后重启浏览器即可打开多线程下载 (多线 ...
- 【LeetCode回溯算法#05】分割回文串(复习双指针判断回文以及substr函数使用记录)
分割回文串 力扣题目链接 给你一个字符串 s,请你将 s 分割成一些子串,使每个子串都是 回文串 .返回 s 所有可能的分割方案. 回文串 是正着读和反着读都一样的字符串. 示例 1: 输入:s = ...
- 详解SSL证书系列(3)如何选择SSL证书
我们知道了在网站部署 SSL 证书后,不管是对网站本身还是对网站的用户都能够带来许多好处.那么随着 HTTPS的普及,市面上也出现了各种不同的 SSL 证书.并且由于 SSL 证书的多样性,很多人对于 ...
- npm模块全局安装后无法使用解决方案
好家伙 npm模块全局安装后无法使用 估计是少配了环境变量 1.使用命令: npm config get prefix 找到全局包的安装位置 2.随后我们右键"我的电脑"打 ...
- 6、zookeeper应用场景-分布式唯一ID
分布式唯一id案例 原理:使用zookeeper有序节点,节点后会加上有序的id,用这个id来当唯一ID 在过去的单库单表型系统中,通常第可以使用数据库字段自带的auto_ increment属性来自 ...
- 一款开源、免费、跨平台的Redis可视化管理工具
前言 经常有小伙伴在技术群里问:有什么好用的Redis可视化管理工具推荐的吗?, 今天大姚给大家分享一款我一直在用的开源.免费(MIT License).跨平台的Redis可视化管理工具:Anothe ...
- 测试打包失败 已解决 分析过程 - 关键字 Jenkins nexus package-lock.json npm install build
Jenkins 打包失败 npm run build 总是失败,每次失败报错还不一样. 然后 npm install 每次安装 还总有包超时 MobaXterm1_CHS1 SSH 链接,手工安装也不 ...
- 动态less 解决 vue main.js
// 引入主题文件 // eslint-disable-next-line no-unused-expressions import('./theme/color/' + config.theme + ...
- 【mac】Alfred 无法调用Terminal
原因:是从mac app商店安装的Alfred class 解决方案:建议从官网下载安装:https://www.alfredapp.com/ 参考:https://www.alfredforum.c ...