
ChatGLM3-6B:新一代开源双语对话语言模型,流畅对话与低部署门槛再升级
ChatGLM3-6B:新一代开源双语对话语言模型,流畅对话与低部署门槛再升级
1.ChatGLM3简介
ChatGLM3 是智谱AI和清华大学 KEG 实验室联合发布的新一代对话预训练模型。ChatGLM3-6B 是 ChatGLM3 系列中的开源模型,在保留了前两代模型对话流畅、部署门槛低等众多优秀特性的基础上,ChatGLM3-6B 引入了如下特性:
- 更强大的基础模型: ChatGLM3-6B 的基础模型 ChatGLM3-6B-Base 采用了更多样的训练数据、更充分的训练步数和更合理的训练策略。在语义、数学、推理、代码、知识等不同角度的数据集上测评显示,ChatGLM3-6B-Base 具有在 10B 以下的基础模型中最强的性能。
- 更完整的功能支持: ChatGLM3-6B 采用了全新设计的 Prompt 格式,除正常的多轮对话外。同时原生支持工具调用(Function Call)、代码执行(Code Interpreter)和 Agent 任务等复杂场景。
- 更全面的开源序列: 除了对话模型 ChatGLM3-6B 外,还开源了基础模型 ChatGLM3-6B-Base、长文本对话模型 ChatGLM3-6B-32K。以上所有权重对学术研究完全开放,在填写问卷进行登记后亦允许免费商业使用。
ChatGLM3 开源模型旨在与开源社区一起推动大模型技术发展,恳请开发者和大家遵守开源协议,勿将开源模型和代码及基于开源项目产生的衍生物用于任何可能给国家和社会带来危害的用途以及用于任何未经过安全评估和备案的服务。目前,本项目团队未基于 ChatGLM3 开源模型开发任何应用,包括网页端、安卓、苹果 iOS 及 Windows App 等应用。
尽管模型在训练的各个阶段都尽力确保数据的合规性和准确性,但由于 ChatGLM3-6B 模型规模较小,且模型受概率随机性因素影响,无法保证输出内容的准确。同时模型的输出容易被用户的输入误导。本项目不承担开源模型和代码导致的数据安全、舆情风险或发生任何模型被误导、滥用、传播、不当利用而产生的风险和责任。
1.1 模型列表
| Model | Seq Length | Download |
|---|---|---|
| ChatGLM3-6B | 8k | HuggingFace | ModelScope |
| ChatGLM3-6B-Base | 8k | HuggingFace | ModelScope |
| ChatGLM3-6B-32K | 32k | HuggingFace | ModelScope |
对 ChatGLM3 进行加速的开源项目:
- chatglm.cpp: 类似 llama.cpp 的量化加速推理方案,实现笔记本上实时对话
- ChatGLM3-TPU: 采用TPU加速推理方案,在算能端侧芯片BM1684X(16T@FP16,内存16G)上实时运行约7.5 token/s
1.2评测结果
1.2.1 典型任务
我们选取了 8 个中英文典型数据集,在 ChatGLM3-6B (base) 版本上进行了性能测试。
| Model | GSM8K | MATH | BBH | MMLU | C-Eval | CMMLU | MBPP | AGIEval |
|---|---|---|---|---|---|---|---|---|
| ChatGLM2-6B-Base | 32.4 | 6.5 | 33.7 | 47.9 | 51.7 | 50.0 | - | - |
| Best Baseline | 52.1 | 13.1 | 45.0 | 60.1 | 63.5 | 62.2 | 47.5 | 45.8 |
| ChatGLM3-6B-Base | 72.3 | 25.7 | 66.1 | 61.4 | 69.0 | 67.5 | 52.4 | 53.7 |
Best Baseline 指的是截止 2023年10月27日、模型参数在 10B 以下、在对应数据集上表现最好的预训练模型,不包括只针对某一项任务训练而未保持通用能力的模型。
对 ChatGLM3-6B-Base 的测试中,BBH 采用 3-shot 测试,需要推理的 GSM8K、MATH 采用 0-shot CoT 测试,MBPP 采用 0-shot 生成后运行测例计算 Pass@1 ,其他选择题类型数据集均采用 0-shot 测试。
我们在多个长文本应用场景下对 ChatGLM3-6B-32K 进行了人工评估测试。与二代模型相比,其效果平均提升了超过 50%。在论文阅读、文档摘要和财报分析等应用中,这种提升尤为显著。此外,我们还在 LongBench 评测集上对模型进行了测试,具体结果如下表所示
| Model | 平均 | Summary | Single-Doc QA | Multi-Doc QA | Code | Few-shot | Synthetic |
|---|---|---|---|---|---|---|---|
| ChatGLM2-6B-32K | 41.5 | 24.8 | 37.6 | 34.7 | 52.8 | 51.3 | 47.7 |
| ChatGLM3-6B-32K | 50.2 | 26.6 | 45.8 | 46.1 | 56.2 | 61.2 | 65 |
2.快速使用
2.1 环境安装
首先需要下载本仓库:
git clone https://github.com/THUDM/ChatGLM3

cd ChatGLM3
然后使用 pip 安装依赖:
pip install -r requirements.txt
其中 transformers 库版本推荐为 4.30.2,torch 推荐使用 2.0 及以上的版本,以获得最佳的推理性能。
2.2 ChatGLM3 Web Demo
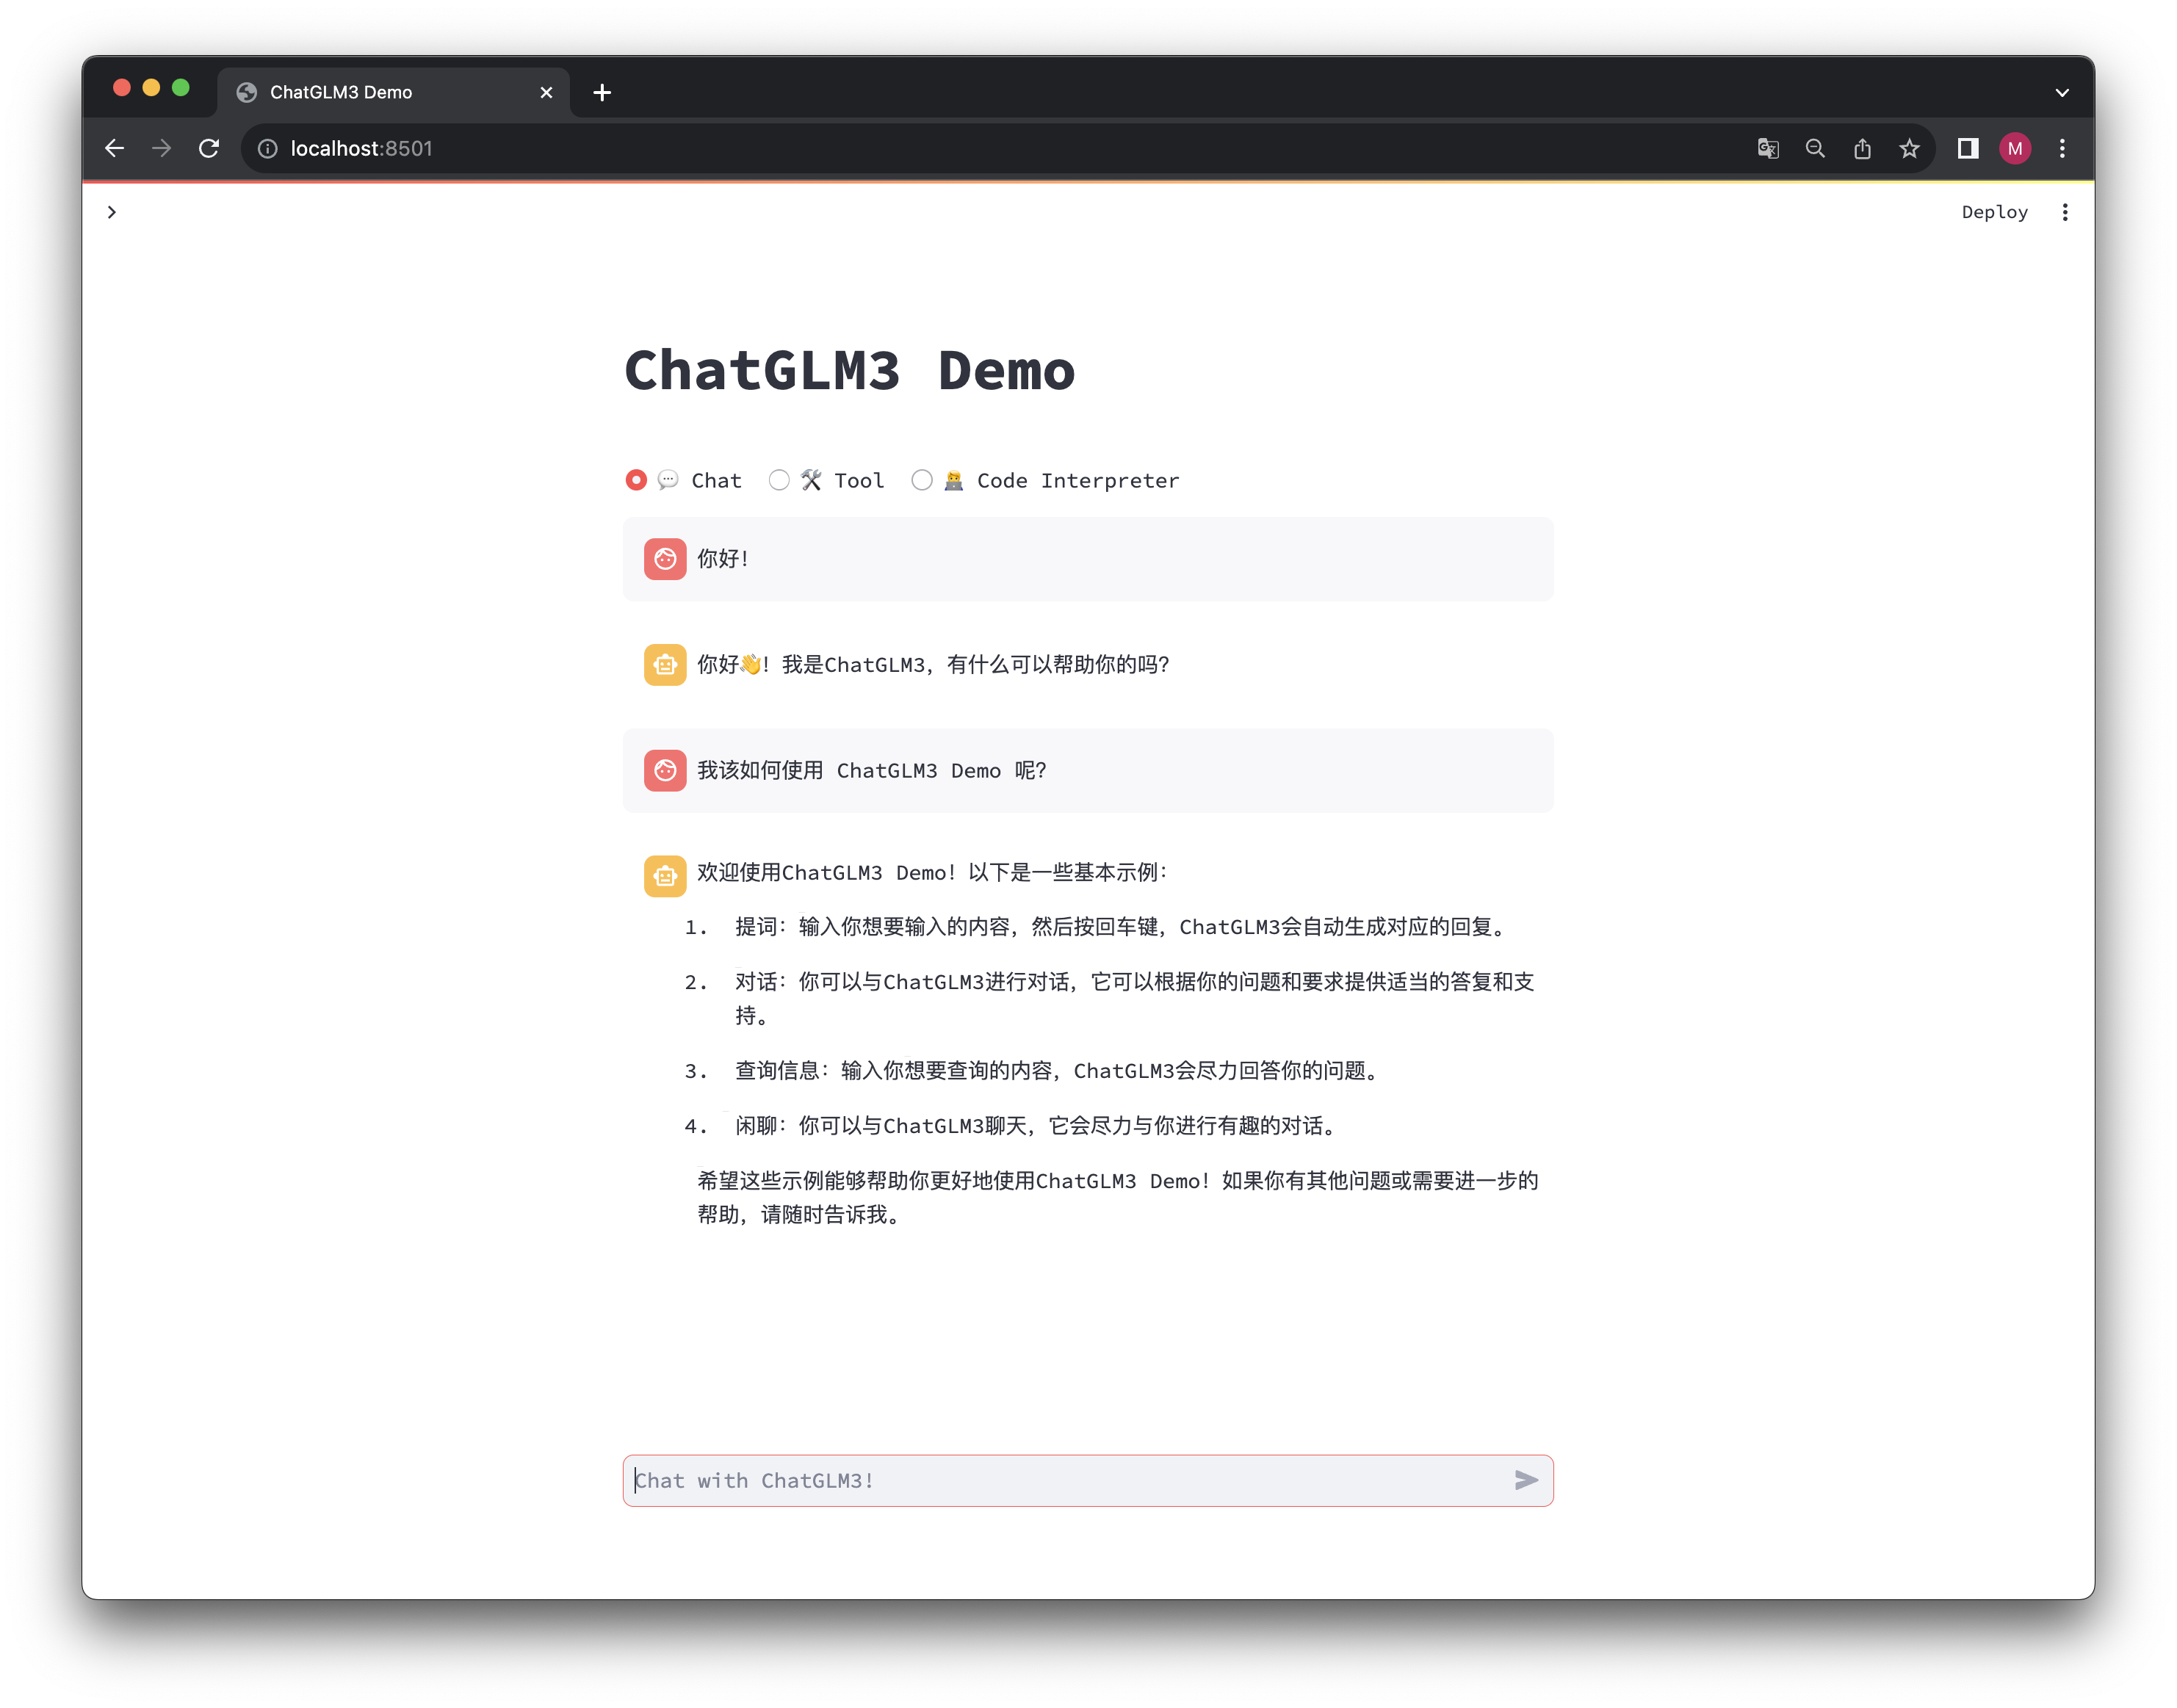
- 安装
我们建议通过 Conda 进行环境管理。
执行以下命令新建一个 conda 环境并安装所需依赖:
conda create -n chatglm3-demo python=3.10

conda activate chatglm3-demo

pip install -r requirements.txt
请注意,本项目需要 Python 3.10 或更高版本。
此外,使用 Code Interpreter 还需要安装 Jupyter 内核:
ipython kernel install --name chatglm3-demo --user
- 运行
运行以下命令在本地加载模型并启动 demo:
streamlit run main.py
之后即可从命令行中看到 demo 的地址,点击即可访问。初次访问需要下载并加载模型,可能需要花费一定时间。
如果已经在本地下载了模型,可以通过 export MODEL_PATH=/path/to/model 来指定从本地加载模型。如果需要自定义 Jupyter 内核,可以通过 export IPYKERNEL=<kernel_name> 来指定。
- 使用
ChatGLM3 Demo 拥有三种模式:
- Chat: 对话模式,在此模式下可以与模型进行对话。
- Tool: 工具模式,模型除了对话外,还可以通过工具进行其他操作。
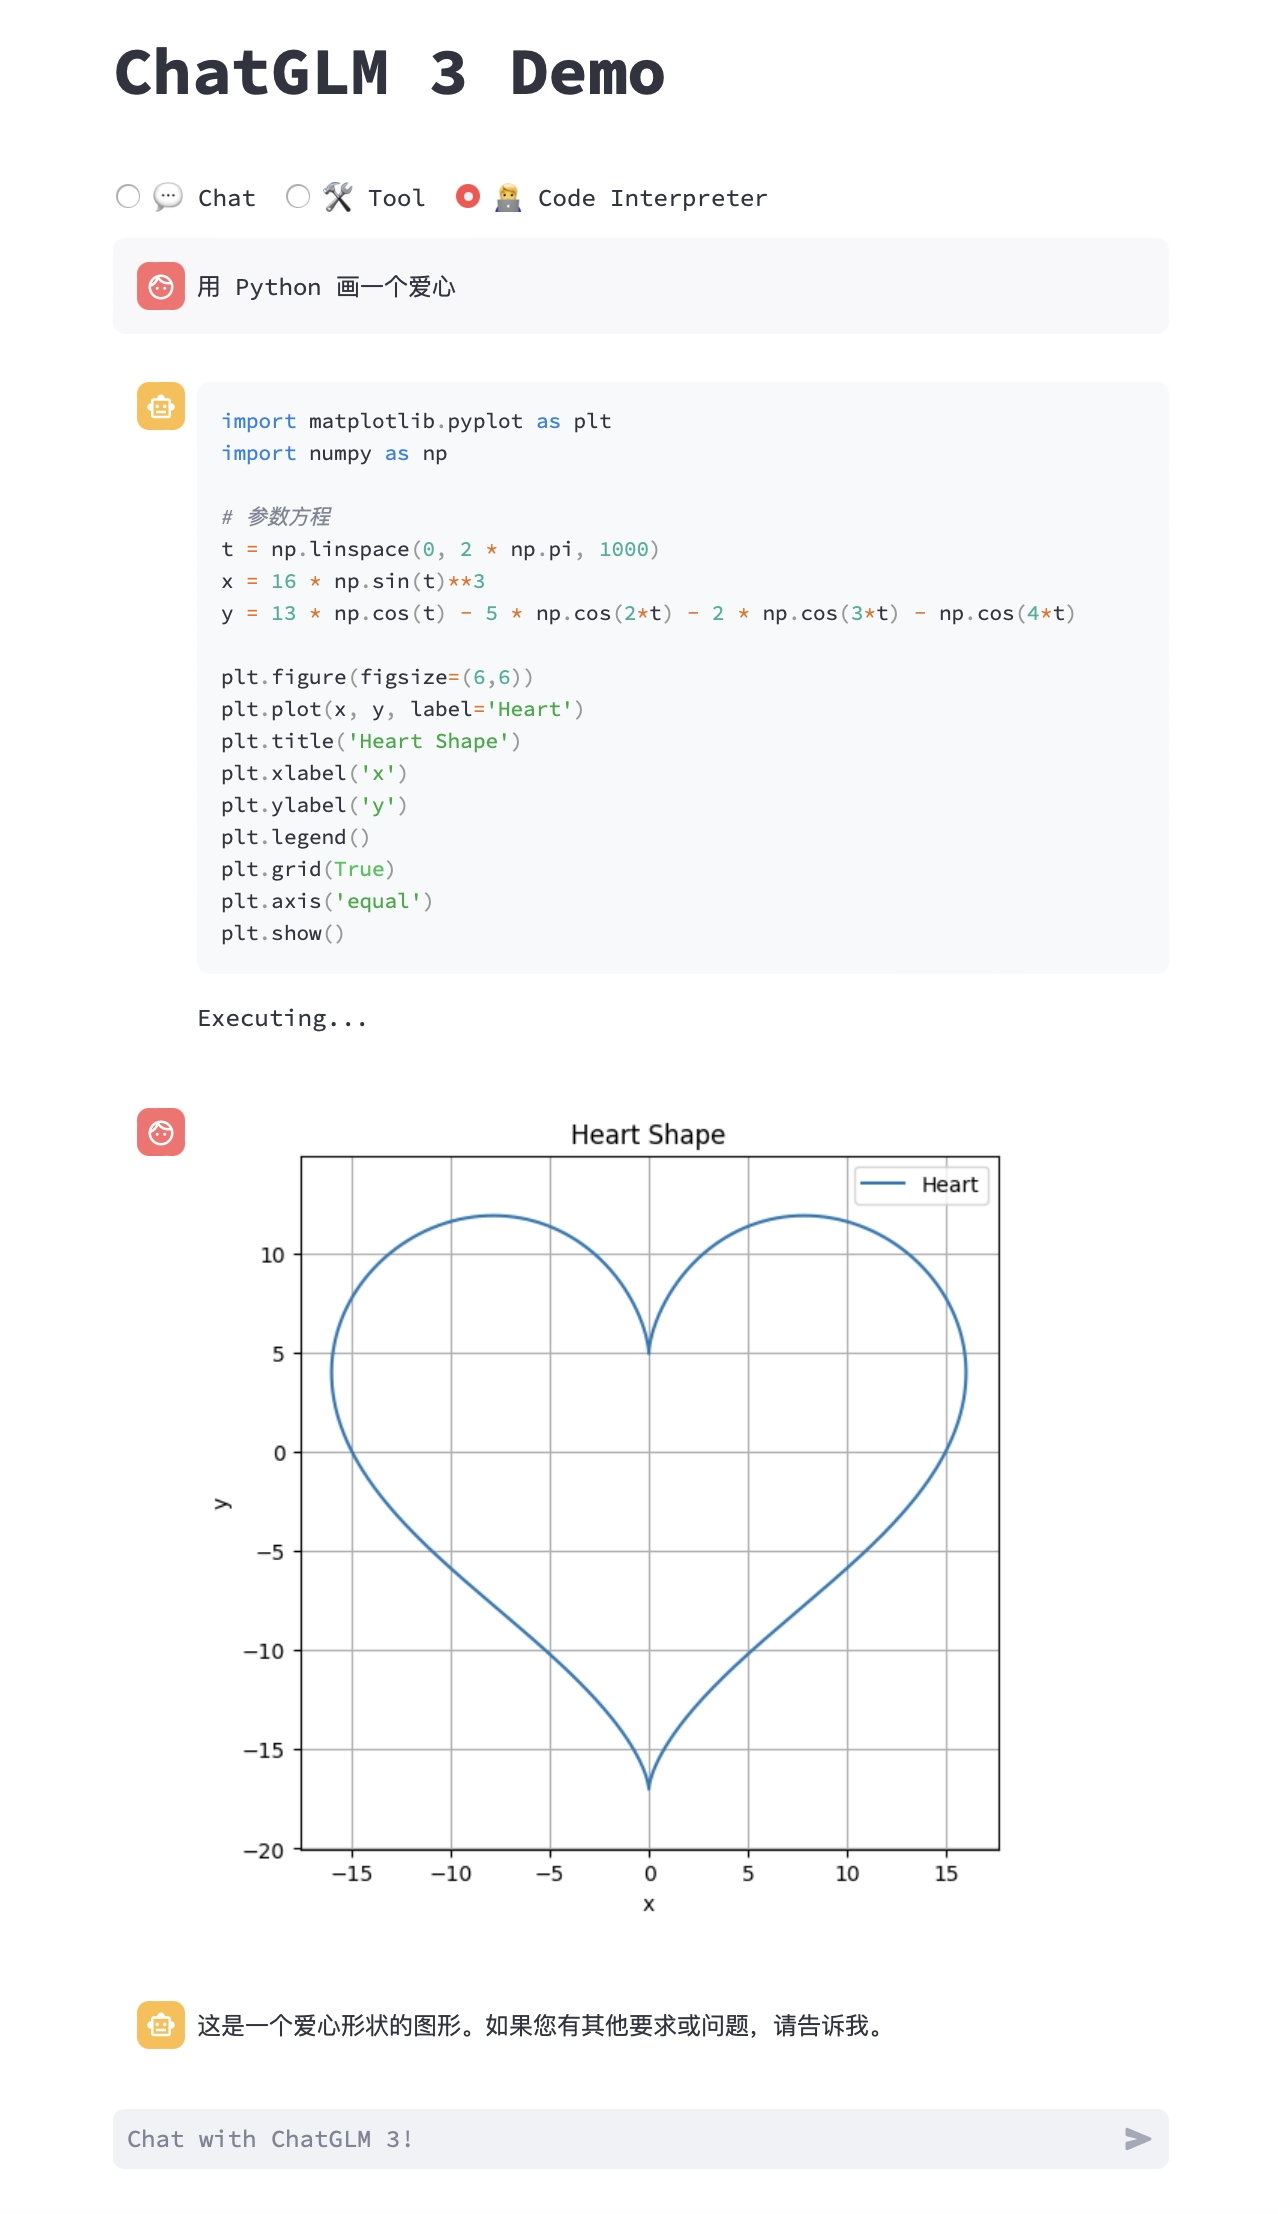
- Code Interpreter: 代码解释器模式,模型可以在一个 Jupyter 环境中执行代码并获取结果,以完成复杂任务。
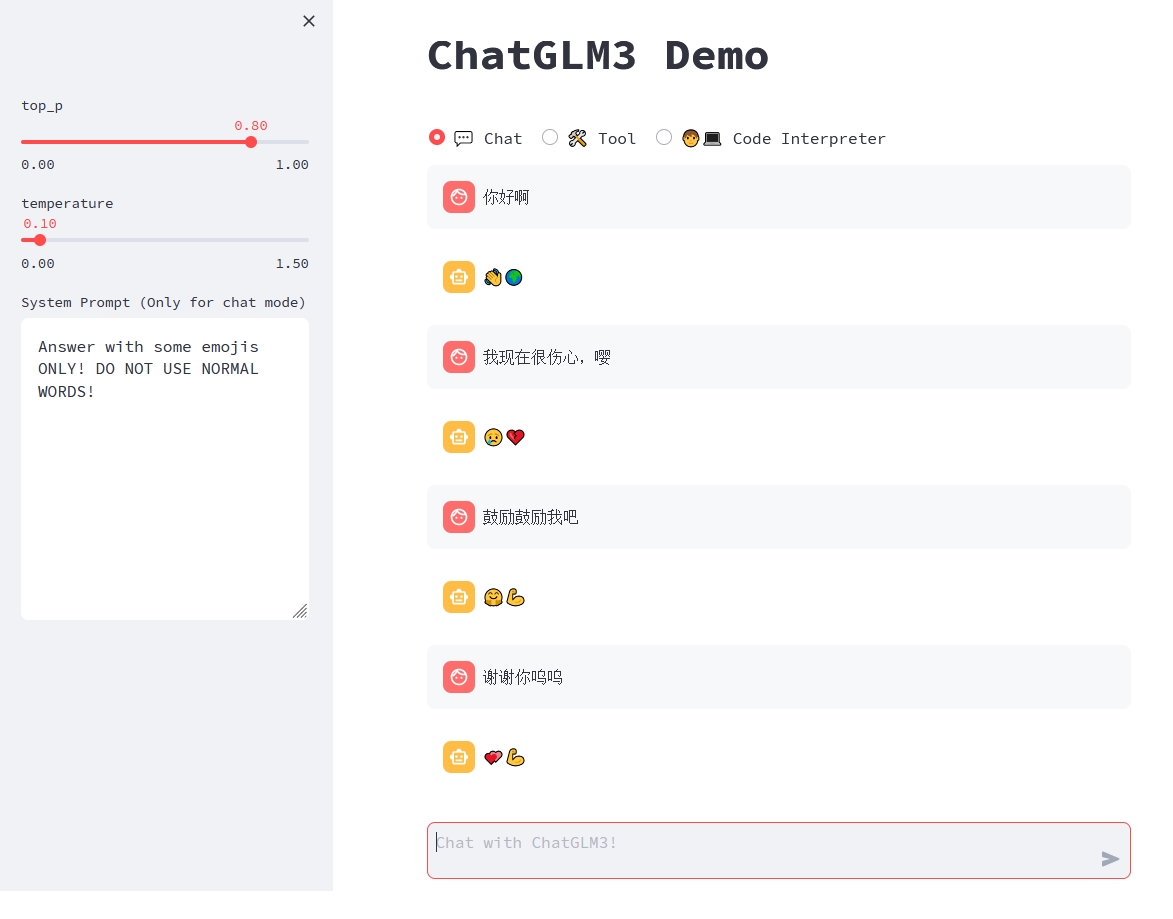
- 对话模式
对话模式下,用户可以直接在侧边栏修改 top_p, temperature, System Prompt 等参数来调整模型的行为。例如
- 工具模式
可以通过在 tool_registry.py 中注册新的工具来增强模型的能力。只需要使用 @register_tool 装饰函数即可完成注册。对于工具声明,函数名称即为工具的名称,函数 docstring 即为工具的说明;对于工具的参数,使用 Annotated[typ: type, description: str, required: bool] 标注参数的类型、描述和是否必须。
例如,get_weather 工具的注册如下:
@register_tool

def get_weather(

    city_name: Annotated[str, 'The name of the city to be queried', True],

) -> str:

    """

    Get the weather for `city_name` in the following week

    """

    ...
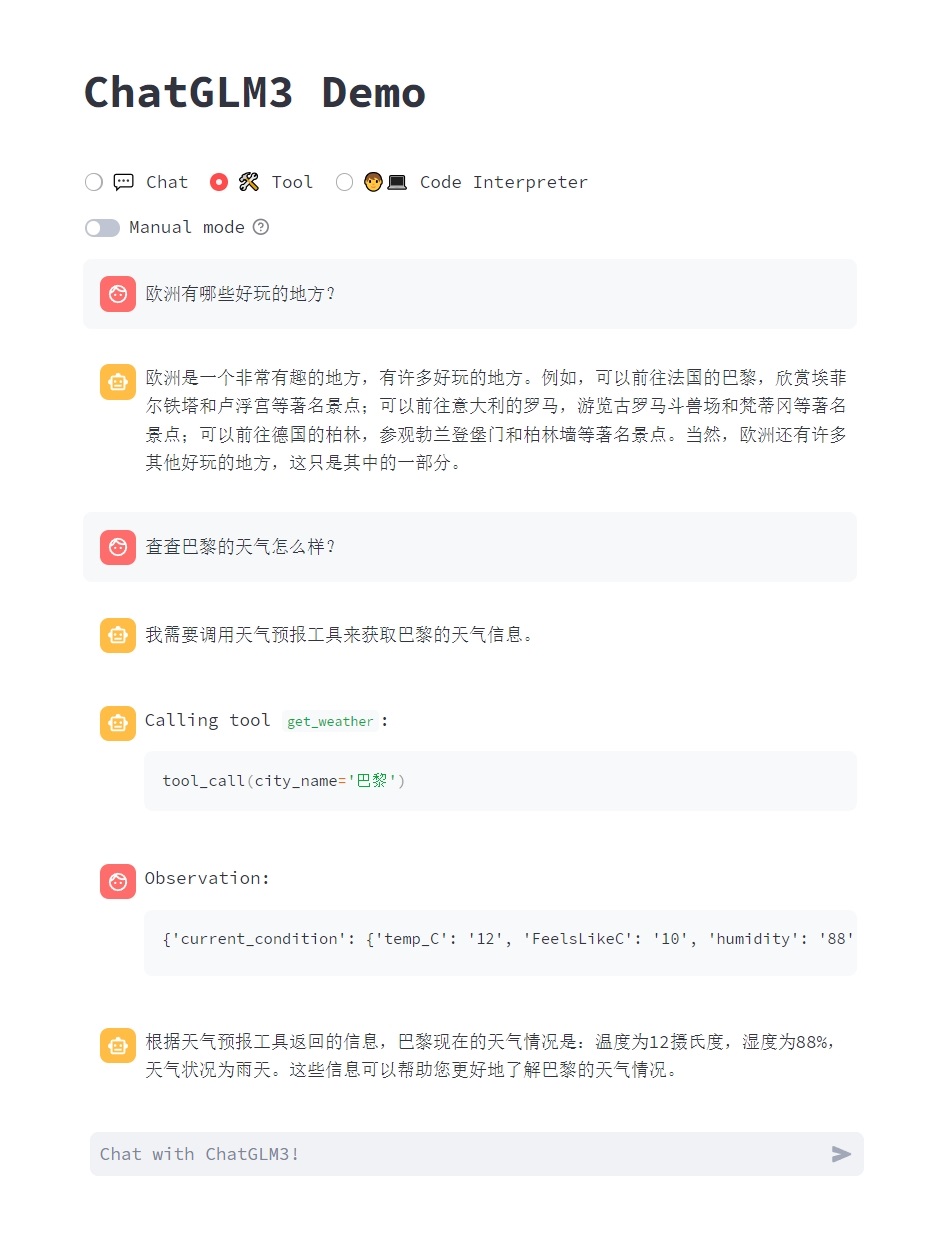
此外,你也可以在页面中通过 Manual mode 进入手动模式,在这一模式下你可以通过 YAML 来直接指定工具列表,但你需要手动将工具的输出反馈给模型。
- 代码解释器模式
由于拥有代码执行环境,此模式下的模型能够执行更为复杂的任务,例如绘制图表、执行符号运算等等。模型会根据对任务完成情况的理解自动地连续执行多个代码块,直到任务完成。因此,在这一模式下,你只需要指明希望模型执行的任务即可。
例如,我们可以让 ChatGLM3 画一个爱心:
- 额外技巧
- 在模型生成文本时,可以通过页面右上角的
Stop按钮进行打断。 - 刷新页面即可清空对话记录。
2.3 代码调用
可以通过如下代码调用 ChatGLM 模型来生成对话:
>>> from transformers import AutoTokenizer, AutoModel

>>> tokenizer = AutoTokenizer.from_pretrained("THUDM/chatglm3-6b", trust_remote_code=True)

>>> model = AutoModel.from_pretrained("THUDM/chatglm3-6b", trust_remote_code=True, device='cuda')

>>> model = model.eval()

>>> response, history = model.chat(tokenizer, "你好", history=[])

>>> print(response)

你好!我是人工智能助手 ChatGLM3-6B,很高兴见到你,欢迎问我任何问题。

>>> response, history = model.chat(tokenizer, "晚上睡不着应该怎么办", history=history)

>>> print(response)

晚上睡不着可能会让你感到焦虑或不舒服,但以下是一些可以帮助你入睡的方法:

1. 制定规律的睡眠时间表:保持规律的睡眠时间表可以帮助你建立健康的睡眠习惯,使你更容易入睡。尽量在每天的相同时间上床,并在同一时间起床。

2. 创造一个舒适的睡眠环境:确保睡眠环境舒适,安静,黑暗且温度适宜。可以使用舒适的床上用品,并保持房间通风。

3. 放松身心:在睡前做些放松的活动,例如泡个热水澡,听些轻柔的音乐,阅读一些有趣的书籍等,有助于缓解紧张和焦虑,使你更容易入睡。

4. 避免饮用含有咖啡因的饮料:咖啡因是一种刺激性物质,会影响你的睡眠质量。尽量避免在睡前饮用含有咖啡因的饮料,例如咖啡,茶和可乐。

5. 避免在床上做与睡眠无关的事情:在床上做些与睡眠无关的事情,例如看电影,玩游戏或工作等,可能会干扰你的睡眠。

6. 尝试呼吸技巧:深呼吸是一种放松技巧,可以帮助你缓解紧张和焦虑,使你更容易入睡。试着慢慢吸气,保持几秒钟,然后缓慢呼气。

如果这些方法无法帮助你入睡,你可以考虑咨询医生或睡眠专家,寻求进一步的建议。
- 从本地加载模型
以上代码会由transformers自动下载模型实现和参数。完整的模型实现在 Hugging Face Hub。如果你的网络环境较差,下载模型参数可能会花费较长时间甚至失败。此时可以先将模型下载到本地,然后从本地加载。
从 Hugging Face Hub 下载模型需要先安装Git LFS,然后运行
git clone https://huggingface.co/THUDM/chatglm3-6b
如果从你从 HuggingFace 下载比较慢,也可以从 ModelScope
中下载。
2.4 模型微调
请参考 ChatGLM3-6B 微调示例。
2.5 网页版对话 Demo
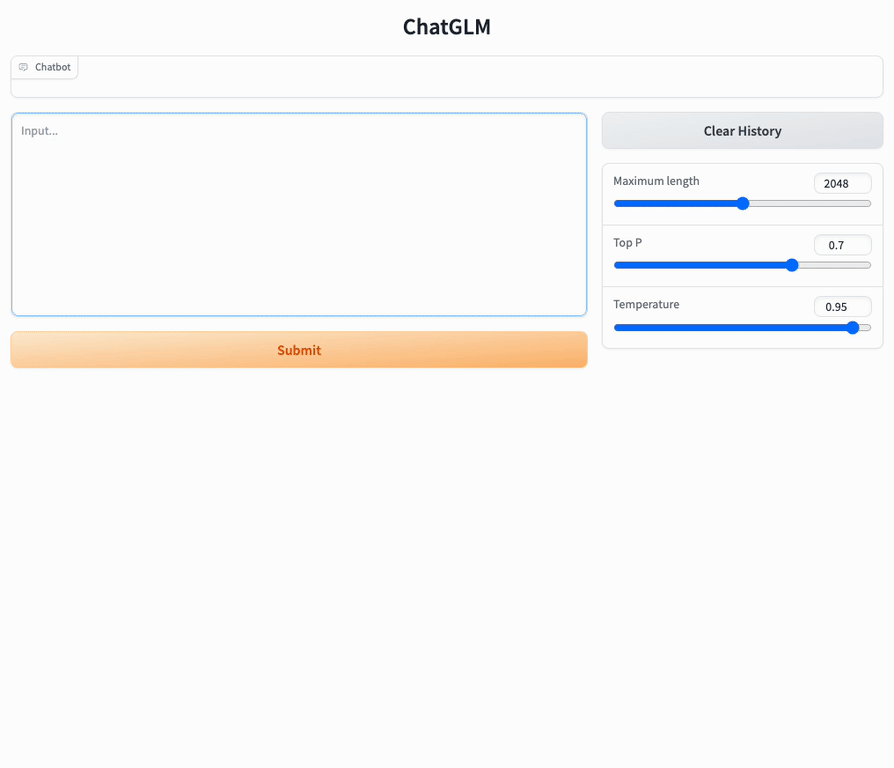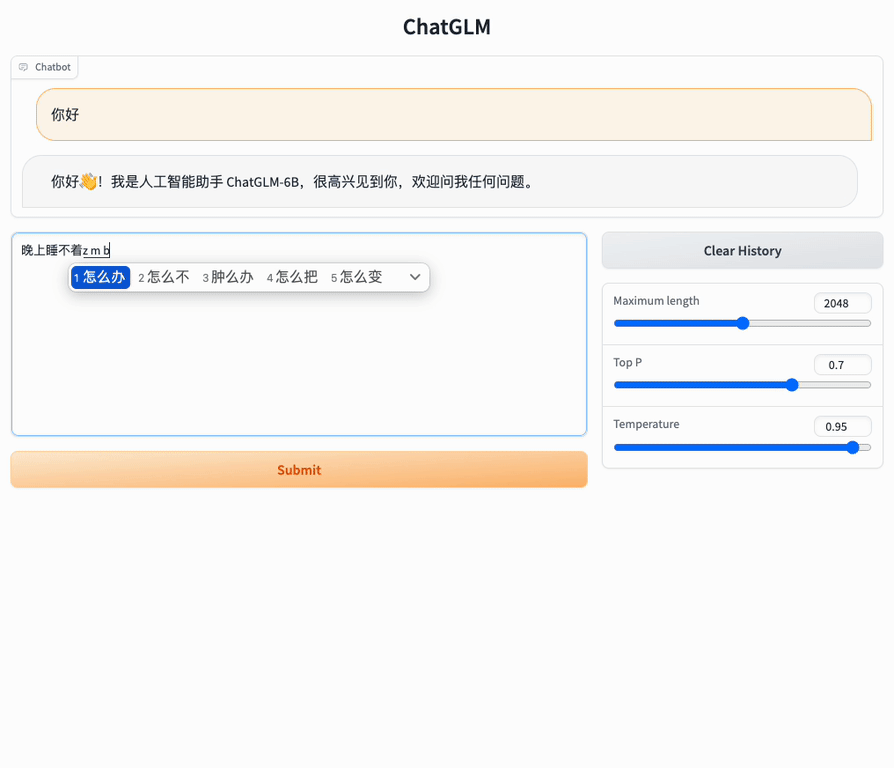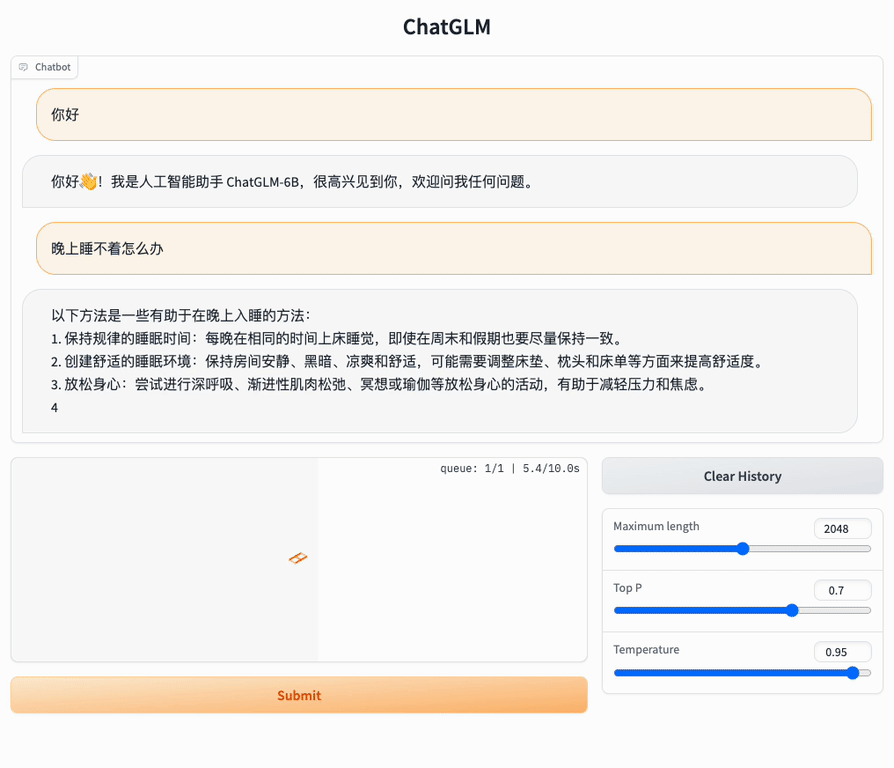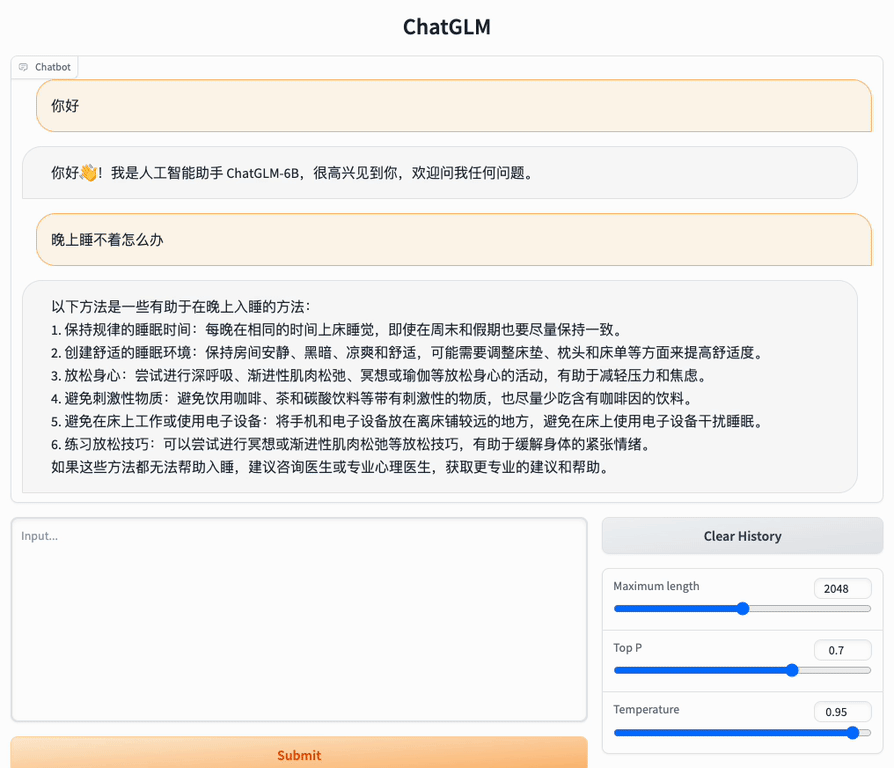
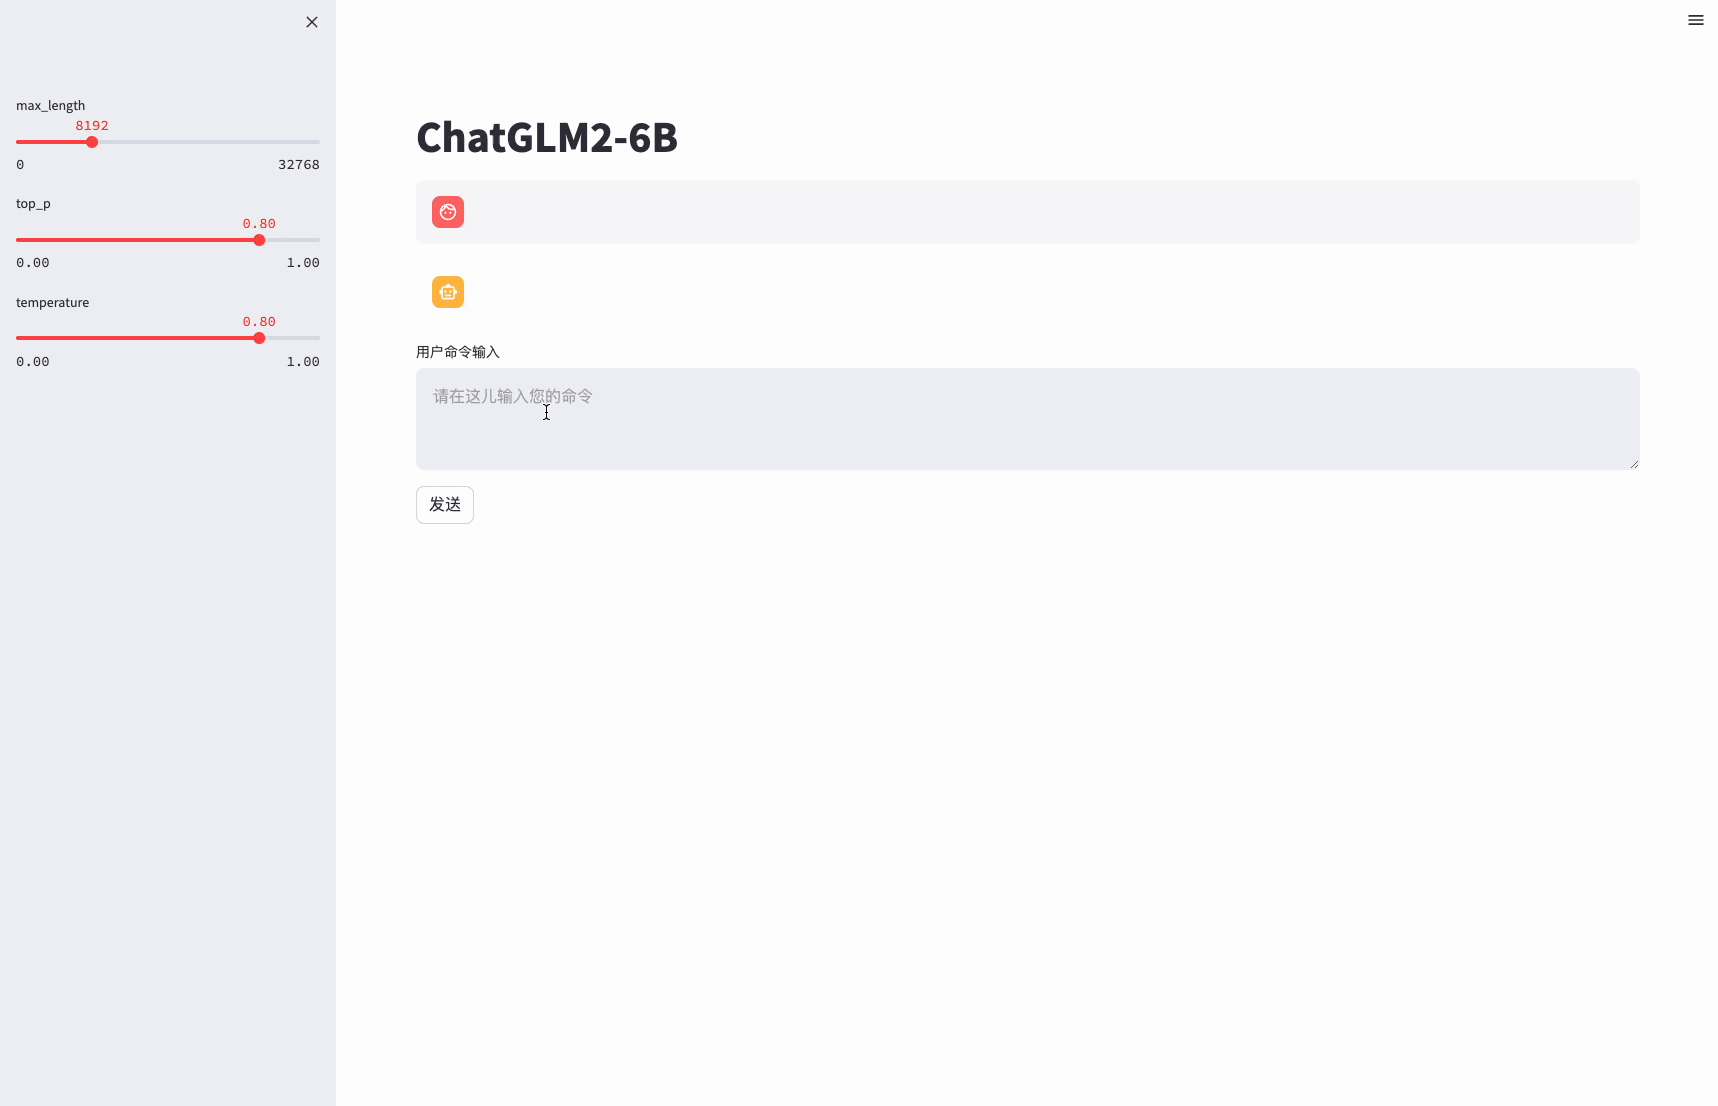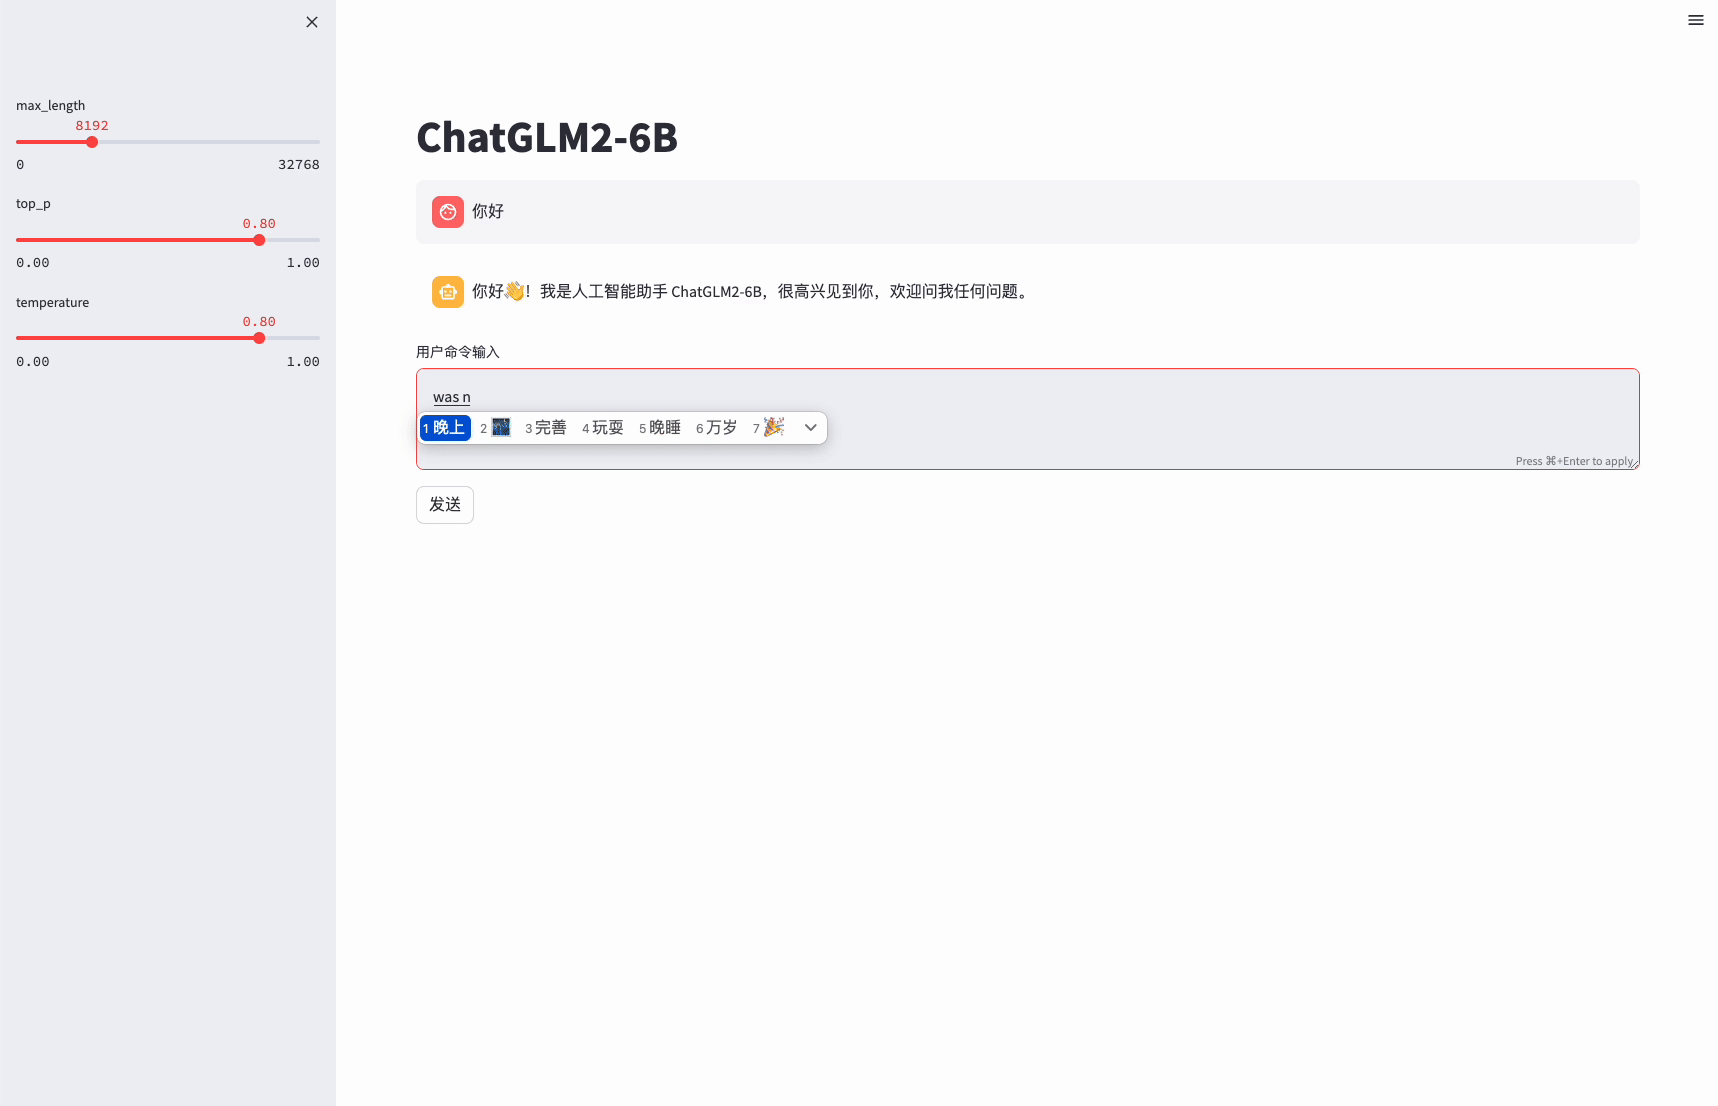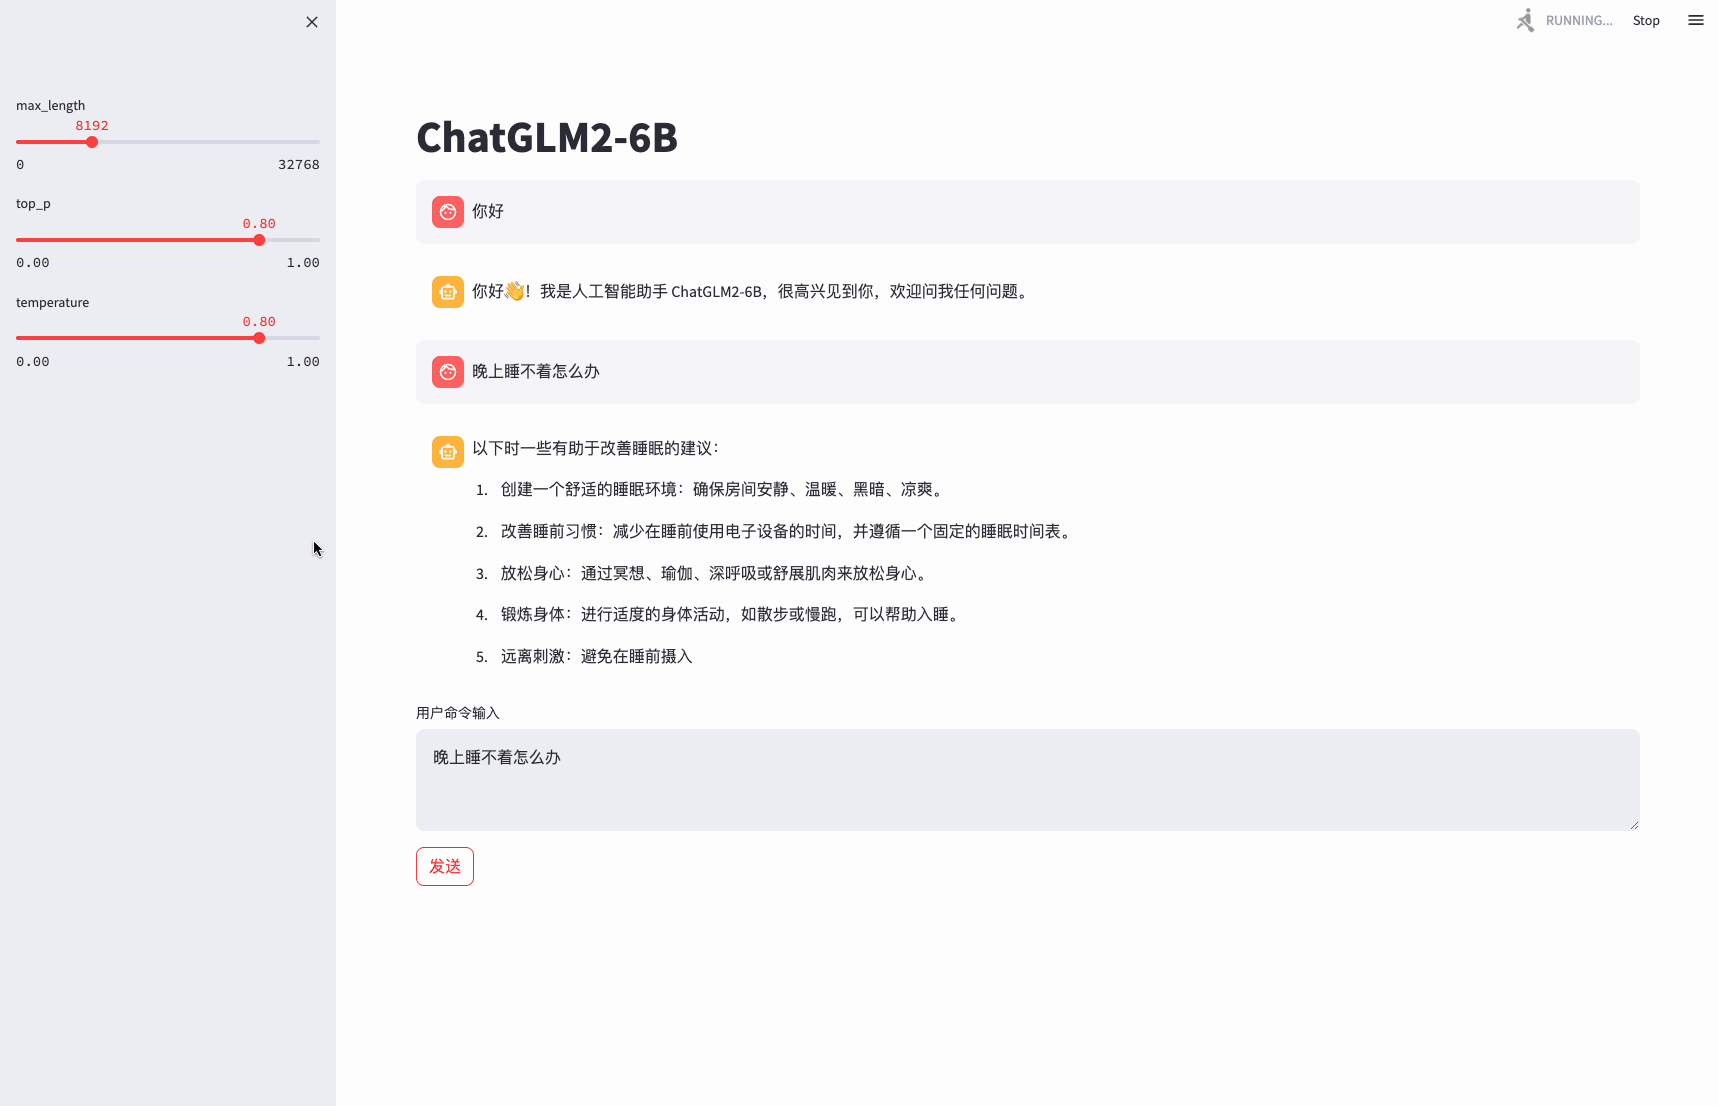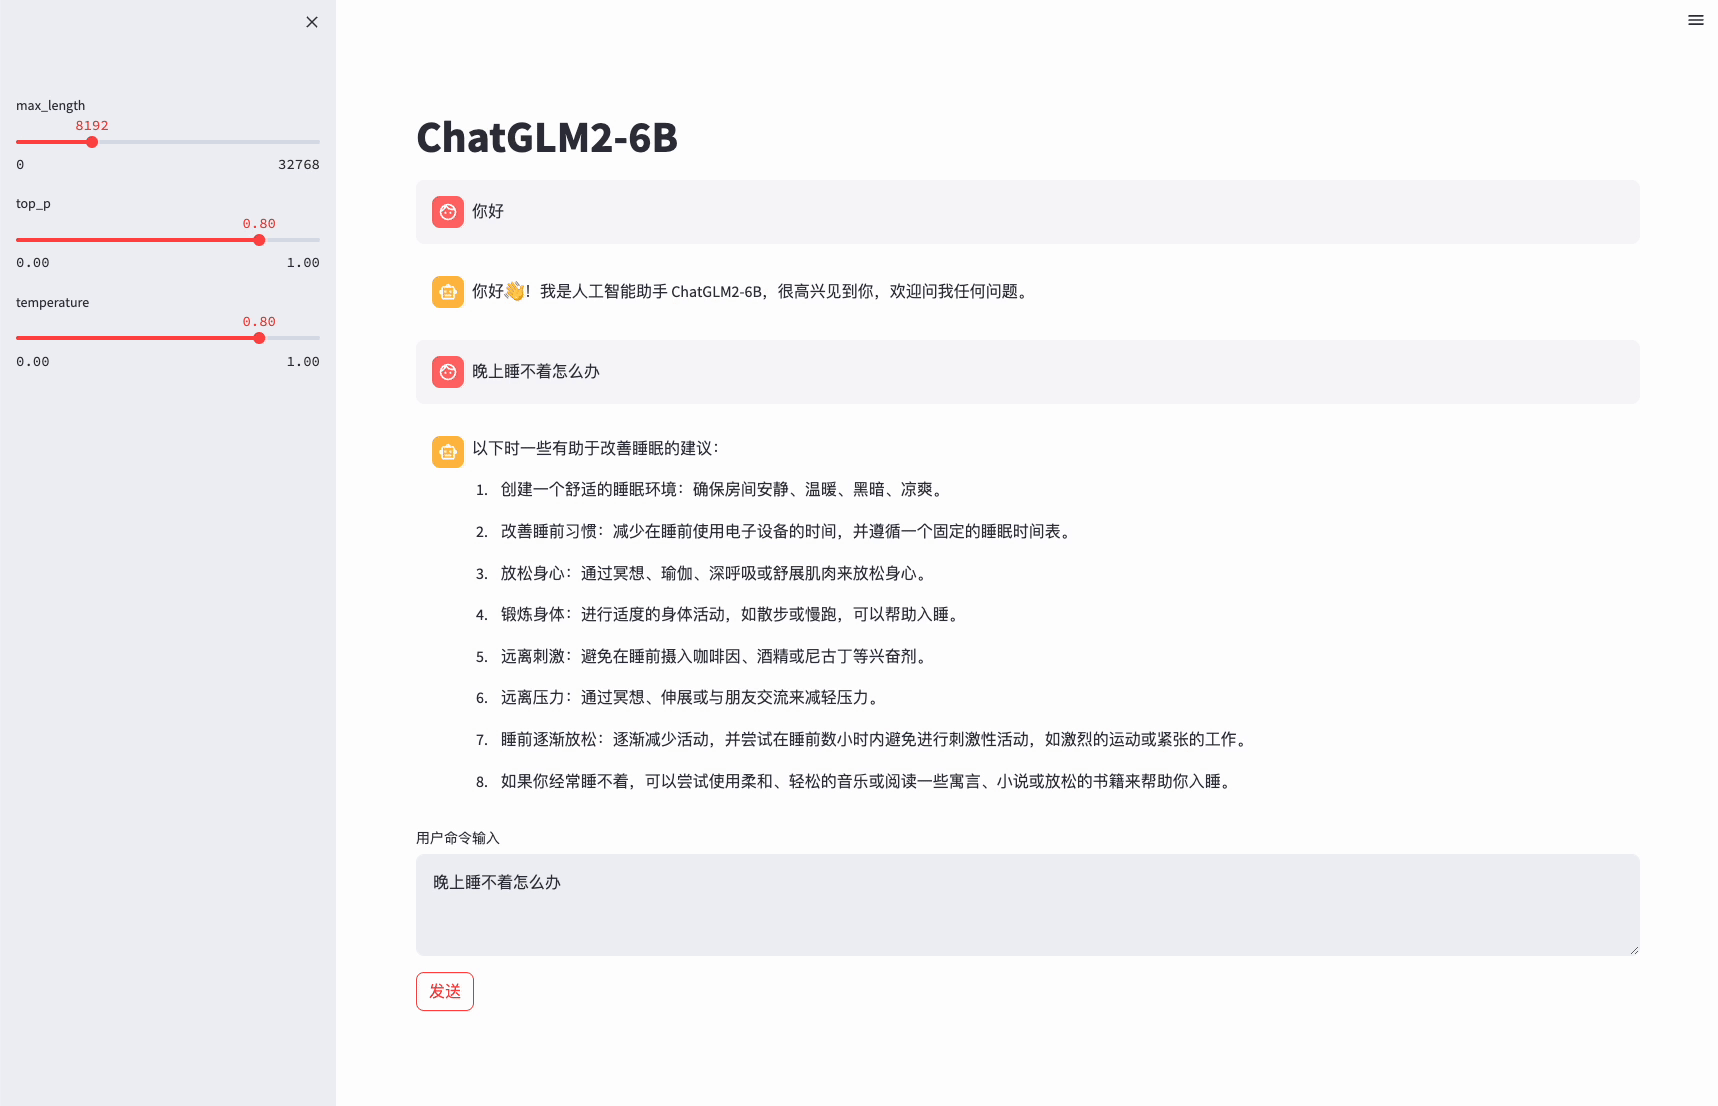
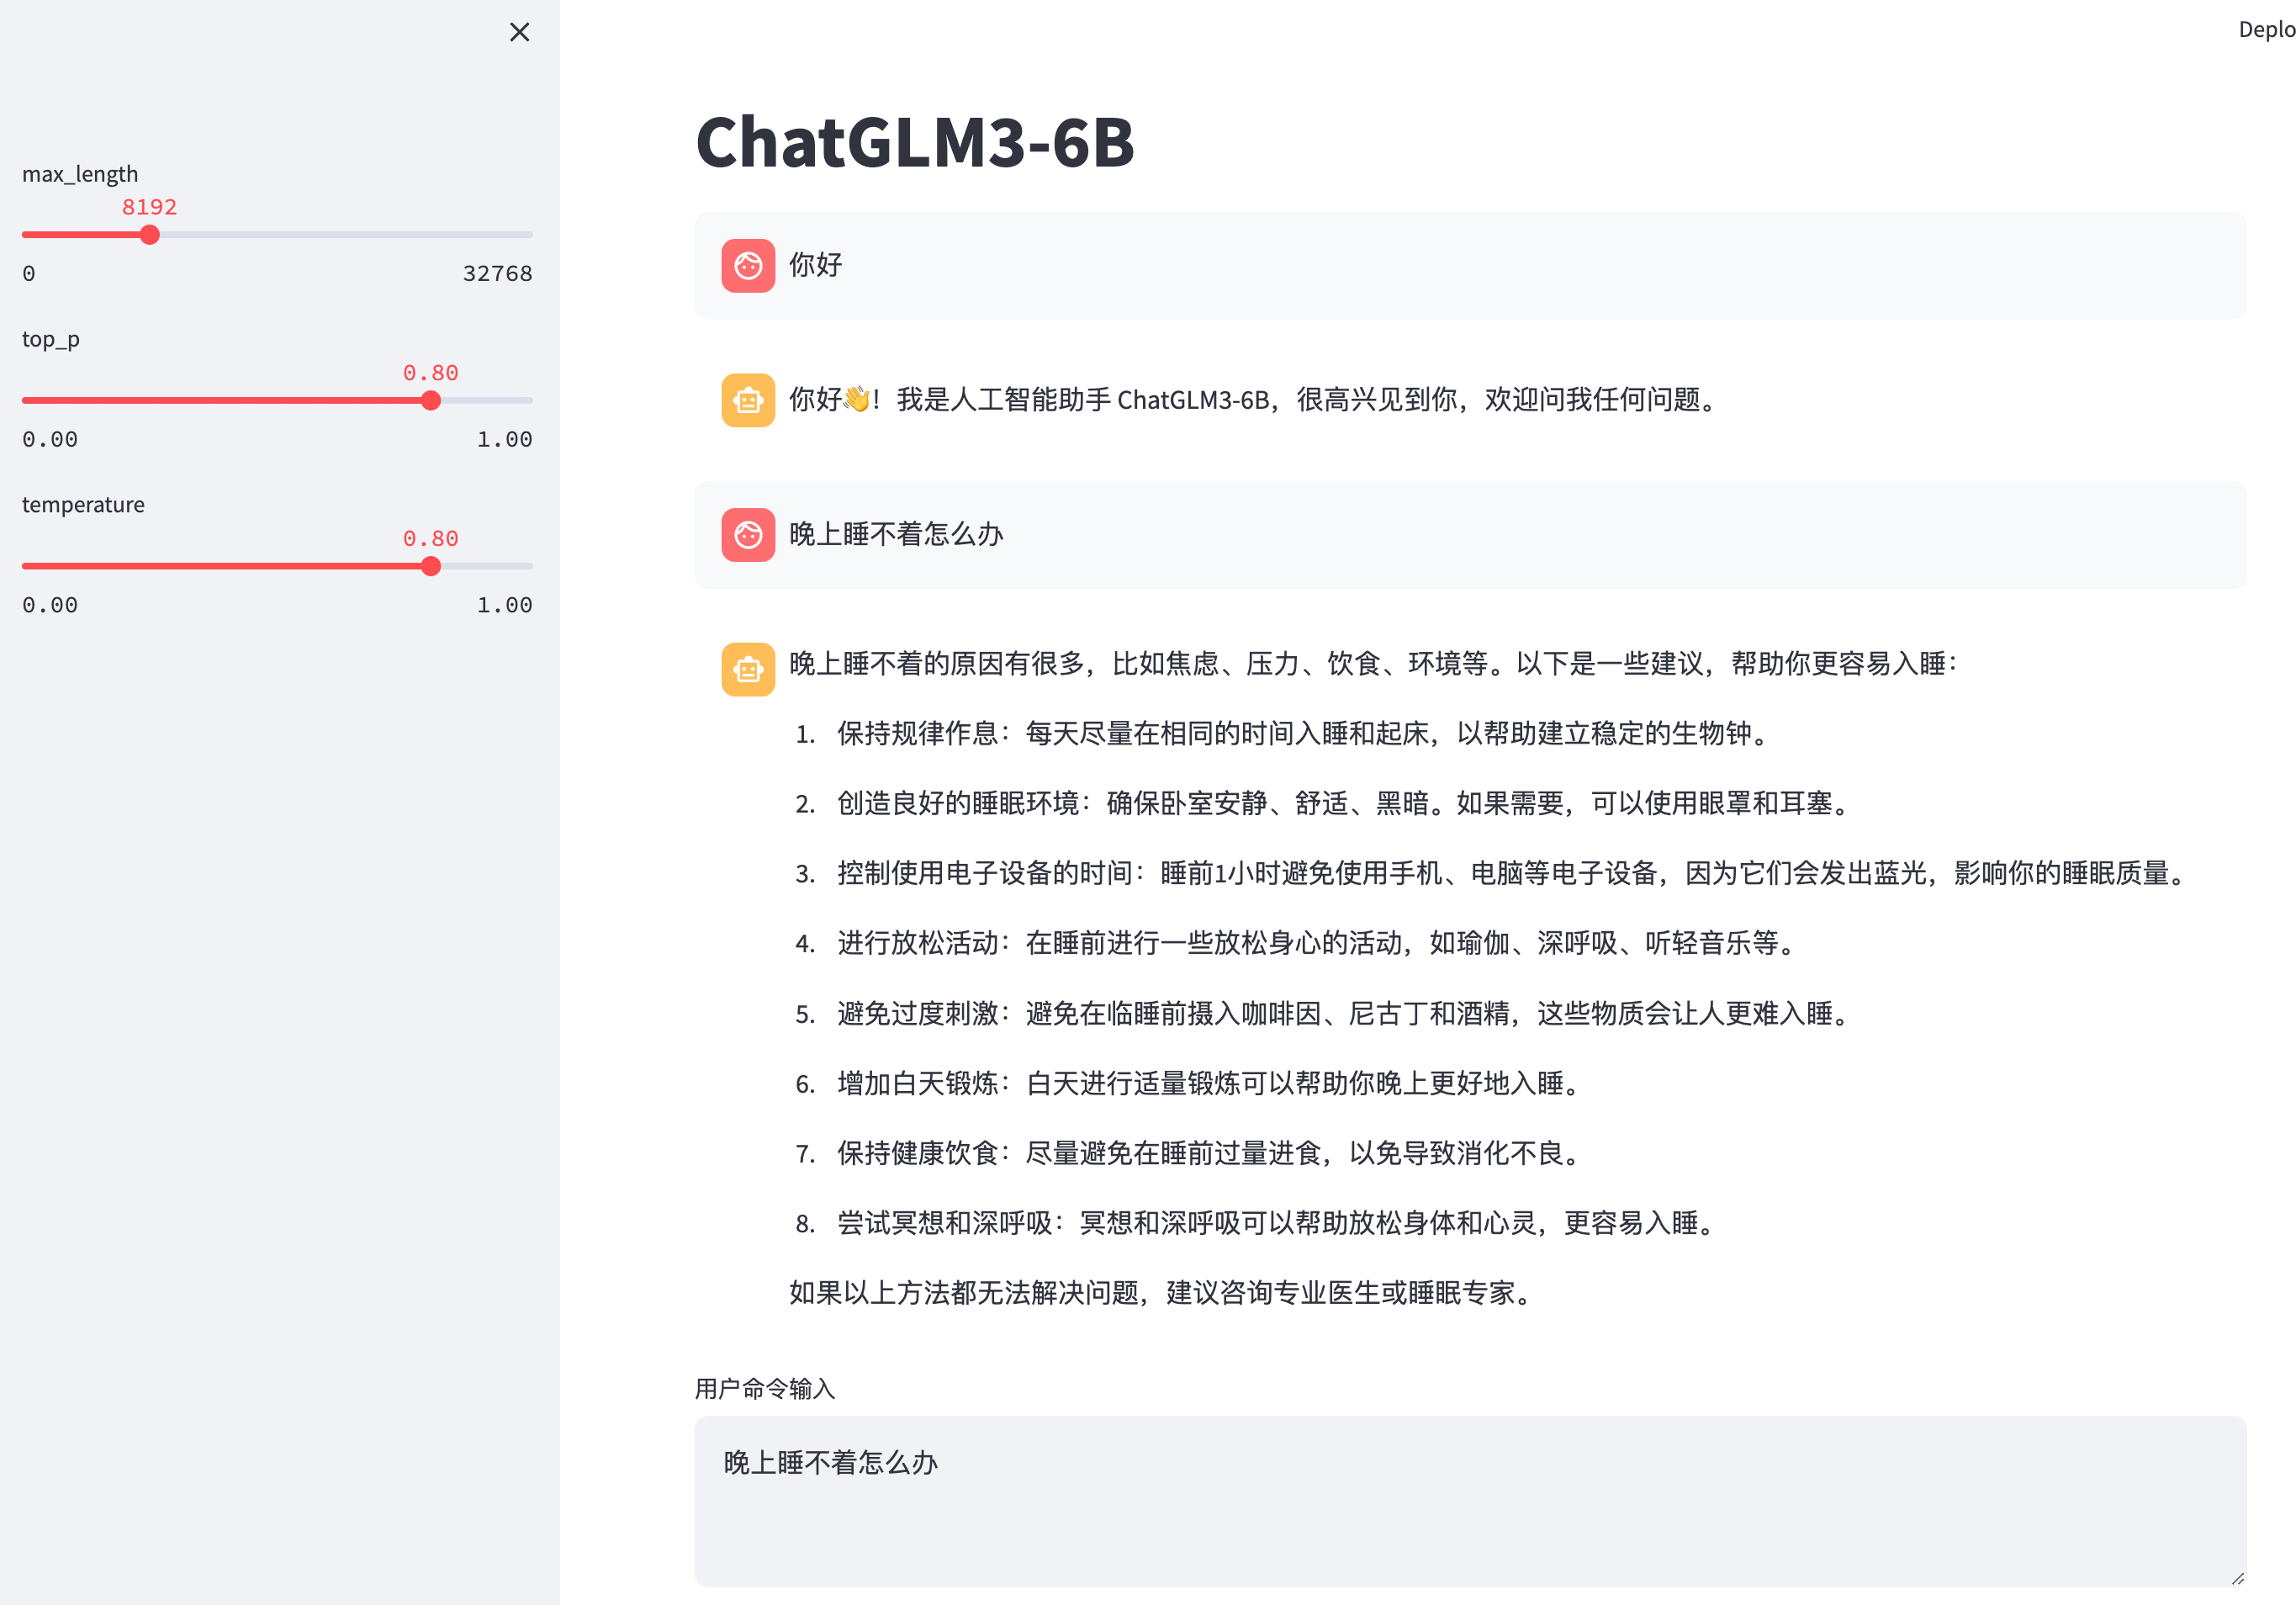
可以通过以下命令启动基于 Gradio 的网页版 demo:
python web_demo.py
可以通过以下命令启动基于 Streamlit 的网页版 demo:
streamlit run web_demo2.py
网页版 demo 会运行一个 Web Server,并输出地址。在浏览器中打开输出的地址即可使用。 经测试,基于 Streamlit 的网页版 Demo 会更流畅。
2.6 命令行对话 Demo
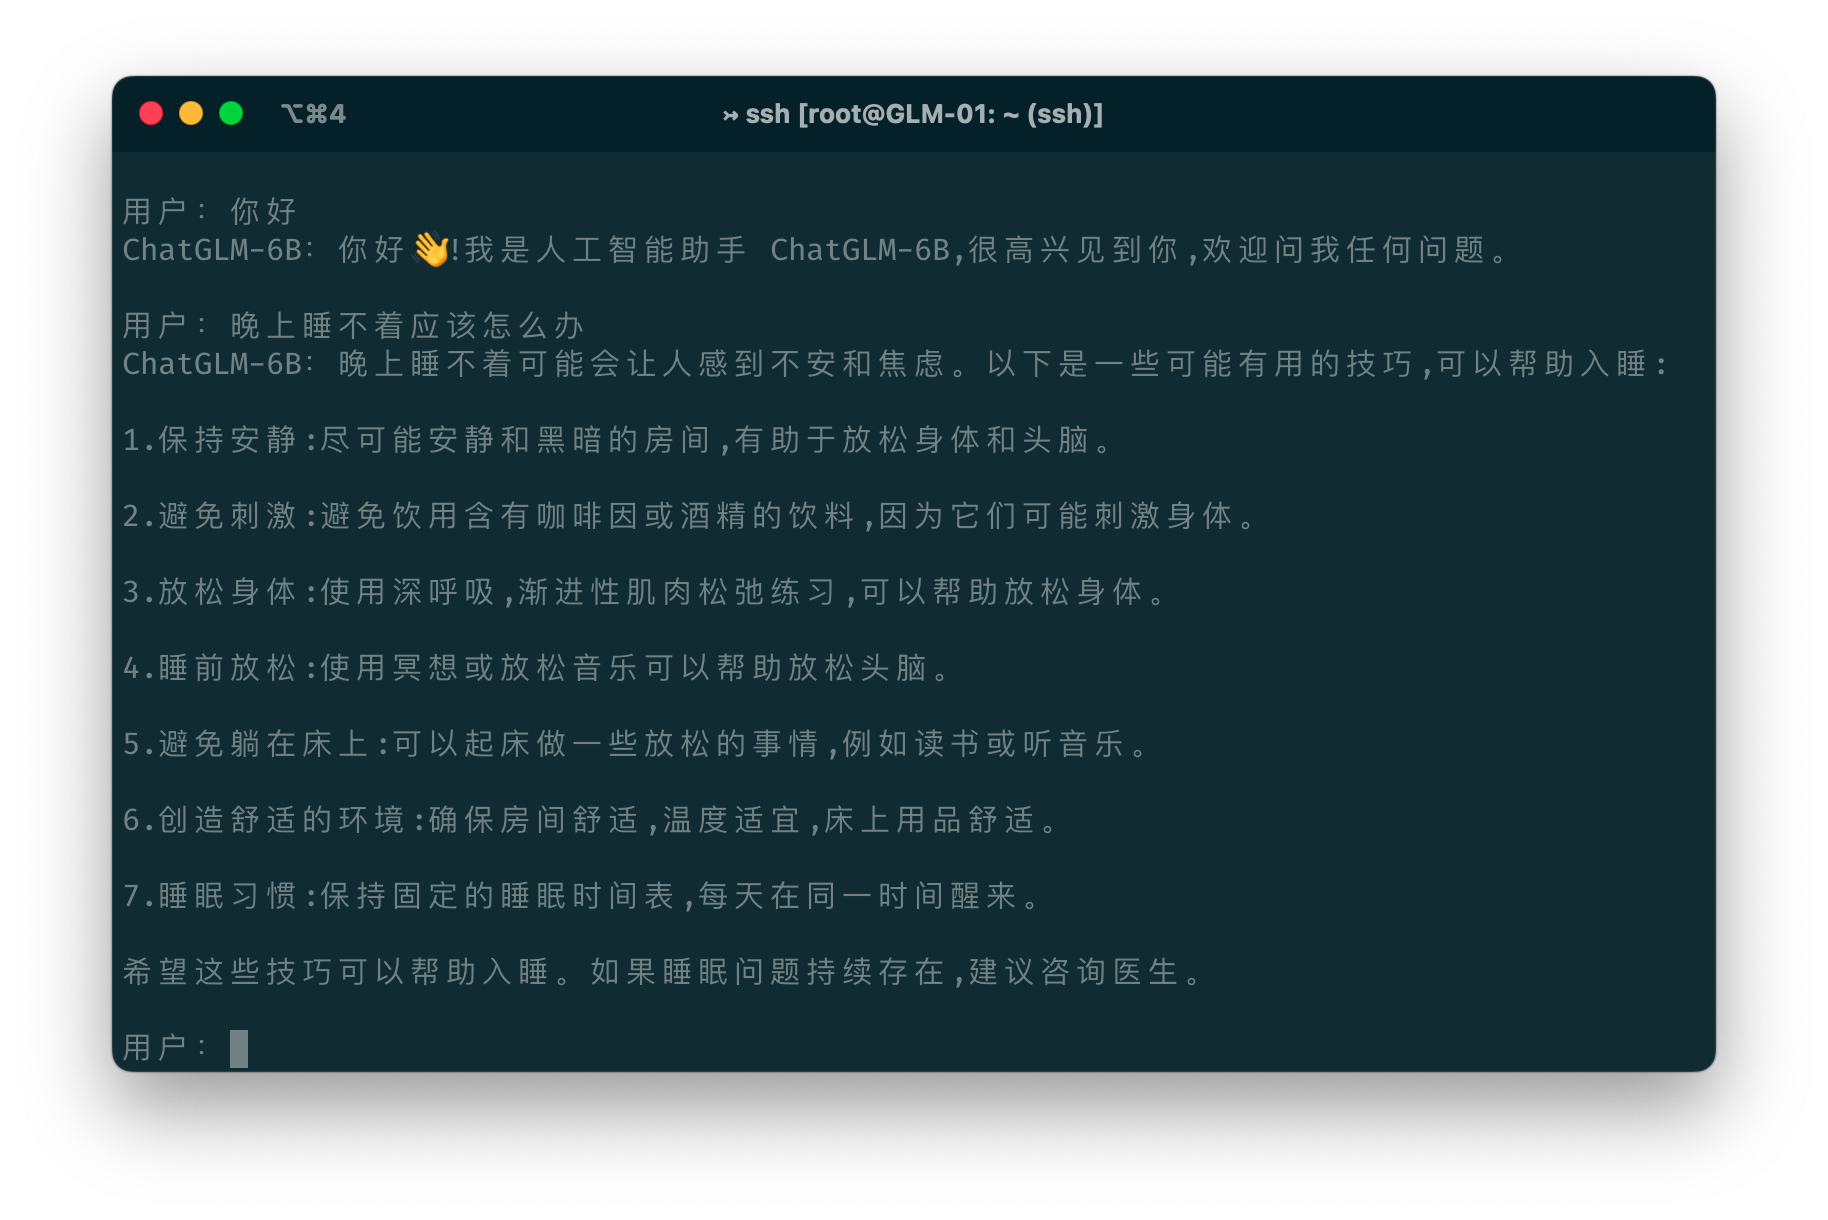
运行仓库中 cli_demo.py:
python cli_demo.py
程序会在命令行中进行交互式的对话,在命令行中输入指示并回车即可生成回复,输入 clear 可以清空对话历史,输入 stop 终止程序。
LangChain Demo
工具调用
关于工具调用的方法请参考 工具调用。
API 部署
可以通过运行仓库中的openai_api.py 进行部署:
python openai_api.py
进行 API 调用的示例代码为
import openai

if __name__ == "__main__":

    openai.api_base = "http://localhost:8000/v1"

    openai.api_key = "none"

    for chunk in openai.ChatCompletion.create(

        model="chatglm3-6b",

        messages=[

            {"role": "user", "content": "你好"}

        ],

        stream=True

    ):

        if hasattr(chunk.choices[0].delta, "content"):

            print(chunk.choices[0].delta.content, end="", flush=True)
3.低成本部署
3.1模型量化
默认情况下,模型以 FP16 精度加载,运行上述代码需要大概 13GB 显存。如果你的 GPU 显存有限,可以尝试以量化方式加载模型,使用方法如下:
model = AutoModel.from_pretrained("THUDM/chatglm3-6b",trust_remote_code=True).quantize(4).cuda()
模型量化会带来一定的性能损失,经过测试,ChatGLM3-6B 在 4-bit 量化下仍然能够进行自然流畅的生成。
3.2CPU 部署
如果你没有 GPU 硬件的话,也可以在 CPU 上进行推理,但是推理速度会更慢。使用方法如下(需要大概 32GB 内存)
model = AutoModel.from_pretrained("THUDM/chatglm3-6b", trust_remote_code=True).float()
3.3 Mac 部署
对于搭载了 Apple Silicon 或者 AMD GPU 的 Mac,可以使用 MPS 后端来在 GPU 上运行 ChatGLM3-6B。需要参考 Apple 的 官方说明 安装 PyTorch-Nightly(正确的版本号应该是2.x.x.dev2023xxxx,而不是 2.x.x)。
目前在 MacOS 上只支持从本地加载模型。将代码中的模型加载改为从本地加载,并使用 mps 后端:
model = AutoModel.from_pretrained("your local path", trust_remote_code=True).to('mps')
加载半精度的 ChatGLM3-6B 模型需要大概 13GB 内存。内存较小的机器(比如 16GB 内存的 MacBook Pro),在空余内存不足的情况下会使用硬盘上的虚拟内存,导致推理速度严重变慢。
3.4 多卡部署
如果你有多张 GPU,但是每张 GPU 的显存大小都不足以容纳完整的模型,那么可以将模型切分在多张GPU上。首先安装 accelerate: pip install accelerate,然后通过如下方法加载模型:
from utils import load_model_on_gpus

model = load_model_on_gpus("THUDM/chatglm3-6b", num_gpus=2)
即可将模型部署到两张 GPU 上进行推理。你可以将 num_gpus 改为你希望使用的 GPU 数。默认是均匀切分的,你也可以传入 device_map 参数来自己指定。
- 项目参考链接
https://github.com/THUDM/ChatGLM3
ChatGLM3-6B:新一代开源双语对话语言模型,流畅对话与低部署门槛再升级的更多相关文章
- 新一代开源Android渠道包生成工具Walle
本文转自:http://tech.meituan.com/android-apk-v2-signature-scheme.html 新一代开源Android渠道包生成工具Walle 新的应用签名方案A ...
- BERT生成能力改进:分离对话生成和对话理解
NLP论文解读 原创•作者 | 吴雪梦Shinemon 研究方向 | 计算机视觉 导读说明: NLP任务大致可以分为NLU(自然语言理解)和NLG(自然语言生成)两种,NLU负责根据上下文去理解当前用 ...
- Impala:新一代开源大数据分析引擎
Impala架构分析 Impala是Cloudera公司主导开发的新型查询系统,它提供SQL语义,能查询存储在Hadoop的HDFS和HBase中的PB级大数据.已有的Hive系统虽然也提供了SQL语 ...
- Impala:新一代开源大数据分析引擎--转载
原文地址:http://www.parallellabs.com/2013/08/25/impala-big-data-analytics/ 文 / 耿益锋 陈冠诚 大数据处理是云计算中非常重要的问题 ...
- 新一代开源即时通讯应用源码定制 运营级IM聊天源码
公司介绍:我们是专业的IM服务提供商!哇呼Chat是一款包含android客户端/ios客户端/pc客户端/WEB客户端的即时通讯系统.本系统完全自主研发,服务器端源码直接部署在客户主机.非任何第三方 ...
- Clusternet - 新一代开源多集群管理与应用治理项目
作者 徐迪,腾讯云容器技术专家. 汝英哲,腾讯云高级产品经理. 摘要 在过去的数年里,云计算领域经历了多次巨大的变革,当前越来越多的组织将应用部署在本地和云上的多个基础设施平台上,这些平台可能是两个公 ...
- WindTerm:新一代开源免费的终端工具,GitHub星标6.6k+,太酷了!
继 Tabby.Warp 后,今天再来给大家推荐一款终端神器--WindTerm,完全开源,在 GitHub 上已经收获 6.6k 的 star. https://github.com/kingToo ...
- 开源的PaaS方案:在OpenStack上部署CloudFoundry (一)简介
目录(?)[-] OpenStack简介 OpenStack是一个美国国家航空航天局和Rackspace合作研发的以Apache许可证授权并且是一个自由软件和开放源代码项目 OpenStack是一个云 ...
- 基于淘宝开源Tair分布式KV存储引擎的整合部署
一.前言 Tair支撑了淘宝几乎所有系统的缓存信息(Tair = Taobao Pair,Pair即Key-Value键值对),内置了三个存储引擎:mdb(默认,类似于Memcache).rdb(类似 ...
- [置顶] 遵循Java EE标准体系的开源GIS服务平台之二:平台部署
传送门 ☞ 系统架构设计 ☞ 转载请注明 ☞ http://blog.csdn.net/leverage_1229 传送门 ☞ GoF23种设计模式 ☞ 转载请注明 ☞ http://blog.csd ...
随机推荐
- Angular报错:Error: Unknown argument: spec
解决方案 使用--skip-tests代替 效果展示 可以看到spec.ts消失了 参考链接 https://stackoverflow.com/questions/62228834/angular- ...
- Vue: 在vscode中添加vue的代码片段
创建vue文件模板 打开vscode,文件–>首选项->用户代码片段,在弹出的搜索框中输入vue,回车 删除原内容,将如下内容粘贴 { "Print to console&quo ...
- PyQt5调用主窗口
import sysfrom ui.MainWindow import Ui_Form from PyQt5.QtWidgets import QApplication, QMainWindowcla ...
- 彻底搞懂Vue针对数组和双向绑定(MVVM)的处理方式
欢迎关注我的博客:https://github.com/wangweianger/myblog Vue内部实现了一组观察数组的变异方法,例如:push(),pop(),shift()等. Object ...
- JavaWeb和MVC三层架构
JavaWeb 概述 网站发布和部署一定要依托技术语言吗: 不一定,一个网站可以直接发布和部署,因为因为浏览器能够识别网页只需要两样东西,网络和静态页面,还有一个装在他们的容器,比如 nginx. 静 ...
- 【go笔记】使用标准库flag解析命令行参数
前言 Go语言标准库中提供了一个包flag可以解析命令行参数. 示例代码:文件读取 package main import ( "fmt" "flag" &qu ...
- SRC赏金猎人—笔记二
以下是如何将速率限制漏洞的影响从低增加到高甚至严重 过程 1.我访问了该网站,然后开始在网站的主文件中手动查找main.js 2.我发现有一个 Web 服务托管在 http:// redacted.c ...
- Vue 框架下提升加载速度的一些实战经验分享
现在前端的框架有很多,甚至两只手已经数不过来,当然也完全没必要全部都学,还是应该深入的学习一两个被广泛使用的就好.其实我和大部分同学的想法一致,认为最值得我们深究的还是主流的 Vue 和 React. ...
- C#是否应该限制链式重载的设计模式?
1.代码的可阅读性 一眼看懂是什么意思,并且能看出生成的SQL是什么样的 var list = db.Queryable<Student>() .GroupBy(it => it.N ...
- 【NestJS系列】连接数据库及优雅地处理响应
前言 Node作为一门后端语言,当然也可以连接数据库,为前端提供CURD接口 我们以mysql为例,自行安装mysql TypeORM TypeORM 是一个ORM框架,它可以运行在 NodeJS.B ...