
超大超详细图解,让你掌握Spark memeoryStore内存管理的精髓
摘要:memoryStore主要是将没有序列化的java对象数组或者序列化的byteBuffer放到内存中。
本文分享自华为云社区《spark到底是怎么确认内存够不够用的?超大超详细图解!让你掌握Spark memeoryStore内存管理的精髓》,作者: breakDraw 。
首先回顾一下spark中的Block Manager和memory Store是做什么的。它主要是将没有序列化的java对象数组或者序列化的byte Buffer放到内存中。
但是这就涉及到一些内存管理的问题,如果放不下,是不是要放磁盘?什么时候认为放不下?这里会一一解读。
MemoryStore的putIterator
这个方法是把一堆values的数组内容放入内存中(本质上就是放到Map<blockId, blockEntry>中。如果发现内存足够,能够申请,则调用putArray把数据写入内存(就是放到map中), 否则就去调用diskStore的接口写入磁盘中。
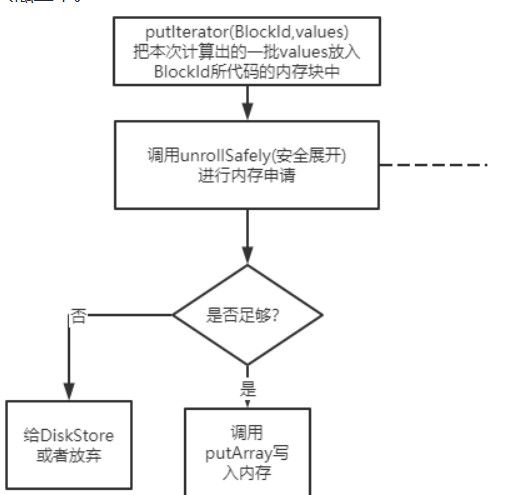
这里我先打住,不直接往下讲,而是给自己假设场景,如果是自己在开发计算引擎,写executor里的block缓存,肯定需要思考这个问题:
什么时候认为内存是足够的?
最简单的一个做法:
- 我给每个memoryStore设定一个阈值MaxMemory,
- 维护一个值currentMemory, 这个值就是memoryStroe里那个Map<BlockId,memoryEntry>所占的大小。
- 然后遍历计算一下输入参数values所占的内存大小 needMemory
- 如果needMemory > maxMemory - currentMemory, 则认为内存不足,写入到磁盘。
这个做法相当于直接把整个values大小都计算好之后,如果ok,马上进行写入内存操作。
如果是memoryStore是单线程的模块那ok, 但如果这个putIterator是一个支持多线程写入的模块呢? 当我觉得100M足够,我写入,可能得花10s, 然后另外一个线程也觉得100M足够,也要写入,结果写到一半发现内存不够,就尴尬了。
因此问题变为:
多线程时,如果确保计算的内存量是有效的?
一种方式,就是每次确定要写入时, 把要写入的这100M的量直接加到currentMemory中。 后面的线程要判断时,直接拿最新的curentMemory判断。
但实际上这个数据并没有真正写入map中, 有可能中间出现写入失败或者线程中断, 那这时候已经被处理过的currentMemory就不好搞了。
所以引入一个概念,叫展开内存unrollMemory。
每个线程都有自己的unrollMemory, 可以理解为该线程 准备 写入到内存中的大小。因此我们统计剩余可写入内存时, 实际上是等于 MaxMemory - currentMemory - 所有线程unrollMemory总和。
但是我们又不能让线程展开的这个值正好把剩余内存占满,所以会设定一个展开内存总和maxUnrollMemory,替代MaxMemory。
因此此时我这个线程可用的剩余内存space,实际上为maxUnrollMemory - cyrrentUnrollMemory。
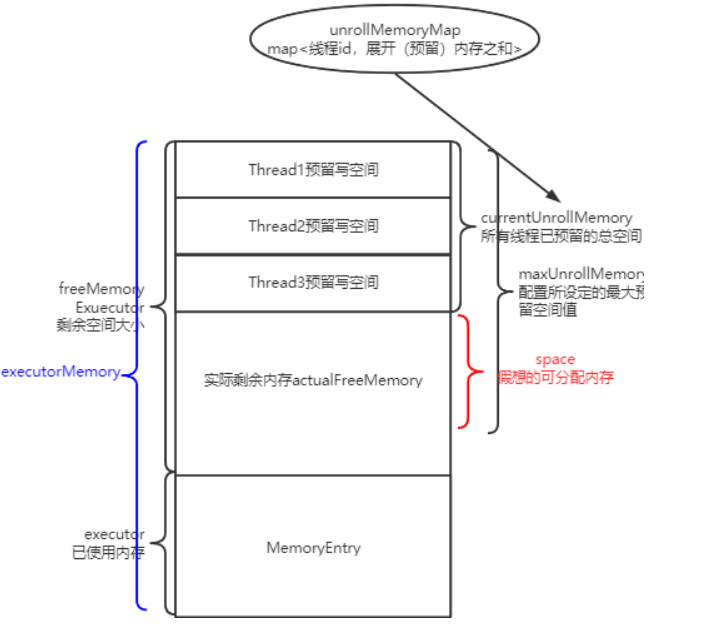
但问题又来了,如果我们假想的可分配内存比实际剩余内存小,怎么办?如下图:
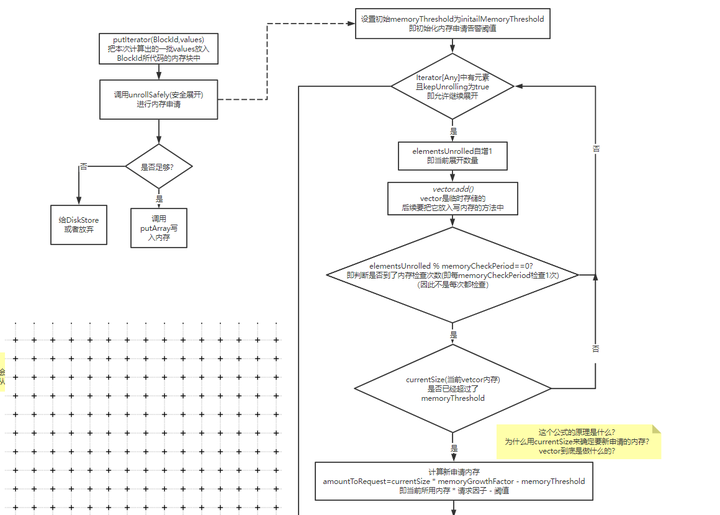
一种方式,是发现假想剩余内存小于实际剩余内存时,认为内存不足,把数据写入磁盘。
但有个问题, 假设我需要写入100M, 实际剩余内存是98M, 其实只差了2M, 那为什么不能挤挤呢?只差2M了!
然而我肯定不能去动其他线程的unrollMemory,毕竟人家都认为自己是ok的准备写入了,你总不能插队吧?如果能动其他线程准备写入的数据,这管理就太复杂了。因此我们需要去已使用内存MemoryEntry里面找, 找一下是不是有比较小的block块,比如有一个块只有5M, 那我就把这个block块放入磁盘,那么我就可以塞进去了!
解答完上述问题后,再学习memoryStore的内存写入管理机制,就容易多了。
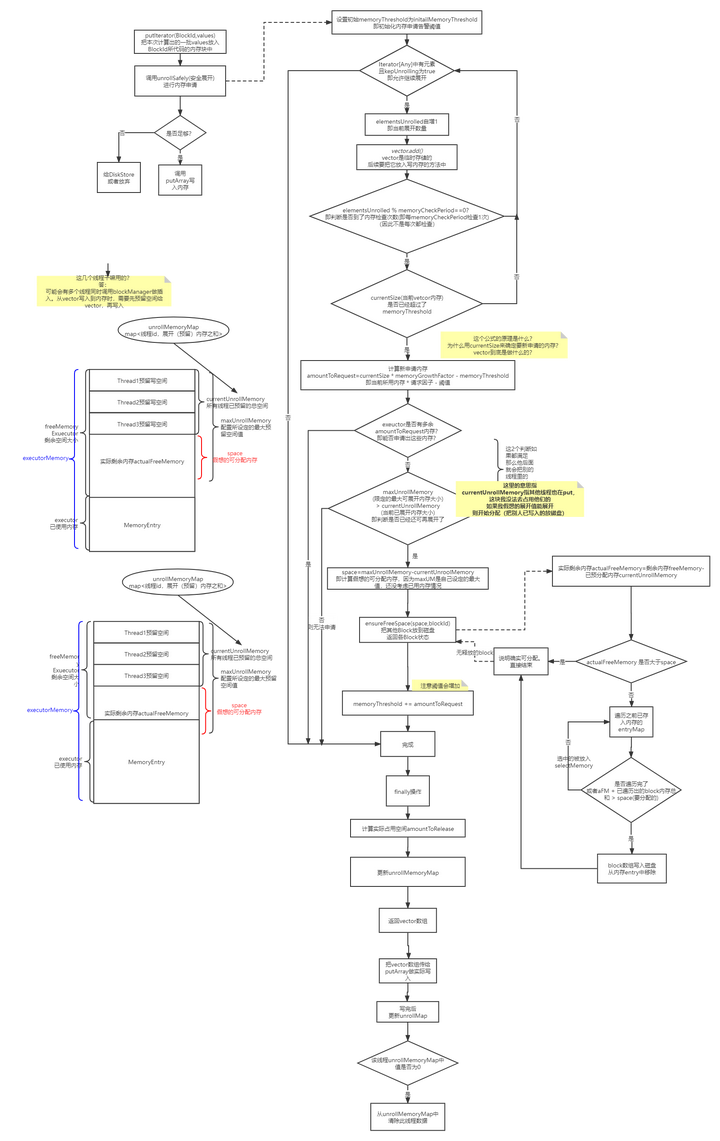
memoryStore完整安全展开流程
1. 计算需要写入的内存大小,是否需要申请新内存
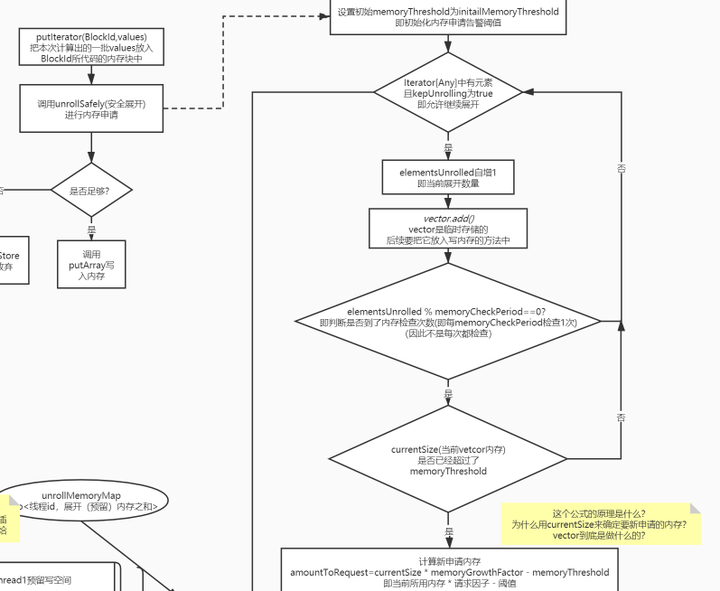
这里的计算不同于上文中提到的直接遍历完之后判断总大小
因为当时传入的是一个迭代器,只能迭代一次,每次迭代时都需要放入vector这个临时存储的列表中,万一超级大,放入vector时超出范围就GG了, 所以它实际时每隔一段就会检查一下是否超出阈值。
2. 计算剩余可用的展开空间
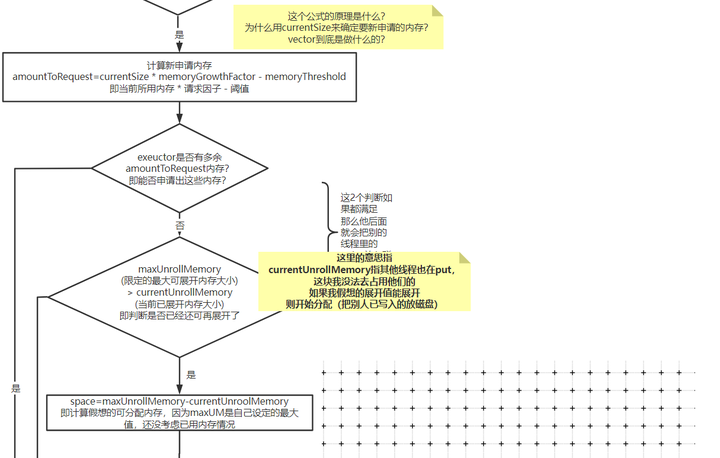
下图标注的地方就是上文最后算出的space:
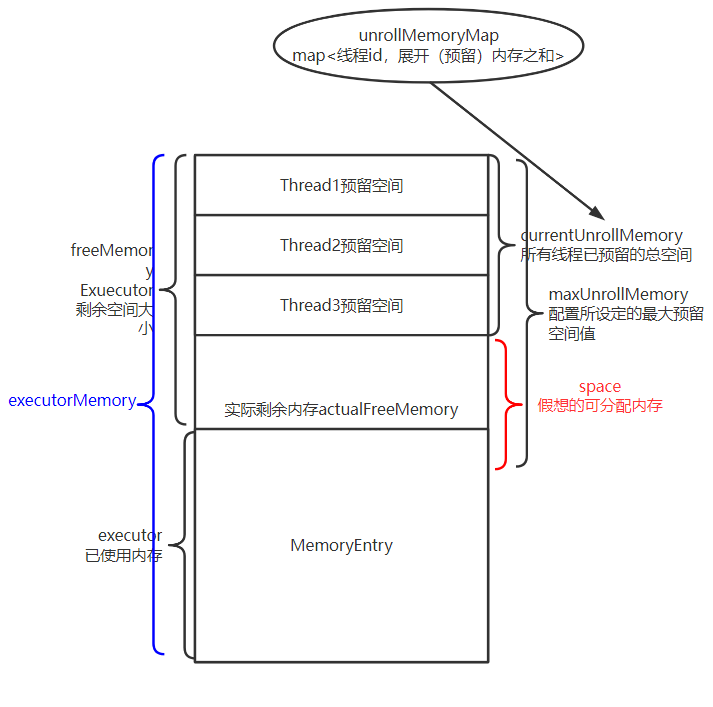
如果小于实际内存,那么就需要去已分配的内存中找,看下能不能选一些小朋友去磁盘中。
spark不足时,检查能否抽一些已分配内存区磁盘
核心方法来自ensureFreeSpace
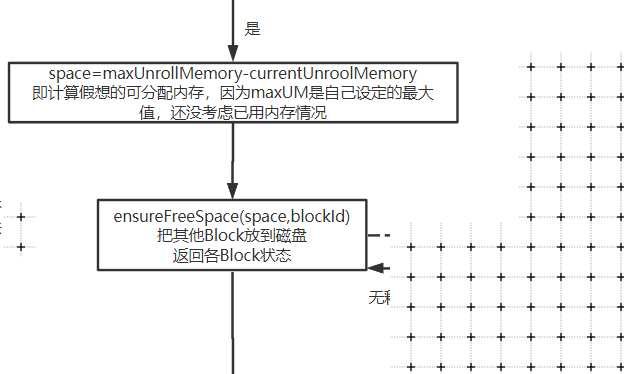
我们看下它的实现:
这个过程比较简单,也没做太多优化,不考虑最优情况,否则会有排序的性能问题。
如果发现抽内存也不够用, 那就直接认为不行了。如果ok,那就认为可行,
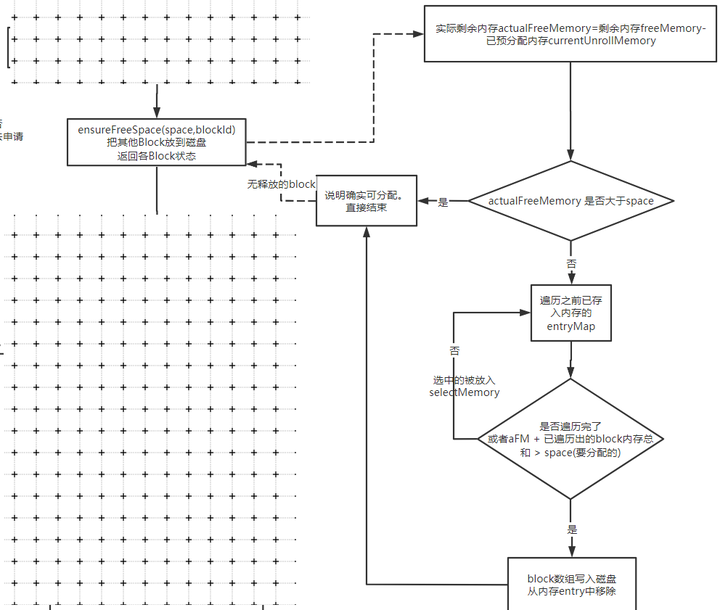
内存足够分配,写入
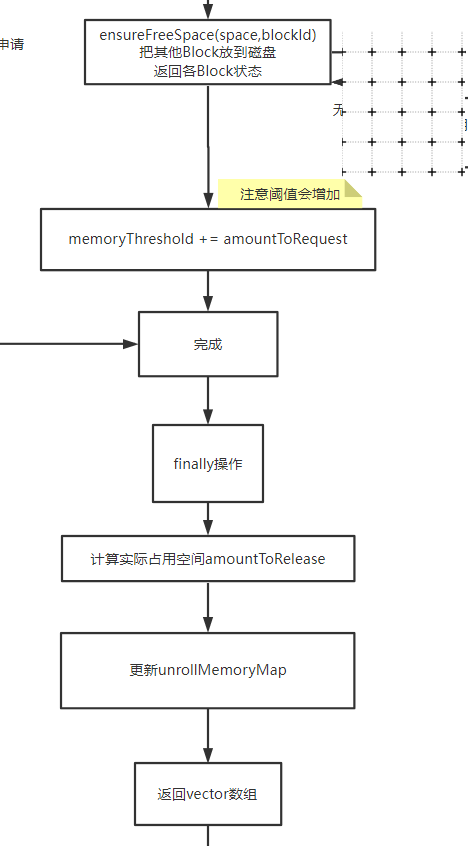
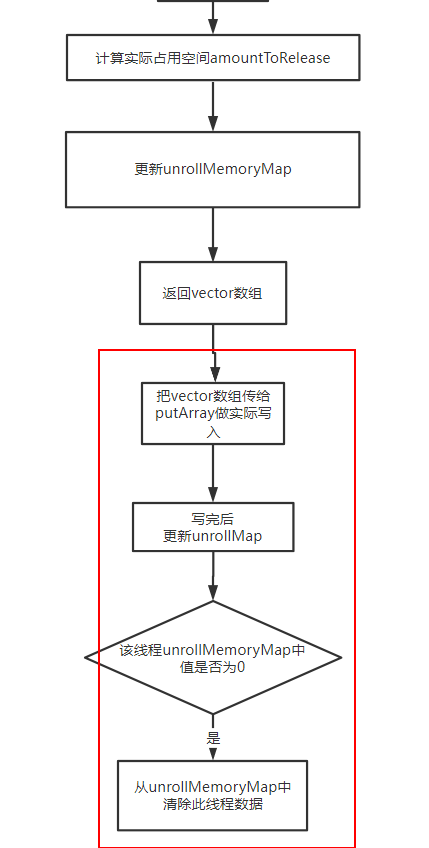
最后会返回一个vector数据
这个vector会拿去做真正的写入操作。
完整高清大图过程:
超大超详细图解,让你掌握Spark memeoryStore内存管理的精髓的更多相关文章
- [转]超详细图解:自己架设NuGet服务器
本文转自:http://diaosbook.com/Post/2012/12/15/setup-private-nuget-server 超详细图解:自己架设NuGet服务器 汪宇杰 ...
- Spark 静态内存管理
作者编辑:杜晓蝶,王玮,任泽 Spark 静态内存管理详解 一. 内容简介 spark从1.6开始引入了动态内存管理模式,即执行内存和存储内存之间可以互相抢占.spark提供两种内存分配模式,即:静态 ...
- Spark(二): 内存管理
Spark 作为一个以擅长内存计算为优势的计算引擎,内存管理方案是其非常重要的模块: Spark的内存可以大体归为两类:execution和storage,前者包括shuffles.joins.sor ...
- Spark内核-内存管理
Spark 集群会启动 Driver 和 Executor 两种 JVM 进程 我们只关注Executor的内存. 分为堆内内存和堆外内存 内存分为 存储内存 : 存储数据用的. 执行内存: 执行sh ...
- 超详细图解:自己架设NuGet服务器
原文:http://diaosbook.com/Post/2012/12/15/setup-private-nuget-server NuGet 是.NET程序员熟知的给.NET项目自动配置安装lib ...
- PyCharm 创建指定版本的 Django (超详细图解)
最近在学习胡阳老师(the5fire)的<Django企业级开发实战>,想要使用pycharm创建django项目时,在使用virtualenv创建虚拟环境后,在pycharm内,无论如何 ...
- Spark 动态(统一)内存管理模型
作者编辑:王玮,胡玉林 一.回顾 在前面的一篇文章中我们介绍了spark静态内存管理模式以及相关知识https://blog.csdn.net/anitinaj/article/details/809 ...
- Apache Spark 内存管理详解(转载)
Spark 作为一个基于内存的分布式计算引擎,其内存管理模块在整个系统中扮演着非常重要的角色.理解 Spark 内存管理的基本原理,有助于更好地开发 Spark 应用程序和进行性能调优.本文旨在梳理出 ...
- spark内存管理器--MemoryManager源码解析
MemoryManager内存管理器 内存管理器可以说是spark内核中最重要的基础模块之一,shuffle时的排序,rdd缓存,展开内存,广播变量,Task运行结果的存储等等,凡是需要使用内存的地方 ...
- spark内存管理详解
Spark 作为一个基于内存的分布式计算引擎,其内存管理模块在整个系统中扮演着非常重要的角色.理解 Spark 内存管理的基本原理,有助于更好地开发 Spark 应用程序和进行性能调优.本文旨在梳理出 ...
随机推荐
- 10.7 多校联测 Day? 总结
打了一场从头到尾稀里糊涂的比赛. 脑子完全不转. 开考看 T1,一开始连逆序对都没看出来.想着把不合法的点两两连边黑白染色(也是够离谱)然后也不知道干了啥(似乎很困),反正一个小时过去了. 就只看出来 ...
- Python 利用pandas和mysql-connector获取Excel数据写入到MySQL数据库
如何将Excel数据插入到MySQL数据库中 在实际应用中,我们可能需要将Excel表格中的数据导入到MySQL数据库中,以便于进行进一步的数据分析和处理.本文将介绍如何使用Python将Excel表 ...
- 实用的命令行终端增强软件:Tabby
还是那句话:出众的软件有很多,适合自己的才是最好的. 一.软件介绍 Tabby是一个开源免费软件,支持Windows.macOS和Linux系统.它提供了一个高度可定制的终端界面,可以通过多种方式添加 ...
- macbook通过虚拟机连接远程linux
之前操作远程虚拟机,都是用window系统,现第一次用linux命令操作一下linux系统. 苹果启动term 输入ssh root@192.168.3.154连接linux,ssh 用户名@服务器i ...
- ACTF 2023 部分WP
来自密码手的哀嚎: 玩不了一点,太难了. CRYPTO MDH Description Malin's Diffile-Hellman Key Exchange. task.sage from has ...
- GitHub 术语解释
为了大家进一步了解和使用 GitHub,在本文中,我们一起来看看 GitHub 的常用术语,也可以说是基本概念: Repository:简称Repo,可以理解为"仓库",我们的项目 ...
- 题解 P9326
前言 数学符号约定 \(n\):任意正整数. \(\#\):从未出现过的小写字母. \(\Sigma\):字符集,这里指小写字母集合. \(S\):最终答案的字符矩阵. 其余符号同题目翻译中所写. 如 ...
- 金蝶对接电商ERP库存数据,实现监听库存变化
金蝶云星空实时库存专题 通过向金蝶库存单据注册Python脚本,用于实时监听库存单据审核/反审核,并且将数据发送到轻易云系统集成平台 .通过集成平台将数据分发到对应的目标系统. 向金蝶的库存单据注册脚 ...
- SpringBoot实战项目:蚂蚁爱购(从零开发)
简介 这是从零开发的SpringBoot实战项目,名字叫蚂蚁爱购. 从零开发项目,视频加文档,十天彻底掌握开发SpringBoot项目. 教程路线是:搭建环境=> 安装软件=> 创建项 ...
- [ABC270Ex] add 1
Problem Statement You are given a tuple of $N$ non-negative integers $A=(A_1,A_2,\ldots,A_N)$ such t ...