
Map Reduce 论文阅读
Map Reduce 是 Google 在 2004 年发表的一篇论文,原文链接 在这 后来 Hadoop 直接内置了这一框架。
读完之后记录一下心得。
主要背景:MapReduce 的出现很具有工程特性,在海量数据出现后,面临的问题是我们如何利用大量的,性能不是很强的服务器对数据进行处理。
主要思想:主要思想也很简单,分治的思想解决问题。把大量的数据划分成较小的,单机可处理的数据,对不同的主机进行任务划分,最终合并结果。主机之间的连接通过。
主要模型:
整个 Map Reduce 阶段如下图所示,先做数据的划分,然后由一个 master 节点划分出不同的 worker,然后分配给不同的 worker 进行 Map 或者 Reduce 操作。Map 后的结果进行 Reduce 操作,得到最终的结果。
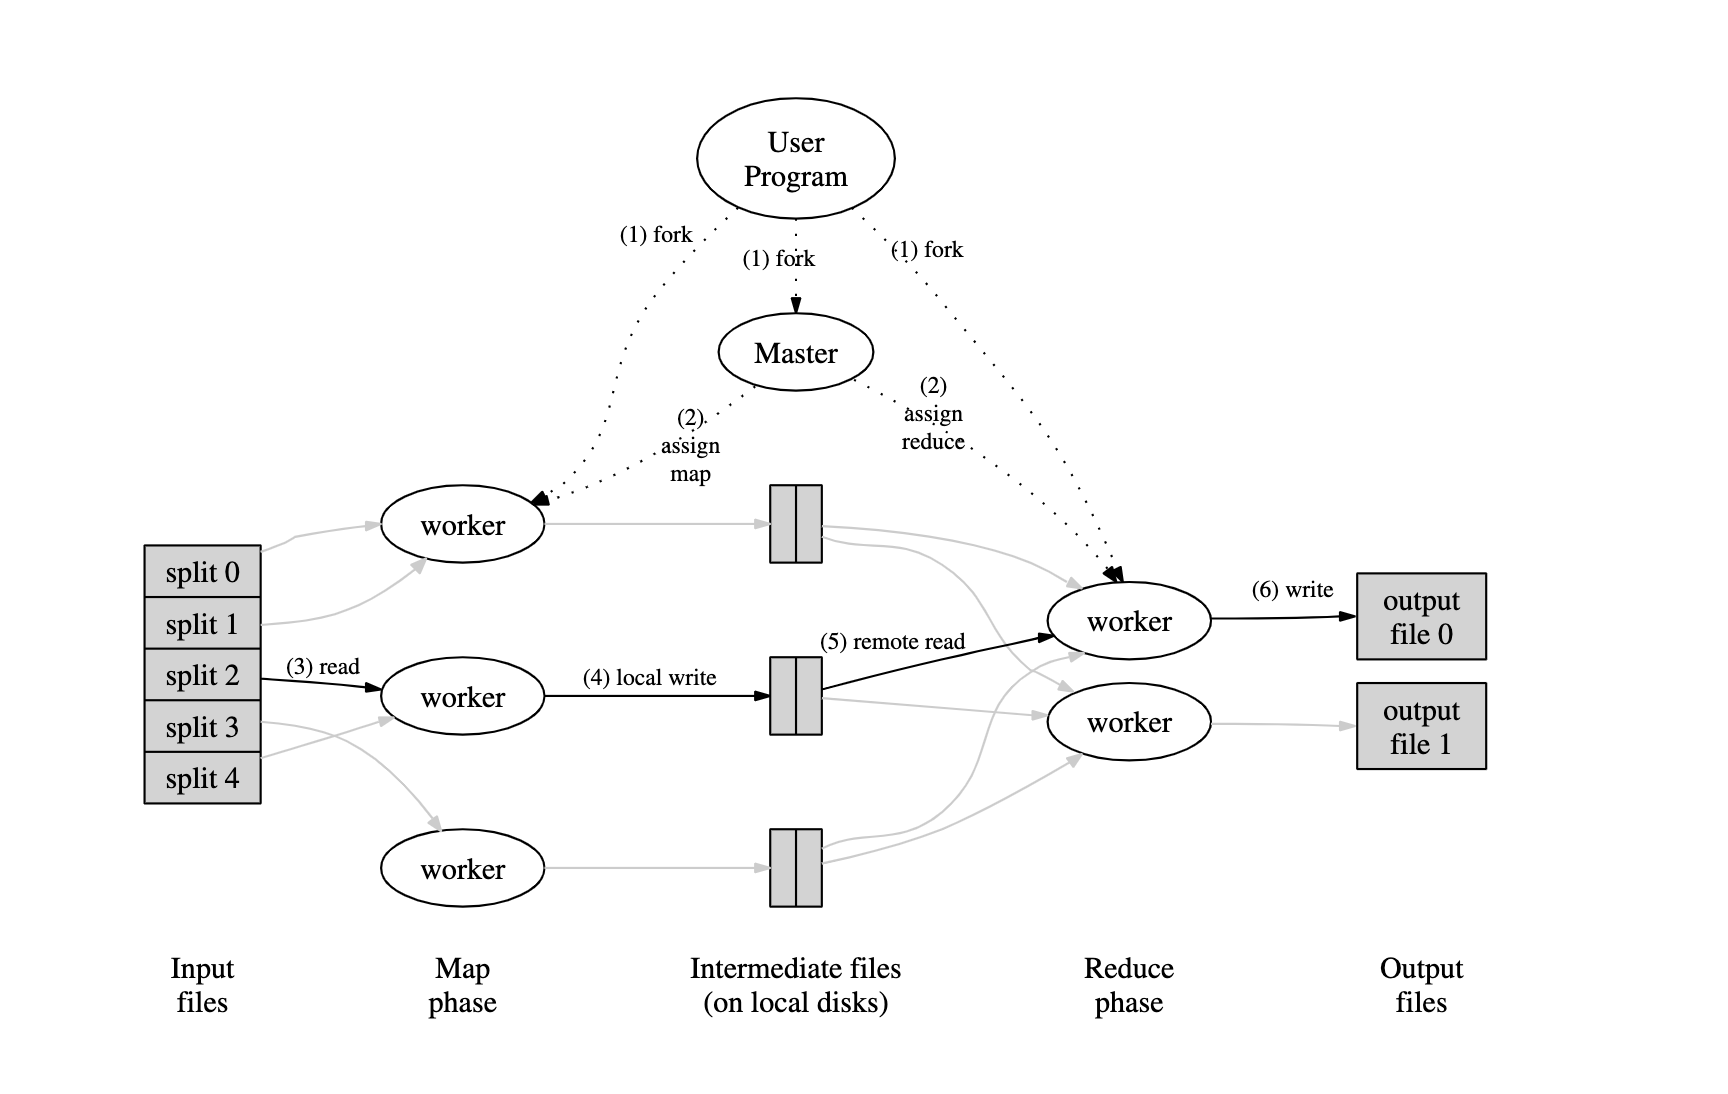
可以看到,主要完成的计算有两个: Map() 和 Reduce() ,这两个函数从语义上已经很好理解,Map 函数的 input 是一组 key-value 对,output 也是一组 key-value 对。主要功能是把原先的大数据量下的 k-v 映射到一个新的空间下的 k-v 。
Reduce 函数的 input 基于 Map 函数产出的 k-v,output 是处理后的结果,但基本都是在原先的数据上做汇总处理。也就是 reduce 的语义。
Google 给出的Map-Reduce 函数模型如下:
map (k1, v1) -> list (k2, v2)

reduce(k2, list(v2)) -> list(v2)
给个栗子,现在有十副牌已经混乱,现在需要在其中找出一副牌,用 MapReduce 的思想来处理这个问题,就可以分成两个阶段,Map 阶段,把 10 副牌进行划分,对每一个划分而言做 Map 操作,这里的 Map 操作可以为把手中的牌分为4类 ♥️,♣️,♦️,♠️这四类。然后对这四类的结果做 Reduce 操作,即从每个花色找到13张不同的牌,这样,就可以找到一副完整的扑克牌。
map(list pokers) :

	for poker in pokers:

		dic[getClass(poker)].append(poker)

	return dic;

reduce(list hearts, list diamonds, list clubs, list spades):

	finish(hearts)

	finish(diamonds)

	finish(clubs)

	finish(spades)
整个过程在理论上而言很简单,也很容易理解。难点主要集中在下面几个部分
- 如何做数据的划分
- 如何对大量的主机做调度
- 如果某一个主机出现了失败如何处理
- 主机间的通信如何管理
失败的处理:
Master 通过心跳机制来维护对 worker 的管理,由于单机的 worker 会先把 Map 的结果存在本地,所以,如果一个 worker A失去维护,那么这个 worker 的任务将会被重新进行编排分给 worker B。并且,所有进行 Reduce 操作的 worker 都会收到通知,因为 Reduce 需要的数据可能会从 A 读,所以,需要通知所有进行 Reduce 操作的 worker。
如果 Master 失败,由于 Master 只有一个,所以 Master 会定期进行状态存储,如果 Master 失败,则人工恢复到最新状态。
一些优化:
Backup Task:因为总的时间会受耗时最长的任务影响,而对于某个耗时最长任务而言,可能不是其任务本身带来的负面影响导致其处理时间延长,而是执行这个任务的机器自身的影响。所以,对于一个快要结束的任务,Master 会为其分配一个 backup 的操作,这个 backup 状态和之前的一样,只是在不同的机器上执行。如果这两个任务中任何一个完成,那么就视为这个任务已经完成。而这个 backup 操作提升时间也是非常显著的,大概能有44%的提升。
Ordering Guarantee:在一个 map 操作完成后,进行 sort 操作,保证其的顺序,这样对于 reduce 而言,在进行查找的时候,会变得非常高效。
Combiner Function:在 map 操作完成后,在本地进行 combine 操作,可以减少数据的传输,也可以减少 Reduce 的数据量。
Map Reduce 论文阅读的更多相关文章
- python基础——map/reduce
python基础——map/reduce Python内建了map()和reduce()函数. 如果你读过Google的那篇大名鼎鼎的论文“MapReduce: Simplified Data Pro ...
- 用通俗易懂的大白话讲解Map/Reduce原理
Hadoop简介 Hadoop就是一个实现了Google云计算系统的开源系统,包括并行计算模型Map/Reduce,分布式文件系统HDFS,以及分布式数据库Hbase,同时Hadoop的相关项目也很丰 ...
- hadoop入门级总结二:Map/Reduce
在上一篇博客:hadoop入门级总结一:HDFS中,简单的介绍了hadoop分布式文件系统HDFS的整体框架及文件写入读出机制.接下来,简要的总结一下hadoop的另外一大关键技术之一分布式计算框架: ...
- Map Reduce和流处理
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 本文由@从流域到海域翻译,发表于腾讯云+社区 map()和reduce()是在集群式设备上用来做大规模数据处理的方法,用户定义一个特定的映射 ...
- 论文阅读笔记六:FCN:Fully Convolutional Networks for Semantic Segmentation(CVPR2015)
今天来看一看一个比较经典的语义分割网络,那就是FCN,全称如题,原英文论文网址:https://people.eecs.berkeley.edu/~jonlong/long_shelhamer_fcn ...
- Python进阶:函数式编程(高阶函数,map,reduce,filter,sorted,返回函数,匿名函数,偏函数)...啊啊啊
函数式编程 函数是Python内建支持的一种封装,我们通过把大段代码拆成函数,通过一层一层的函数调用,就可以把复杂任务分解成简单的任务,这种分解可以称之为面向过程的程序设计.函数就是面向过程的程序设计 ...
- [转] map/reduce
如果你读过Google的那篇大名鼎鼎的论文“MapReduce: Simplified Data Processing on Large Clusters”,你就能大概明白map/reduce的概念. ...
- (转)Python进阶:函数式编程(高阶函数,map,reduce,filter,sorted,返回函数,匿名函数,偏函数)
原文:https://www.cnblogs.com/chenwolong/p/reduce.html 函数式编程 函数是Python内建支持的一种封装,我们通过把大段代码拆成函数,通过一层一层的函数 ...
- 函数式编程(1)-高阶变成(1)-map/reduce
map/reduce Python内建了map()和reduce()函数. 如果你读过Google的那篇大名鼎鼎的论文“MapReduce: Simplified Data Processing on ...
随机推荐
- Nginx简单介绍以及linux下使用Nginx进行负载均衡的搭建
1.Nginx简介 Nginx是一款高性能的http 服务器/反向代理服务器及电子邮件(IMAP/POP3)代理服务器.由俄罗斯的程序设计师Igor Sysoev所开发,官方测试nginx能够支支撑5 ...
- 自己动手撸一个LinkedList
自己动手撸一个LinkedList 1. 原理 LinkedList是基于双链表的动态数组,数据添加删除效率高,只需要改变指针指向即可,但是访问数据的平均效率低,需要对链表进行遍历.因此,Linked ...
- MySQL基础(四)常用函数
转载自 http://blog.csdn.net/evankaka MySQL数据库中提供了很丰富的函数.MySQL函数包括数学函数.字符串函数.日期和时间函数.条件判断函数.系统信息函数.加密函数. ...
- 实验吧之【你真的会PHP吗?】
你真的会PHP吗? 首先刚进网页就是一个have fun 看了源码没有什么提示,也没有输入框,那就打开F12看看 有提示 6c525af4059b4fe7d8c33a.txt 访问 http://c ...
- 域渗透基础之Windows 2012创建域控制器
创建备份域控制器 这里就拿windows 2012 R2来当备份域控 如果一个域内有多个域控制器,可以有如下好处. 提高用户登录的效率:如果同时有多台域控制器对客户提供服务,可以分担审核用户登录身份( ...
- Spring整合Mybatis(IDEA版)
本文适用于初学者: 该文主要教大家如何整合spring和mybatis,整合完成效果,可以从数据库中查询出学生信息: 完整的工程目录如下: 整合思路: 需要spring来管理数据源信息. 需要spri ...
- SpringBoot2.x--入门篇--01--HelloWorld
很多人说,学习springboot至少需要spring基础,servlet基础等等,笔者不敢苟同.凡是有一定java基础的人,都可以直接学习springboot,当学到原理和源码时,通过查缺补漏的方式 ...
- python学习-并发编程(十四)
14.2线程的创建与启动 import threading # 定义一个普通的action函数,该函数准备作为线程执行体 def action(max): for i in range(max): p ...
- 3.如何理解开多线程可以充分利用CPU?
如何理解开多线程可以充分利用CPU? <1>操作系统采用时间片轮转调度算法分配的时间片给每个进程中的线程 <2>操作系统的时间片轮转调度算法分配的时间片 在别的进程中都没有准备 ...
- 利用Arthas定位线上问题实例
前言 Arthas是一个类似于Btrace的JVM在线调试分析工具,具体可参考我之前写的一篇博客:利用JVM在线调试工具排查线上问题.本文分享笔者刚遇到的一个问题,虽然不复杂,但是很典型. 问题与分析 ...