
Hadoop核心组件之MapReduce
MapReduce概述
- Google MapReduce的克隆版本
- 优点:海量数据的离线处理,易开发,易运行
- 缺点:实时流式计算
Hadoop MapReduce是一个软件框架,用于轻松编写应用程序,以可靠,容错的方式在大型集群(数千个节点)的商用硬件上并行处理大量数据(多TB数据集)
MapReduce编程模型
思想:分而治之
MapReduce作业通常将输入数据集拆分为独立的块,这些块由map任务以完全并行的方式处理。框架对map的输出进行排序,然后输入到reduce任务。通常,作业的输入和输出都存储在文件系统中。该框架负责调度任务,监视它们并重新执行失败的任务。
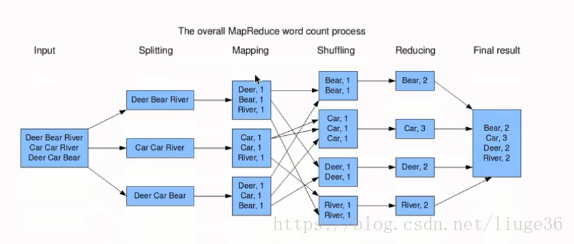
案例;统计一篇文章,各个单词出现的次数
Input数据输入
Splitting:拆分数据读取到各个节点
Mapping:为每一个单词赋1,不会做合并操作
Shuffling: 重新洗牌(指定规则),这里把相同单词发到同一个节点去
Reducing : 统计合并相同单词的次数
最后把结果写到一个文件中去就ok了
Hadoop核心组件之MapReduce的更多相关文章
- Hadoop框架:MapReduce基本原理和入门案例
本文源码:GitHub·点这里 || GitEE·点这里 一.MapReduce概述 1.基本概念 Hadoop核心组件之一:分布式计算的方案MapReduce,是一种编程模型,用于大规模数据集的并行 ...
- Hadoop 中利用 mapreduce 读写 mysql 数据
Hadoop 中利用 mapreduce 读写 mysql 数据 有时候我们在项目中会遇到输入结果集很大,但是输出结果很小,比如一些 pv.uv 数据,然后为了实时查询的需求,或者一些 OLAP ...
- 从Hadoop框架与MapReduce模式中谈海量数据处理(含淘宝技术架构) (转)
转自:http://blog.csdn.net/v_july_v/article/details/6704077 从hadoop框架与MapReduce模式中谈海量数据处理 前言 几周前,当我最初听到 ...
- 每天收获一点点------Hadoop之初始MapReduce
一.神马是高大上的MapReduce MapReduce是Google的一项重要技术,它首先是一个编程模型,用以进行大数据量的计算.对于大数据量的计算,通常采用的处理手法就是并行计算.但对许多开发者来 ...
- Hadoop权威指南:MapReduce应用开发
Hadoop权威指南:MapReduce应用开发 [TOC] 一般流程 编写map函数和reduce函数 编写驱动程序运行作业 用于配置的API Hadoop中的组件是通过Hadoop自己的配置API ...
- hadoop系列三:mapreduce的使用(一)
转载请在页首明显处注明作者与出处 http://www.cnblogs.com/zhuxiaojie/p/7224772.html 一:说明 此为大数据系列的一些博文,有空的话会陆续更新,包含大数据的 ...
- hadoop系列四:mapreduce的使用(二)
转载请在页首明显处注明作者与出处 一:说明 此为大数据系列的一些博文,有空的话会陆续更新,包含大数据的一些内容,如hadoop,spark,storm,机器学习等. 当前使用的hadoop版本为2.6 ...
- 【Big Data - Hadoop - MapReduce】初学Hadoop之图解MapReduce与WordCount示例分析
Hadoop的框架最核心的设计就是:HDFS和MapReduce.HDFS为海量的数据提供了存储,MapReduce则为海量的数据提供了计算. HDFS是Google File System(GFS) ...
- 初学Hadoop之图解MapReduce与WordCount示例分析
Hadoop的框架最核心的设计就是:HDFS和MapReduce.HDFS为海量的数据提供了存储,MapReduce则为海量的数据提供了计算. HDFS是Google File System(GFS) ...
随机推荐
- HTML5实时语音通话聊天,MP3压缩传输3KB每秒
目录 一.把玩方法 二.技术特性 (1)数据传输 (2)音频采集和编码 (3)音频实时接收和播放 三.应用场景 自从Recorder H5 GitHub开源库优化后,对边录边转码成小语音片段文件实时上 ...
- Hadoop RPC机制详解
网络通信模块是分布式系统中最底层的模块,他直接支撑了上层分布式环境下复杂的进程间通信逻辑,是所有分布式系统的基础.远程过程调用(RPC)是一种常用的分布式网络通信协议,他允许运行于一台计算机的程序调用 ...
- Leetcode之二分法专题-704. 二分查找(Binary Search)
Leetcode之二分法专题-704. 二分查找(Binary Search) 给定一个 n 个元素有序的(升序)整型数组 nums 和一个目标值 target ,写一个函数搜索 nums 中的 t ...
- 感受一下.net中用 lambda与 linq 做数据集过滤的不同
lambda: ids.Add( _hahahacontext .hahahamodel .FirstOrDefault( a => //lambda做过滤 a.name == "张宏 ...
- 持续集成高级篇之Jenkins Pipeline git拉取
系列目录 PipeLine中拉取远程git仓库 前面讲自由式任务的时候,我们可以看到通过自由式job里提供的图形界面配置git拉取非常方便的,实际上使用PipeLine也并不复杂.这一节我们展示一下如 ...
- CF 987C Three displays DP或暴力 第十一题
Three displays time limit per test 1 second memory limit per test 256 megabytes input standard input ...
- adb 端口冲突
第一种方法:可以设置另一个端口 第二种方法: http://blog.csdn.net/hwl1314/article/details/52538023 Android studio 5037端口被占 ...
- Three.js 开发机房(四)
这一节我们讲讲怎么画机柜,其实机柜如果作的复杂一点.逼真一点可以用3D建模工具,不过一般的项目中也不用做的那么麻烦,那我们就可以将机柜抽象以下,首先它是一块具有长宽高的立方体铁块,然后我们从中间在掏掉 ...
- 让docker中的mysql启动时自动执行sql
在用docker创建mysql容器的时,有时候我们期望容器启动后数据库和表已经自动建好,初始化数据也已自动录入,也就是说容器启动后我们就能直接连上容器中的数据库,使用其中的数据了. 其实mysql的官 ...
- 【Offer】[37] 【序列化二叉树】
题目描述 思路分析 测试用例 Java代码 代码链接 题目描述 请实现两个函数,分别用来序列化和反序列化二叉树. 二叉树的序列化是指:把一棵二叉树按照某种遍历方式的结果以某种格式保存为字符串,从而使得 ...