
爬虫模块介绍--Beautifulsoup (解析库模块,正则)
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你节省数小时甚至数天的工作时间.你可能在寻找 Beautiful Soup3 的文档,Beautiful Soup 3 目前已经停止开发,官网推荐在现在的项目中使用Beautiful Soup 4, 移植到BS4
re模块也是解析库(解析库只能解析HTML文档)
#安装 Beautiful Soup

pip install beautifulsoup4

#安装解析器

Beautiful Soup支持Python标准库中的HTML解析器,还支持一些第三方的解析器,其中一个是 lxml .根据操作系统不同,可以选择下列方法来安装lxml:

$ apt-get install Python-lxml

$ easy_install lxml

$ pip install lxml

另一个可供选择的解析器是纯Python实现的 html5lib , html5lib的解析方式与浏览器相同,可以选择下列方法来安装html5lib:

$ apt-get install Python-html5lib

$ easy_install html5lib

$ pip install html5lib
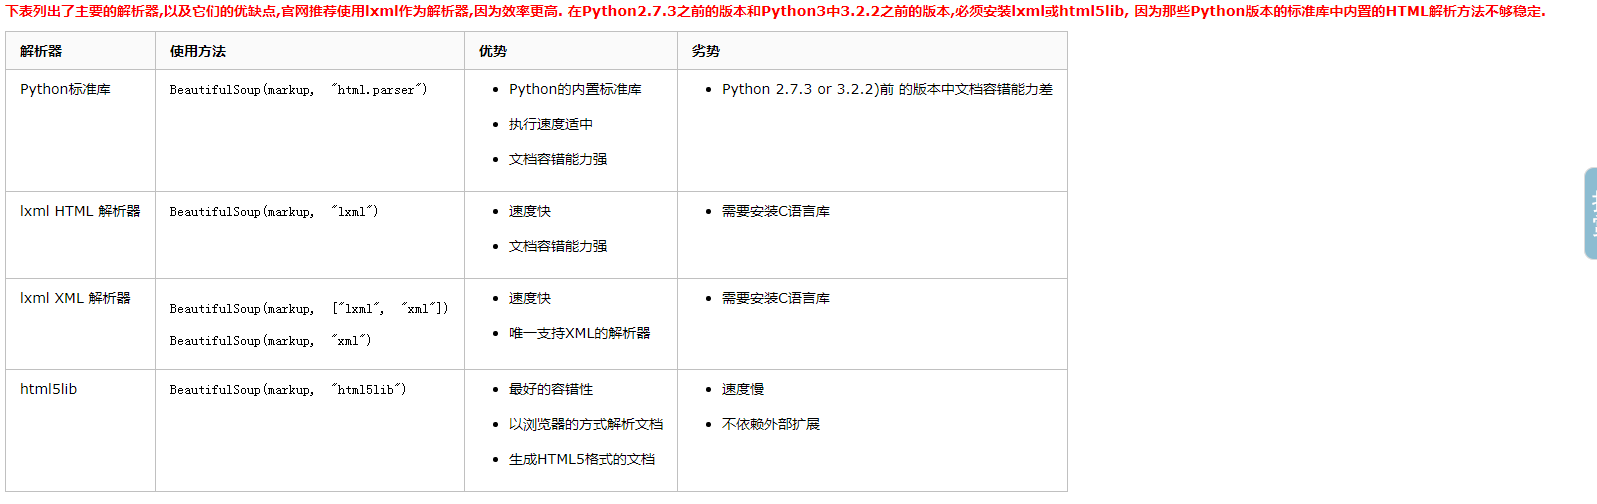
bs4模块下的方法
html_doc = """
<html><head><title>The Dormouse's story</title></head>
<body>
<p id="my p" class="title"><b id="bbb" class="boldest">The Dormouse's story</b>
</p>

<p class="story">Once upon a time there were three little sisters; and their names were
<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,
<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and
<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;
and they lived at the bottom of a well.</p>

<p class="story">...</p>
"""

from bs4 import BeautifulSoup
soup = BeautifulSoup(html_doc,'lxml')

# prettify就是让文档排版变得好看
res = soup.prettify()
# print(res)

'''遍历文档树(HTML标签就是文档树,可以遍历可以搜索),遍历文档树市存在多个标签则只返回第一个'''
print(type(soup.p)) # 从上往下找到第一个的p标签,是一个tag对象,可以以对象的方式调用
print(soup.p.find(name='b'))  # 从对象里找到b标签又是一个对象
print(soup.p.find(name='b').text) # 用text才是文档内容
print(soup.p.name) # 获取标签名
print(soup.p.attrs) # 获取标签类名以字典返回,id是唯一的,class可能是多个,所以在字典中以class:[]形式返回
print(soup.p.attrs.get('class')[0]) # 这个就是取出class索引位0的类名
print(soup.p.strings)  # text会把所有的文字拼接成一个字符串,当标签下有多个内容就要用strings取值,把不同的类型放入列表,是一个生成器,标签下内容最少有一个时就能取到,否则取出的就是None
print(soup.p.string)  # 当标签下只有一个内容,可以用string,如果是多个内容则无法取值,因为不知道要取哪一个
print(soup.body.p.b)  # 遍历文档树的嵌套选择,就是一层一层的往下走
print(soup.p.contents)  # p标签下所有子节点
print(soup.p.contents) # p下所有子节点

print(soup.p.children) # 得到一个迭代器,包含p下所有子节点
for i,child in enumerate(soup.p.children):
    print(i,child)

print(soup.p.descendants) #获取子孙节点,p下所有的标签都会选择出来
for i,child in enumerate(soup.p.descendants):
    print(i,child)

print(soup.a.parent) #获取a标签的父节点
print(soup.a.parents) #找到a标签所有的祖先节点,父亲的父亲,父亲的父亲的父亲...

print(soup.a.next_sibling) #下一个兄弟
print(soup.a.previous_sibling) #上一个兄弟

print(list(soup.a.next_siblings)) #下面的兄弟们=>生成器对象
print(soup.a.previous_siblings) #上面的兄弟们=>生成器对象

'''搜索文档树'''
# 有五种过滤器: 字符串、正则表达式、列表、True、方法
# name = None 标签名
# attrs={} 属性
# recursive=True 默认是True,如果是False就表示不递归
# text=None 文本内容
# **kwargs

# 字符串形式
ret = soup.find(name='p') # name的值就是标签名,这个就是字符串匹配
ret = soup.find(attrs={'class':'title'})  # 属性查找,就是查找类名或者id等名字的标签
res = soup.find(text="The Dormouse's story") # 查找这个字符串的标签

# 正则形式
import re
ret = soup.find(name=re.compile('^b'))  # 用正则找到b开头的标签
ret = soup.find(attrs={'class':re.compile('^t')}) # 用正则找到用以t开头的类名标签
ret = soup.find(name='title',text=re.compile('^T')) # 查找文本,有T字符开头的标签

# 列表形式
ret = soup.find_all(name=['b','p']) # 查找多种类型的标签,直接以列表传入
ret = soup.find_all(text=["The Dormouse's story"])  # 查找包含多个字符的列表,可以传入列表
ret = soup.find_all(name=True) # 找出所有的标签
ret = soup.find_all(attrs={'id':True})  # 找出所有属性有id的标签
ret = soup.find_all(name='p',attrs={'id':True}) # 找出所有有id的p标签

# 方法 固定写法
def has_class_but_no_id(tag): # 参数tag是必须传的
    # 判断当前标签有class属性和没有id属性的的标签
    return tag.has_attr('class') and not tag.has_attr('id')
ret = soup.find_all(name=has_class_but_no_id) # 这里传入
print(ret)

# 其他参数
ret = soup.find_all(name='b',recursive=False) # 不递归查找,soup就是整个html标签,这个标签下没有p所以返回空列表
ret = soup.find_all(name='a',limit=2) # a标签有多个,limit设置的参数就是表示取查找到的前几个
ret = soup.find_all(class_='story') # 查找class(id)为story的标签可以这样写,class是python中的关键字,所以要加个 _ 这个参数就给了**kwargs

# css选择器,bs4模块也支持css选择器
print(soup.p.select('.sister')) # 查找类名是sister的标签
print(soup.select('.sister span')) # 查找类名是sister下的span标签

print(soup.select('#link1')) # 查找id是#link1的标签
print(soup.select('#link1 span')) # 查找id是#link1下的span标签标签

print(soup.select('#list-2 .element.xxx'))
print(soup.select('#list-2')[0].select('.element')) # 找list-2的空间,加0就是找到的是列表,所以要取第0位,取出来还是tag对象,继续往下找类名
print(soup.select('#list-2 h1')[0].attrs) # 获取控件的属性
print(soup.select('#list-2 h1')[0].get_text()) # 获取控件的内容
爬虫模块介绍--Beautifulsoup (解析库模块,正则)的更多相关文章
- BeautifulSoup解析库的介绍和使用
### BeautifulSoup解析库的介绍和使用 ### 三大选择器:节点选择器,方法选择器,CSS选择器 ### 使用建议:方法选择器 > CSS选择器 > 节点选择器 ## 测试文 ...
- Python爬虫之Beautiful Soup解析库的使用(五)
Python爬虫之Beautiful Soup解析库的使用 Beautiful Soup-介绍 Python第三方库,用于从HTML或XML中提取数据官方:http://www.crummv.com/ ...
- Python网络爬虫之三种数据解析方式 (xpath, 正则, bs4)
引入 回顾requests实现数据爬取的流程 指定url 基于requests模块发起请求 获取响应对象中的数据 进行持久化存储 其实,在上述流程中还需要较为重要的一步,就是在持久化存储之前需要进行指 ...
- 爬虫(五)—— 解析库(二)beautiful soup解析库
目录 解析库--beautiful soup 一.BeautifulSoup简介 二.安装模块 三.Beautiful Soup的基本使用 四.Beautiful Soup查找元素 1.查找文本.属性 ...
- BeautifulSoup解析库
解析库 解析器 使用方法 优势 劣势 Python标准库 BeautifulSoup(html, 'html.parser') 速度适中,容错能力强 老版本python容错能力差 lxml HTML解 ...
- Python3爬虫(六) 解析库的使用之Beautiful Soup
Infi-chu: http://www.cnblogs.com/Infi-chu/ Beautiful Soup 借助网页的结构和属性等特性来解析网页,这样就可以省去复杂的正则表达式的编写. Bea ...
- 第三节:Web爬虫之BeautifulSoup解析库
Beautiful Soup官方说明: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索.修改分析树等功能.它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为 ...
- selenuim模块的使用 解析库
selenium: 是自动化测试工具,我们可以用它来进行爬虫. 可以驱动浏览器,执行自定义好的任务. 可以执行js代码 执行速度慢,效率低. 一般用于做登录的认证 基本选择器: find_elemen ...
- python爬虫基础04-网页解析库xpath
更简单高效的HTML数据提取-Xpath 本文地址:https://www.jianshu.com/p/90e4b83575e2 XPath 是一门在 XML 文档中查找信息的语言.XPath 用于在 ...
随机推荐
- winfrom程序文本框第一次选中问题
想实现这样的功能: 就是在panel中的文本框,当第一次点击文本框时,全选文本框的内容:再次选择时,可以全选,也可以部分选中, 可是文本框总是从左全部选中,还不能从右边选择,在Enter或Down事件 ...
- MSSQL转Mysql常用函数,语法等
MSSQL转Mysql常用 一.字段类型 MSSQL Mysql 备注 "nchar" "char()" 最大长度为255 "nvarchar&quo ...
- tpot ufunc 'isnan' not supported for the input types, and the inputs could not be safely coerced to any supported types according to the casting rule ''safe''
机器学习训练的时候报出这个问题 是因为dataframe中的数据类型有一个是‘object’,把它转成int,或float 就行,如下 df['A'] = df['A‘].astype(int) 参考 ...
- 导航菜单点击图片切换--jquery
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- MySQL【数值处理函数】的使用方法
数值处理函数 下边列举一些数学上常用到的函数,在我们的业务中有数学计算时会很有用的: 名称 调用示例 示例结果 描述 ABS ABS(-1) 1 取绝对值 PI PI() 3.131593 返回圆周率 ...
- 杭电ACM1007
Quoit Design Time Limit: 10000/5000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Tot ...
- 释放jQuery 的$ 的使用权
1.释放操作必须在编写其他jquery 代码之前编写,释放之后就不能使用$,改为jQuery . jQuery.noConflict(); 2.也可以自定义访问符号 var nb = jQue ...
- Java 错误提示org.apache.poi.POIXMLException: java.lang.reflect.InvocationTargetException
java 操作excel文件 发布后报错 org.apache.poi.POIXMLException: java.lang.reflect.InvocationTargetException XSS ...
- Unity more efficient find
Unity caches GameObjects based on their tags, so in a big scene with lots of objects, GameObject.Fin ...
- react-native-scrollable-tab-view 中嵌套了react-native-swiper产生的bug
前段时间用RN的时候遇到过这个问题用scrollable-tab-view(scrollableView)这个组件然后嵌套轮播swiper会出现,在scrollableView nitialPage ...