
基于二叉树的高效IP检索格式MMDB
一、MMDB简介
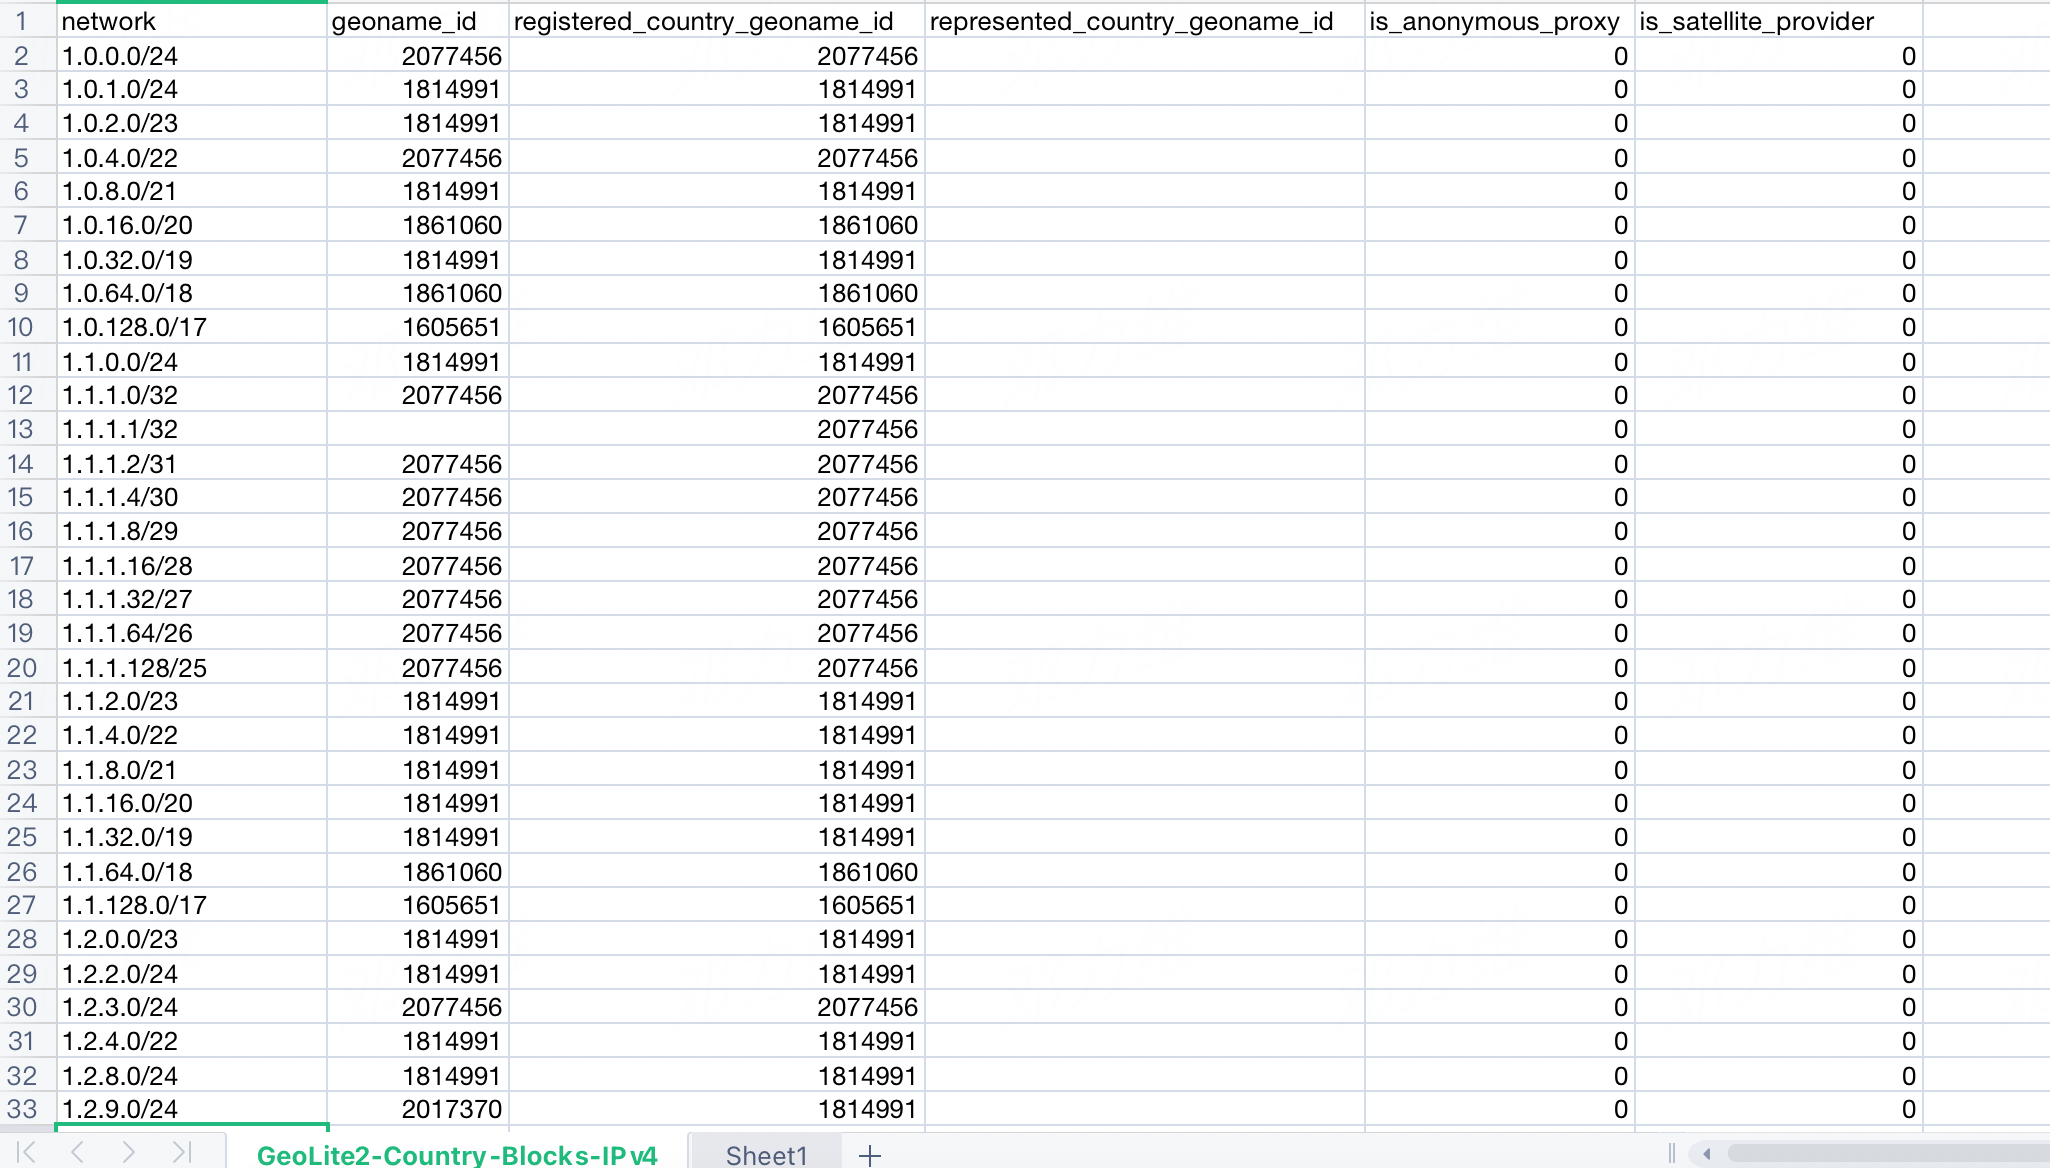
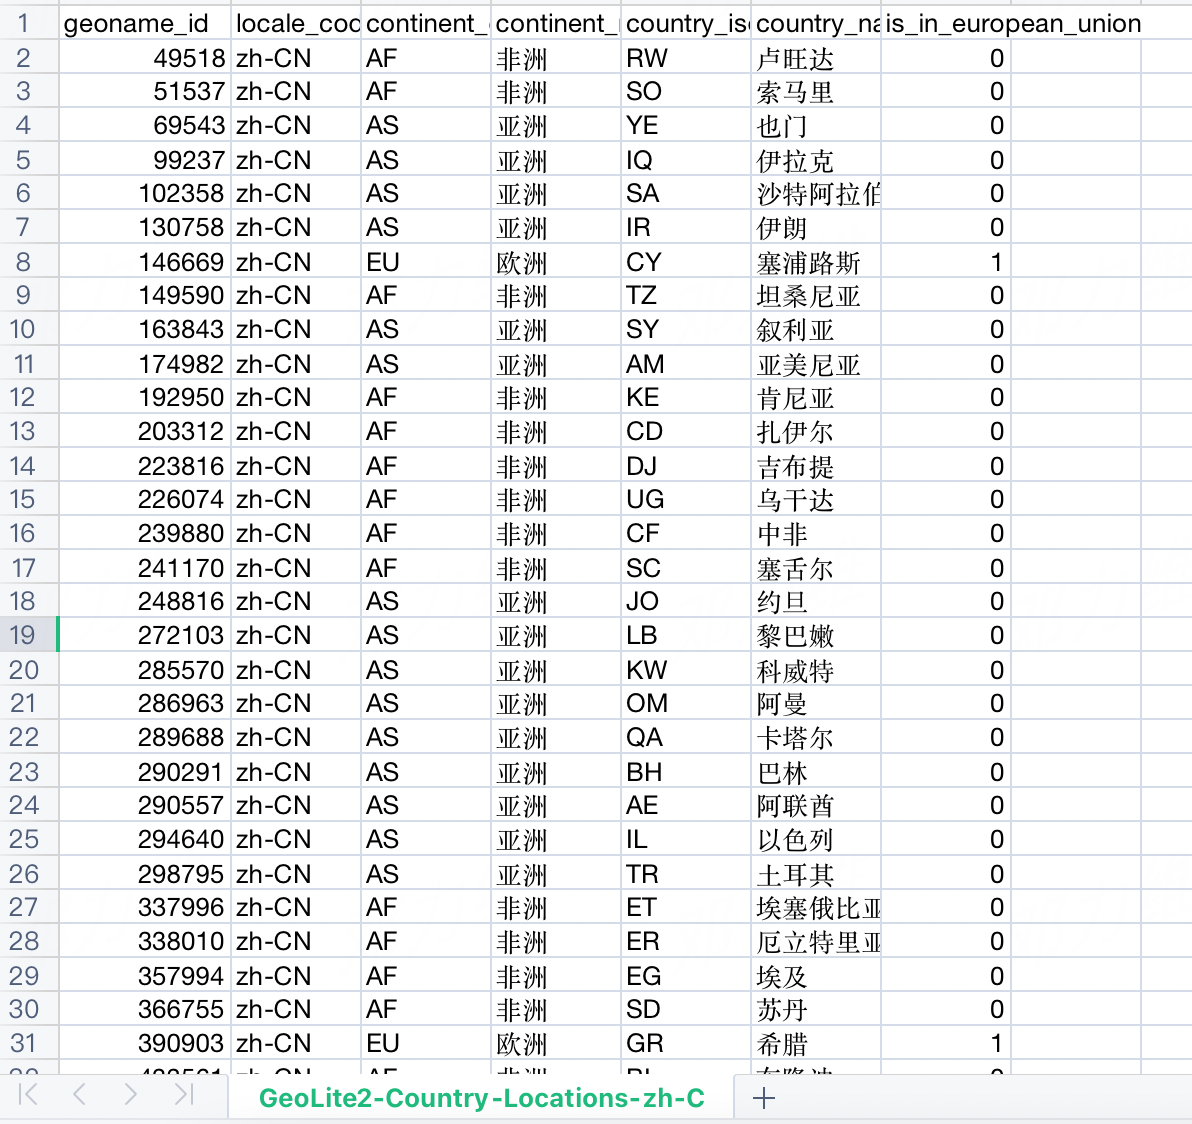
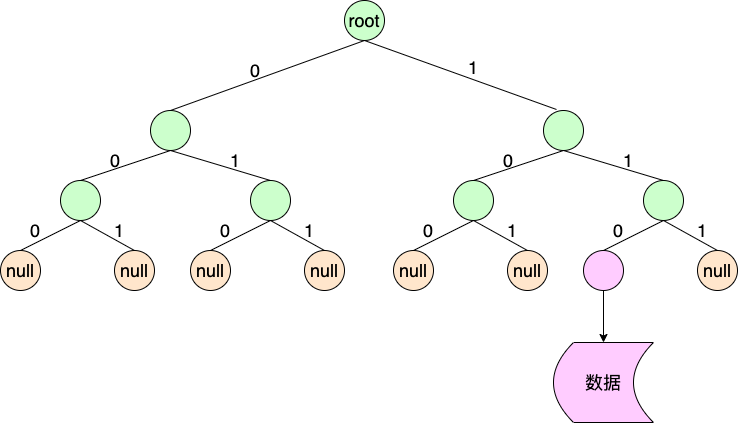
二、构造过程
三、MMDB总体格式

四、节点序列说明
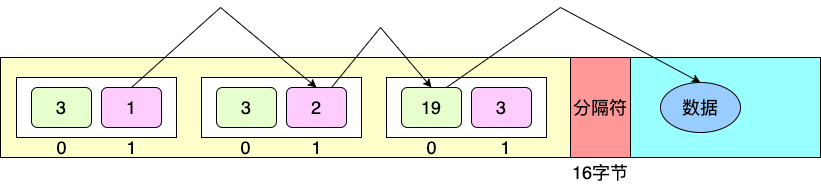
节点序列等于一个节点数组,每个节点由两个记录组成,分别对应二叉树的左孩子和右孩子。
在IP检索中,比特0对应第一个记录,比特1对应第二个记录。
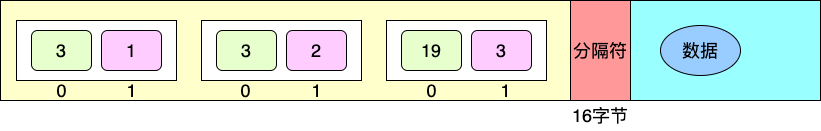
如上图所示,包含3个节点,第一个节点的两个记录为3和1,第二个节点为3和2,第三个节点为19和3。
当记录数等于节点数3时,表示没找到数据。当记录数大于节点数3时,则为数据节点的记录值。
第三个节点记录19表示数据偏移量为0,19-3(节点数)-16。
五、检索算法
在一个总节点数为3的mmdb数据库上,网段“110”的检索过程
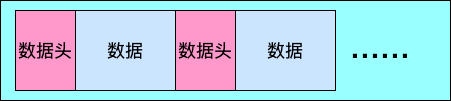
六、数据段说明
七、实验例子
1、构造一个网段为“192.2.10.0/3”,对应二进制网络“110”的节点,数据为{"iso":156,"country_name":"China"},生成的节点序列为:

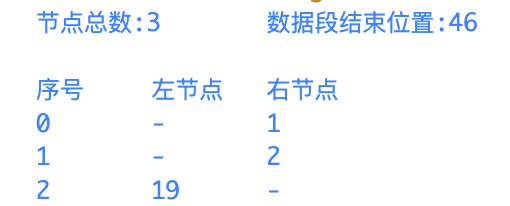
可以看到“110”网段根据二叉树检索算法得到数据段的偏移量19,则数据段偏移量为19-3(节点数)-16=0。
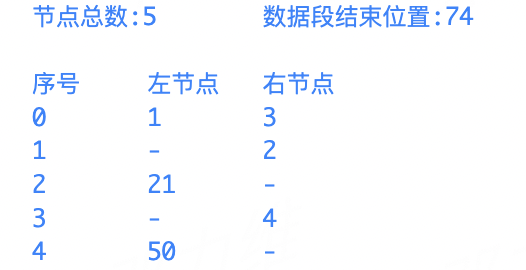
2、再加入一个网段为“64.2.10.0/3”,对应二进制网络“010”的节点,数据为{"iso":826,"country_name":"England"},生成的节点序列为:

八、总结
1、生成过程使用二叉树。
2、存储和检索都是序列化字节数组格式。
3、MMDB是内存数据库 。
参考链接
MaxMind DB File Format Specification
Enriching MMDB files with your own data using go
Building your own MMDB database for fun and profit
基于二叉树的高效IP检索格式MMDB的更多相关文章
- 【转】TCP/IP报文格式
1.IP报文格式 IP协议是TCP/IP协议族中最为核心的协议.它提供不可靠.无连接的服务,也即依赖其他层的协议进行差错控制.在局域网环境,IP协议往往被封装在以太网帧(见本章1.3节)中传送.而所有 ...
- TCP,UDP,IP包头格式及说明(zz)
一.MAC帧头定义 /数据帧定义,头14个字节,尾4个字节/ typedef struct _MAC_FRAME_HEADER { ]; //目的mac地址 ]; //源mac地址 short m_c ...
- [大牛翻译系列]Hadoop(19)MapReduce 文件处理:基于压缩的高效存储(二)
5.2 基于压缩的高效存储(续) (仅包括技术27) 技术27 在MapReduce,Hive和Pig中使用可分块的LZOP 如果一个文本文件即使经过压缩后仍然比HDFS的块的大小要大,就需要考虑选择 ...
- [大牛翻译系列]Hadoop(18)MapReduce 文件处理:基于压缩的高效存储(一)
5.2 基于压缩的高效存储 (仅包括技术25,和技术26) 数据压缩可以减小数据的大小,节约空间,提高数据传输的效率.在处理文件中,压缩很重要.在处理Hadoop的文件时,更是如此.为了让Hadoop ...
- 以太网帧、TCP与UDP段以及IP数据报格式总结
传输层及其以下的机制由内核提供,是操作系统的一部分,应⽤层由⽤户进程提供应⽤层数据通过协议栈发到⽹络上时,每层协议都要加上⼀个数据⾸部(header),称为封装.不同的协议层对数据包有不同的称谓,在传 ...
- 计算机网络(3)-----IP数据报格式
IP数据报(IP Datagram) 格式 解析 (1)版本 占4位,指IP协议的版本.通信双方使用的IP协议版本必须一致.目前广泛使用的IP协议版本号为4(即IPv4). (2)首部长度 占4位,可 ...
- TCP/IP包格式详解
文章参考地址:http://blog.chinaunix.net/uid-20698826-id-4700710.html http://blog.csdn.net/mrwangwang/articl ...
- 一种基于重载的高效c#上图片添加文字图形图片的方法
在做图片监控显示的时候,需要在图片上添加文字,如果用graphics类绘制图片上的字体,实现图像上添加自定义标记,这种方法经验证是可行的,并且在visual c#2005 编程技巧大全上有提到,但是, ...
- 基于二叉树和数组实现限制长度的最优Huffman编码
具体介绍详见上篇博客:基于二叉树和双向链表实现限制长度的最优Huffman编码 基于数组和基于链表的实现方式在效率上有明显区别: 编码256个符号,符号权重为1...256,限制长度为16,循环编码1 ...
- 【转】以太网帧、IP报文格式
原文:https://www.cnblogs.com/yongren1zu/p/6274460.html https://blog.csdn.net/gufachongyang02/article/d ...
随机推荐
- Linux Framebuffer 实验
一.准备 linux虚拟机或ARM开发板 Ubuntu18.04 二.Framebuffer介绍 次笔记主要的目的是实验,所以我不介绍了,有需要的小伙伴可以去看下面博客 Linux LCD Framb ...
- 2018 Web开发人员学习路线图
以下 Web 开发人员学习路线图是来自 Github developer-roadmap 项目,目前已经有繁体版翻译 developer-roadmap-chinese. 主要有三个方向,分别为前端开 ...
- JDK源码分析实战系列-PriorityQueue
完全二叉树 一棵深度为k的有n个结点的二叉树,对树中的结点按从上至下.从左到右的顺序进行编号,如果编号为i(1≤i≤n)的结点与满二叉树中编号为i的结点在二叉树中的位置相同,则这棵二叉树称为完全二叉树 ...
- 正则表达式之前戏、字符组、量词、特殊符号、贪婪与非贪婪匹配等,python正则模块之re
目录 正则表达式前戏 正则表达式之字符组 正则表达式之特殊符号 正则表达式之量词 贪婪匹配与非贪婪匹配 转义符 正则表达式实战建议 re模块 re模块补充说明 作业 正则表达式前戏 案例:京东注册手机 ...
- 【Devexpres】spreadsheetControl自动列宽
Worksheet worksheet = this.spreadsheetControl1.ActiveWorksheet; worksheet.Import(datatable, true, 0, ...
- uboot引导应用程序
uboot默认是支持执行应用程序的,就像引导内核一样,我们也可以自己写一个应用程序,让uboot启动时引导. 在uboot examples/standalone 目录下,有hello_world.c ...
- MySQL库,表,数据的操作
数据库的操作 1. 创建数据库 create database [if not exists] `数据库名` charset=字符编码(utf8mb4); 如果多次创建会报错 如果不指定字符编码,默认 ...
- 《吐血整理》高级系列教程-吃透Fiddler抓包教程(35)-Fiddler如何抓取微信小程序的包-下篇
1.简介 通过前边和宏哥的学习,我们了解到Android 7.0 之后增加了对第三方证书的限制,抓包工具(charles.fiddler等)提供的证书都无法通过校验,也就无法抓取HTTPS请求了,对测 ...
- 【Spark】Day05-内核解析:组件、流程、部署、运行模式、通讯架构、任务调度(Stage、task级)、两种Shuffle机制、内存管理、核心组件
一.内核概述 内核:核心组件的运行机制.任务调度.内存管理.运行原理 1.核心组件 (1)Driver驱动器节点:执行main方法,将程序转化为作业job,在executor中调度任务task,跟踪并 ...
- 2022年Kubernetes CKA 认证真题解析完整版
第一题 RBAC授权问题权重: 4% 设置配置环境:[student@node-1] $ kubectl config use-context k8s Context为部署管道创建一个新的Cluste ...