
MKL库矩阵乘法
此示例是利用Intel 的MKL库函数计算矩阵的乘法,目标为:\(C=\alpha*A*B+\beta*C\),由函数cblas_dgemm实现;
其中\(A\)为\(m\times k\)维矩阵,\(B\)为\(k\times n\)维矩阵,\(C\)为\(m\times n\)维矩阵。
1 cblas_dgemm参数详解
fun cblas_dgemm(Layout,		//指定行优先(CblasRowMajor,C)或列优先(CblasColMajor,Fortran)数据排序

               TransA,		//指定是否转置矩阵A

               TransB,		//指定是否转置矩阵B

               M,			//矩阵A和C的行数

               N,			//矩阵B和C的列数

               K,			//矩阵A的列,B的行

               alpha,		//矩阵A和B乘积的比例因子

               A,			//A矩阵

               lda,			//矩阵A的第一维的大小

               B,			//B矩阵

               ldb,			//矩阵B的第一维的大小

               beta,		//矩阵C的比例因子

               C,			//(input/output) 矩阵C

               ldc			//矩阵C的第一维的大小

               )
cblas_dgemm矩阵乘法默认的算法就是\(C=\alpha*A*B+\beta*C\),若只需矩阵\(A\)与\(B\)的乘积,设置\(\alpha=1,\beta=0\)即可。
2 定义待处理矩阵
#include <stdio.h>

#include <stdlib.h>

#include "mkl.h"		// 调用mkl头文件

#define min(x,y) (((x) < (y)) ? (x) : (y))
double* A, * B, * C;		//声明三个矩阵变量,并分配内存

int m, n, k, i, j;			//声明矩阵的维度,其中

double alpha, beta;

m = 2000, k = 200, n = 1000;

alpha = 1.0; beta = 0.0;

A = (double*)mkl_malloc(m * k * sizeof(double), 64);	//按照矩阵维度分配内存

B = (double*)mkl_malloc(k * n * sizeof(double), 64);	//mkl_malloc用法与malloc相似,64表示64位

C = (double*)mkl_malloc(m * n * sizeof(double), 64);

if (A == NULL || B == NULL || C == NULL) {		//判空

    mkl_free(A);

    mkl_free(B);

    mkl_free(C);

    return 1;

}

for (i = 0; i < (m * k); i++) {		//赋值

    A[i] = (double)(i + 1);

}

for (i = 0; i < (k * n); i++) {

    B[i] = (double)(-i - 1);

}

for (i = 0; i < (m * n); i++) {

    C[i] = 0.0;

}
其中\(A\)和\(B\)矩阵设置为:
A = \left[ {\begin{array}{*{20}{c}}
{1.0}&{2.0}& \cdots &{1000.0}\\
{1001.0}&{1002.0}& \cdots &{2000.0}\\
\vdots & \vdots & \ddots & \cdots \\
{999001.0}&{999002.0}& \cdots &{1000000.0}
\end{array}} \right] \space
B = \left[ {\begin{array}{*{20}{c}}
{-1.0}&{-2.0}& \cdots &{-1000.0}\\
{-1001.0}&{-1002.0}& \cdots &{-2000.0}\\
\vdots & \vdots & \ddots & \cdots \\
{-999001.0}&{-999002.0}& \cdots &{-1000000.0}
\end{array}} \right]
\end{array}
\]
\(C\)矩阵为全0。
3 执行矩阵乘法
回到例子中,对照上面的参数,将C矩阵用A与B的矩阵乘法表示:
cblas_dgemm(CblasRowMajor, CblasNoTrans, CblasNoTrans,

            m, n, k, alpha, A, k, B, n, beta, C, n);

//在执行完成后,释放内存

mkl_free(A);

mkl_free(B);

mkl_free(C);
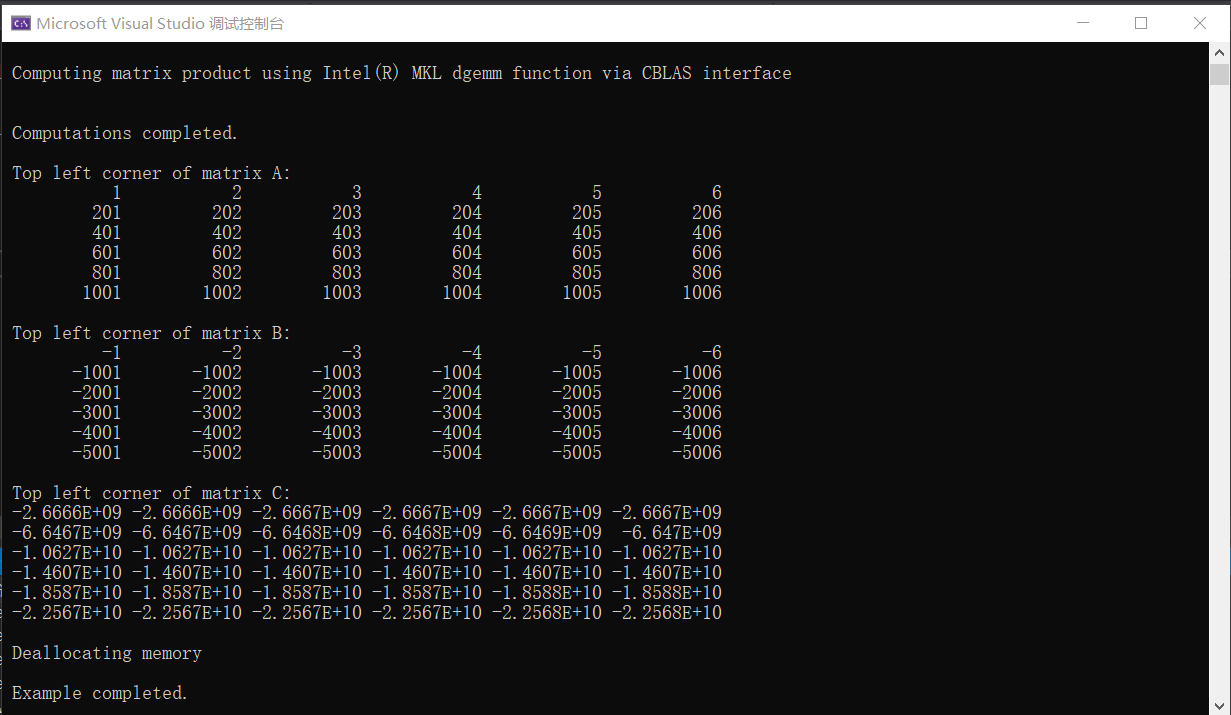
执行后的得到结果如下:
完整代码
#include <stdio.h>

#include <stdlib.h>

#include "mkl.h"

#define min(x,y) (((x) < (y)) ? (x) : (y))

int main()

{

    double* A, * B, * C;

    int m, n, k, i, j;

    double alpha, beta;

    m = 2000, k = 200, n = 1000;

    alpha = 1.0; beta = 0.0;

    A = (double*)mkl_malloc(m * k * sizeof(double), 64);

    B = (double*)mkl_malloc(k * n * sizeof(double), 64);

    C = (double*)mkl_malloc(m * n * sizeof(double), 64);

    if (A == NULL || B == NULL || C == NULL) {

        mkl_free(A);

        mkl_free(B);

        mkl_free(C);

        return 1;

    }

    for (i = 0; i < (m * k); i++) {

        A[i] = (double)(i + 1);

    }

    for (i = 0; i < (k * n); i++) {

        B[i] = (double)(-i - 1);

    }

    for (i = 0; i < (m * n); i++) {

        C[i] = 0.0;

    }

    cblas_dgemm(CblasRowMajor, CblasNoTrans, CblasNoTrans,

        m, n, k, alpha, A, k, B, n, beta, C, n);

    for (i = 0; i < min(m, 6); i++) {

        for (j = 0; j < min(k, 6); j++) {

            printf("%12.0f", A[j + i * k]);

        }

        printf("\n");

    }

    for (i = 0; i < min(k, 6); i++) {

        for (j = 0; j < min(n, 6); j++) {

            printf("%12.0f", B[j + i * n]);

        }

        printf("\n");

    }

    for (i = 0; i < min(m, 6); i++) {

        for (j = 0; j < min(n, 6); j++) {

            printf("%12.5G", C[j + i * n]);

        }

        printf("\n");

    }

    mkl_free(A);

    mkl_free(B);

    mkl_free(C);

    return 0;

}
MKL库矩阵乘法的更多相关文章
- Eigen ,MKL和 matlab 矩阵乘法速度比较
Eigen 矩阵乘法的速度 < MKL矩阵乘法的速度,MKL矩阵乘法的速度与matlab矩阵乘法的速度相差不大,但matlab GPU版本的矩阵乘法速度是CUP的两倍,在采用float数据类型 ...
- [转]OpenBLAS项目与矩阵乘法优化
课程内容 OpenBLAS项目介绍 矩阵乘法优化算法 一步步调优实现 以下为公开课完整视频,共64分钟: 以下为公开课内容的文字及 PPT 整理. 雷锋网的朋友们大家好,我是张先轶,今天主要介绍一下我 ...
- 有关CUBLAS中的矩阵乘法函数
关于cuBLAS库中矩阵乘法相关的函数及其输入输出进行详细讨论. ▶ 涨姿势: ● cuBLAS中能用于运算矩阵乘法的函数有4个,分别是 cublasSgemm(单精度实数).cublasDgemm( ...
- CPU的自动调度矩阵乘法
CPU的自动调度矩阵乘法 这是一个有关如何对CPU使用自动调度程序的文档. 与依靠手动模板定义搜索空间的基于模板的autotvm不同,自动调度程序不需要任何模板.用户只需要编写计算声明,而无需任何调度 ...
- MKL库奇异值分解(LAPACKE_dgesvd)
对任意一个\(m\times n\)的实矩阵,总可以按照SVD算法对其进行分解.即: \[A = U\Sigma V^T \] 其中\(U.V\)分别为\(m\times m.n\times n\)的 ...
- *HDU2254 矩阵乘法
奥运 Time Limit: 1000/1000 MS (Java/Others) Memory Limit: 65536/65536 K (Java/Others)Total Submissi ...
- *HDU 1757 矩阵乘法
A Simple Math Problem Time Limit: 3000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Ot ...
- CH Round #30 摆花[矩阵乘法]
摆花 CH Round #30 - 清明欢乐赛 背景及描述 艺术馆门前将摆出许多花,一共有n个位置排成一排,每个位置可以摆花也可以不摆花.有些花如果摆在相邻的位置(隔着一个空的位置不算相邻),就不好看 ...
- POJ3070 Fibonacci[矩阵乘法]
Fibonacci Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 13677 Accepted: 9697 Descri ...
随机推荐
- Skye无人机刷Betaflight详细图文教程
前言 首先十分感谢B站TASKBL up主的视频教程以及他的耐心指导,视频链接Skye 原机主板刷BetaFlight 参考教程_哔哩哔哩_bilibili.整个改造过程耗时三天,现把改造过程以及遇 ...
- STM32控制永磁同步电机 | FOC电机控制算法概述
1. FOC基本概念 参考:https://www.sohu.com/a/432103720_120929980 FOC(field-oriented control)为磁场导向控制,又称为矢量控制( ...
- FOC实现概述
FOC原理框图如下: 其中涉及到两种坐标转换: 1. Clark变换:常规的三相坐标系→静止的二相坐标系α.β 正变换矩阵 $\left[ {\begin{array}{*{20}{c}}{\sqrt ...
- 🍛 餐厅吃饭版理解 IO 模型:阻塞 / 非阻塞 / IO 复用 / 信号驱动 / 异步
IO 概念 一个基本的 IO,它会涉及到两个系统对象,一个是调用这个 IO 的进程对象,另一个就是系统内核 (kernel).当一个 read 操作发生时,它会经历两个阶段: 通过 read 系统调用 ...
- 现代中央处理器(CPU)是怎样进行分支预测的?
人们一直追求CPU分支预测的准确率,论文Simultaneous Subordinate Microthreading (SSMT)中给了一组数据,如果分支预测的准确率是100%,大多数应用的IPC会 ...
- SpringBoot单元测试携带Cookie
由于我SpringBoot项目,集成了SpringSecurity,而Security框架使用Redis存储Session,所以,这里列出几个关键的类 org.springframework.sess ...
- Django的models中filter的各种用法及官方手册的网址
__exact 精确等于 like 'aaa' __iexact 精确等于 忽略大小写 ilike 'aaa' __contains 包含 like '%aaa%' __icontains 包含 忽略 ...
- JS Promise对象学习
Promise对象的三个状态 pending(进行中) fulfilled(已成功) rejected(已失败) Promise代表一个异步操作,对象的状态一旦改变,就不会再改变 Promise构造函 ...
- promethues常用的函数
prometheus函数常用 时数据 (Instant vector): 包含一组时序,每个时序只有一个点,例如:http_requests_total区间数据 (Range vector): 包含一 ...
- 学习zabbix(六)
实验环境 实验用2到2台机器,实验所用机器系统环境如下,可以看到2台机器的主机名和IP地址 ? 1 2 3 4 5 6 7 8 9 10 [root@linux-node1 ~]# cat /etc/ ...