
ViT简述【Transformer】
Transformer在NLP任务中表现很好,但是在CV任务中应用还很有限,基本都是作为CNN的一个辅助,Vit尝试使用纯Transformer结构解决CV的任务,并成功将其应用到了CV的基本任务--图像分类中。
因此,简单而言,这篇论文的主旨就是,用Transformer结构完成图像分类任务。
结构概述
基本结构如下:
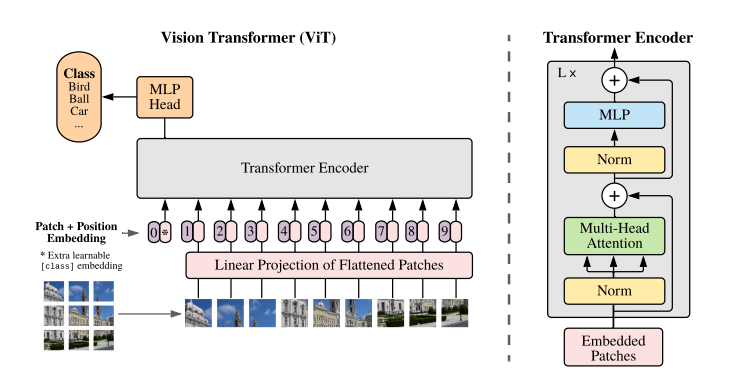
核心要点:
- 图像切patch
- Patch0
- Position Embedding
- Multi-Head Attention
图像切patch
在NLP任务中,将自然语言使用Word2Vec转为向量(Embedding)送入模型进行处理,在CV中没有对应的序列化token,因此作者采用将原始图像切分为多个小块,然后将每个小块儿内的信息展平的方式。
假设输入的shape为:(1, 3, 288, 288)
切分为9个小块,则每个小块的shape为:(1, 3, 32, 32)
然后将每个小块展平,则每个小块为(1, 3072),有9个小块,所以Linear Projection of Flattened Patched的shape为:(1, 9, 3072)输出shape为(1, 9, 1024),再加上Position Embedding,Transformer Encoder的输入shape为(1, 10, 1024),也就是图中Embedded Patches的shape。
Patch0
为什么需要有Patch0?
这是因为需要对1-9个patches信息的整合,最后送入MLP Head的只有Patch0。
Position Embedding
图像被切分和展开后,丢失了位置信息,对于图像处理任务来说,这是很怪异的,因此,作者这里采用在每个Patch上增加一个位置信息的方式,将位置信息纳入考虑。
Multi-Head Attention
参考Attention的基本结构。[Todo, Link]
代码[Pytorch]
import torch

from vit_pytorch import ViT

v = ViT(

    image_size = 256,

    patch_size = 32,

    num_classes = 1000,

    dim = 1024,

    depth = 6,

    heads = 16,

    mlp_dim = 2048,

    dropout = 0.1,

    emb_dropout = 0.1

)

img = torch.randn(1, 3, 256, 256)

preds = v(img)

print(preds.shape) # 1000,与ViT定义的num_classes一致
ViT类参数解析:
- dim:Linear Projection的输出维度:1024
- depth:有多少个Transformer Blocks
- heads:Multi-Head的Head数
- mlp_dim:Transformer Encoder内部的MLP的维度
- dropout
- ......
ViT的forward函数:
def forward(self, img):

    x = self.to_patch_embedding(img)

    b, n, _ = x.shape

    cls_tokens = repeat(self.cls_token, '1 1 d -> b 1 d', b = b)

    x = torch.cat((cls_tokens, x), dim=1)

    x += self.pos_embedding[:, :(n + 1)]

    x = self.dropout(x)

    x = self.transformer(x)

    x = x.mean(dim = 1) if self.pool == 'mean' else x[:, 0]

    x = self.to_latent(x)

    return self.mlp_head(x)
输入端的切分主要由下面这句话完成:
x = self.to_patch_embedding(img)

==>

self.to_patch_embedding = nn.Sequential(

    Rearrange('b c (h p1) (w p2) -> b (h w) (p1 p2 c)', p1 = patch_height, p2 = patch_width),

	nn.LayerNorm(patch_dim),

    nn.Linear(patch_dim, dim),

    nn.LayerNorm(dim),

)

#由传入参数: image_size = 256, patch_size = 32

# Rearrange完成的shape变换为(b, c, 256, 256) -> (b, 64, 1024*c)

# nn.LayerNorm

# nn.Linear: (b, 64, 1024*c) --> (b, 64, 1024)
Rearrange用更加可理解的方式实现transpose的功能:
We don't write:
y = x.transpose(0, 2, 3, 1)
We write comprehensible code:
y = rearrange(x, 'b c h w -> b h w c')
ViT简述【Transformer】的更多相关文章
- VIT Vision Transformer | 先从PyTorch代码了解
文章原创自:微信公众号「机器学习炼丹术」 作者:炼丹兄 联系方式:微信cyx645016617 代码来自github [前言]:看代码的时候,也许会不理解VIT中各种组件的含义,但是这个文章的目的是了 ...
- ICCV2021 | Tokens-to-Token ViT:在ImageNet上从零训练Vision Transformer
前言 本文介绍一种新的tokens-to-token Vision Transformer(T2T-ViT),T2T-ViT将原始ViT的参数数量和MAC减少了一半,同时在ImageNet上从 ...
- Transformer详解
0 简述 Transformer改进了RNN最被人诟病的训练慢的缺点,利用self-attention机制实现快速并行. 并且Transformer可以增加到非常深的深度,充分发掘DNN模型的特性,提 ...
- 从零搭建Pytorch模型教程(三)搭建Transformer网络
前言 本文介绍了Transformer的基本流程,分块的两种实现方式,Position Emebdding的几种实现方式,Encoder的实现方式,最后分类的两种方式,以及最重要的数据格式的介绍. ...
- 论文阅读 | Transformer-XL: Attentive Language Models beyond a Fixed-Length Context
0 简述 Transformer最大的问题:在语言建模时的设置受到固定长度上下文的限制. 本文提出的Transformer-XL,使学习不再仅仅依赖于定长,且不破坏时间的相关性. Transforme ...
- attention、self-attention、transformer和bert模型基本原理简述笔记
attention 以google神经机器翻译(NMT)为例 无attention: encoder-decoder在无attention机制时,由encoder将输入序列转化为最后一层输出state ...
- ICCV2021 | TransFER:使用Transformer学习关系感知的面部表情表征
前言 人脸表情识别(FER)在计算机视觉领域受到越来越多的关注.本文介绍了一篇在人脸表情识别方向上使用Transformer来学习关系感知的ICCV2021论文,论文提出了一个TransFER ...
- ICCV2021 | PnP-DETR:用Transformer进行高效的视觉分析
前言 DETR首创了使用transformer解决视觉任务的方法,它直接将图像特征图转化为目标检测结果.尽管很有效,但由于在某些区域(如背景)上进行冗余计算,输入完整的feature maps ...
- pycaffe︱caffe中fine-tuning模型三重天(函数详解、框架简述)
本文主要参考caffe官方文档[<Fine-tuning a Pretrained Network for Style Recognition>](http://nbviewer.jupy ...
- 带你读Paper丨分析ViT尚存问题和相对应的解决方案
摘要:针对ViT现状,分析ViT尚存问题和相对应的解决方案,和相关论文idea汇总. 本文分享自华为云社区<[ViT]目前Vision Transformer遇到的问题和克服方法的相关论文汇总& ...
随机推荐
- GitHub 开源了多款字体「GitHub 热点速览 v.22.48」
本期 News 快读有 GitHub 官方大动作一下子开源了两款字体,同样大动作的还有 OpenAI 发布的对话模型 ChatGPT,引燃了一波人机对话. 项目这块,也许会成为新的 Web 开发生产力 ...
- Java单例模式的最佳实践?
"读过书,--我便考你一考.茴香豆的茴字,怎样写的?"--鲁迅<孔乙己> 0x00 大纲 目录 0x00 大纲 0x01 前言 0x02 单例的正确性 new关键字 c ...
- Linux 系统用户文件缺失造成“bash-4.2$”错误的解决办法
一.问题出现的原因 造成这个现象的原因是因为用户文件夹下的bash_logout.bash_profile和bashrc这三个隐藏文件缺失 二.问题复现 现在删除这三个文件 此时问题出现了 三.问题解 ...
- GO语言基础 为什么我要学习Golang以及GO语言入门普及
作为网络安全初学者,会遇到采用Go语言开发的恶意样本.因此从今天开始从零讲解Golang编程语言,一方面是督促自己不断前行且学习新知识:另一方面是分享与读者,希望大家一起进步.这系列文章入门部分将参考 ...
- MongoDB 索引类型介绍
转载请注明出处: 目录 1.单字段索引 2.复合索引 3.多key索引 4.其他类型索引 5.索引额外属性 6.MongoDB 索引相关的常用sql命令 MongoDB 支持多种类型的索引,包括单字段 ...
- 【转载】七个人生工具,终生受益 | SWOT、PDCA、6W2H、SMART、WBS、时间管理、二八原则
人类历史原本就是一部追求自身平衡的奋斗史,本文介绍七个人生工具:SWOT.PDCA.6W2H.SMART.WBS.时间管理.二八原则 . 1.SWOT分析法 Strengths:优势 Weakness ...
- WCH网络授时芯片CH9126操作指导
目前CH9126推荐在Win7操作系统的电脑上执行,暂不推荐在与Win10系统的电脑进行通讯. 一.重要引脚说明 设置及状态相关引脚: 引脚1:RSETE-一个控制CH9126工号的引脚,直接接18K ...
- 自研ORM Include拆分查询(递归算法 支持无限层级) 性能优化探讨
最近我在优化 Include 拆分查询,贴出源码供大家交流探讨是否还有优化空间. 测试代码 1 Console.WriteLine($"总记录数:{db.Query<Category& ...
- Html飞机大战(十八): 模块化+项目开源
好家伙,好久好久没有更新这个系列了 为了使文档更方便阅读,使代码更容易维护,来把这个飞机大战模块化 项目已开源: https://gitee.com/tang-and-han-dynasties/ ...
- Mysql--回顾提要
一.写在前 知识学了就忘!不用就忘!我太健忘!特此记录!用于复习打卡!Mysql干就完事了! 二.来辣! MyISAM表把自增主键最大id记录到文件,重启也不会丢.InnoDB记录到内存,重启数据库和 ...