
Python爬取网页上想要的数据
1、源代码如下
from urllib.request import urlopen,Request

import urllib.request

import re

from bs4 import BeautifulSoup

from distutils.filelist import findall

url ='http://movie.douban.com/top250?format=text'

headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/100.0.4896.60 Safari/537.36'}

ret = Request(url,headers=headers)

page = urllib.request.urlopen(ret)

contents = page.read()

# print(contents)

soup = BeautifulSoup(contents, "html.parser")

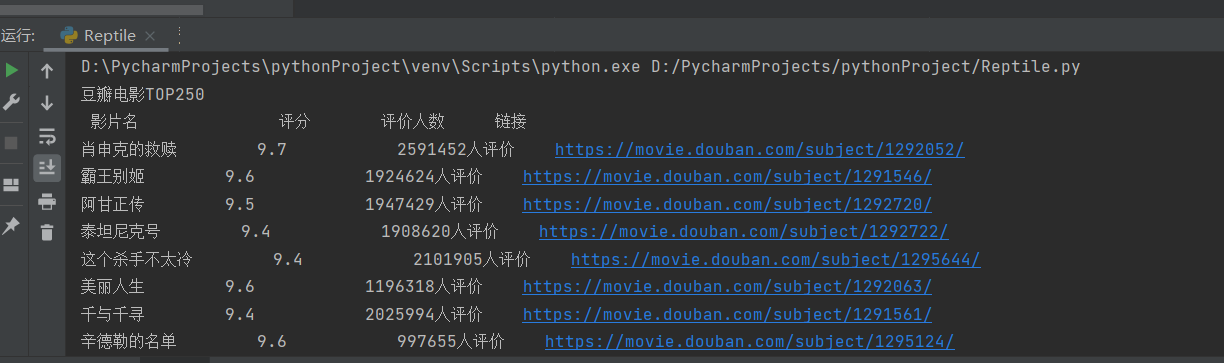
print("豆瓣电影TOP250" + "\n" + " 影片名              评分       评价人数     链接 ")

for tag in soup.find_all('div', class_='info'):

    # print tag

    m_name = tag.find('span', class_='title').get_text()

    m_rating_score = float(tag.find('span', class_='rating_num').get_text())

    m_people = tag.find('div', class_="star")

    m_span = m_people.findAll('span')

    m_peoplecount = m_span[3].contents[0]

    m_url = tag.find('a').get('href')

    print(m_name + "        " + str(m_rating_score) + "           " + m_peoplecount + "    " + m_url)
2、安装bs4
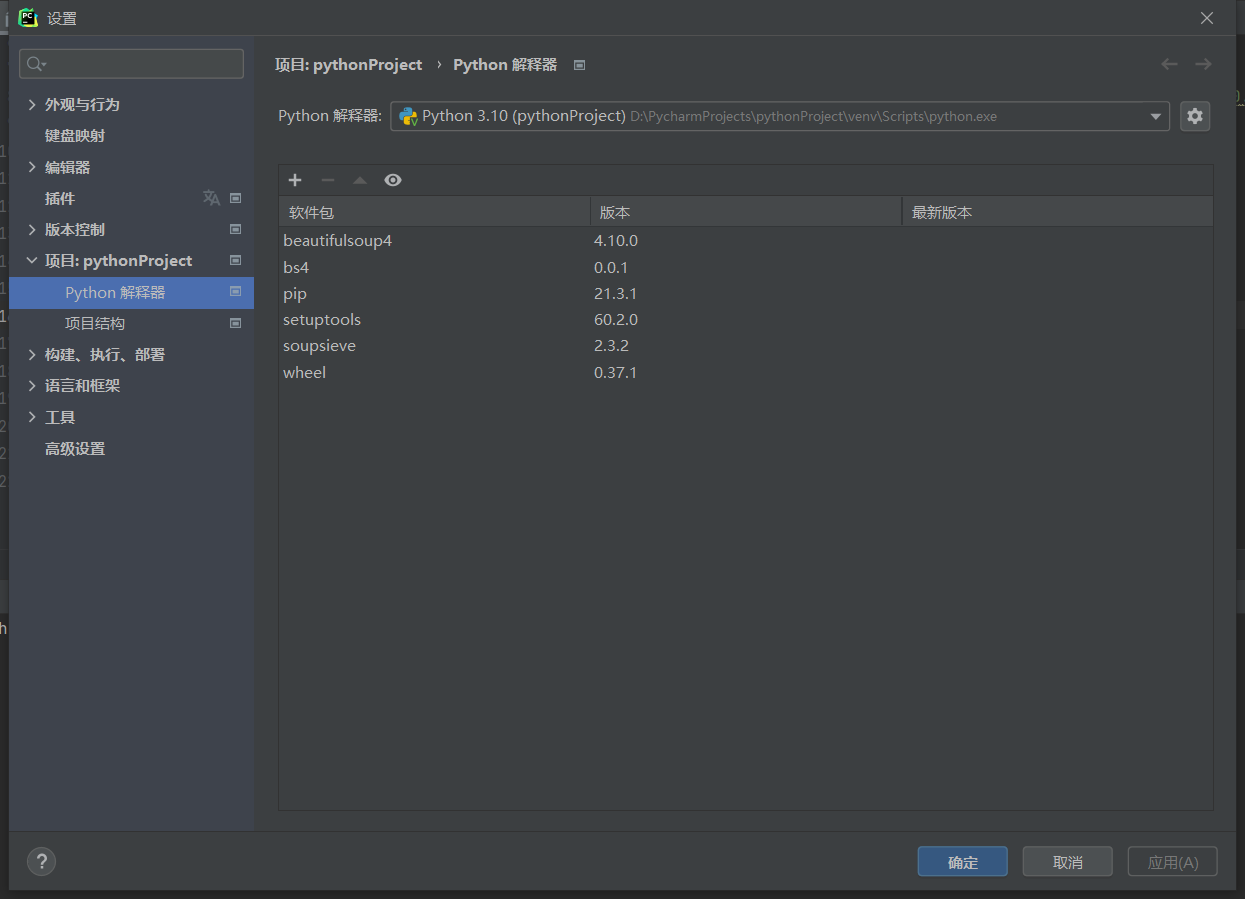
在文件-设置-python Project-搜索ps4并点击安装,安装完成以后会提示安装成功
3、URLLIB.ERROR.HTTPERROR: HTTP ERROR 418错误
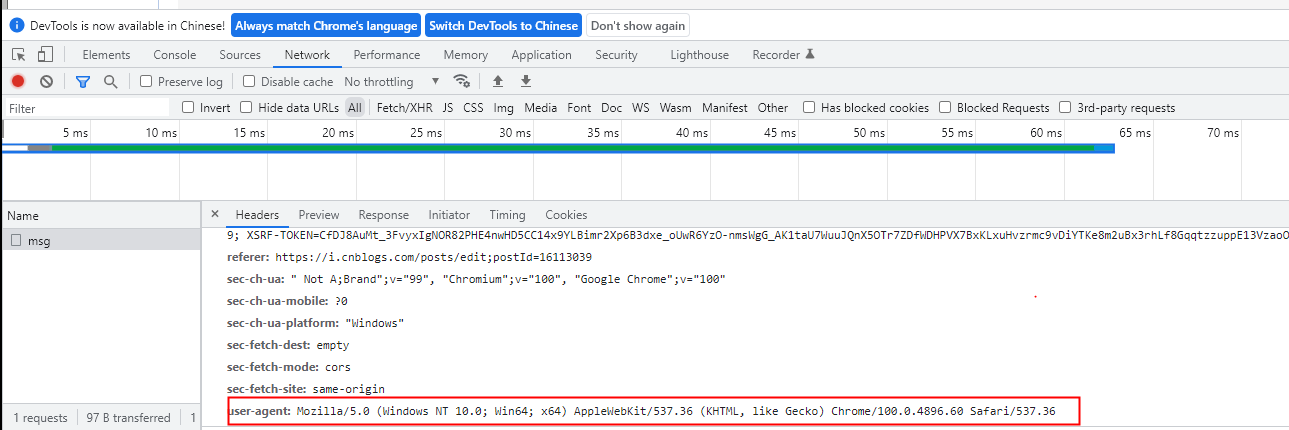
需要模拟浏览器访问,直接爬取会被拦截。打开浏览器按F12,随便访问一个网站,选中连接,找Headers,往下拉找到其中user-agent代表用的哪个请求的浏览器。
Python爬取网页上想要的数据的更多相关文章
- 使用python爬取MedSci上的期刊信息
使用python爬取medsci上的期刊信息,通过设定条件,然后获取相应的期刊的的影响因子排名,期刊名称,英文全称和影响因子.主要过程如下: 首先,通过分析网站http://www.medsci.cn ...
- 如何使用python爬取网页动态数据
我们在使用python爬取网页数据的时候,会遇到页面的数据是通过js脚本动态加载的情况,这时候我们就得模拟接口请求信息,根据接口返回结果来获取我们想要的数据. 以某电影网站为例:我们要获取到电影名称以 ...
- python爬取网页的通用代码框架
python爬取网页的通用代码框架: def getHTMLText(url):#参数code缺省值为‘utf-8’(编码方式) try: r=requests.get(url,timeout=30) ...
- Python爬取网页信息
Python爬取网页信息的步骤 以爬取英文名字网站(https://nameberry.com/)中每个名字的评论内容,包括英文名,用户名,评论的时间和评论的内容为例. 1.确认网址 在浏览器中输入初 ...
- steam夏日促销悄然开始,用Python爬取排行榜上的游戏打折信息
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 不知不觉,一年一度如火如荼的steam夏日促销悄然开始了.每年通过大大小小 ...
- 【Python爬虫案例】用Python爬取李子柒B站视频数据
一.视频数据结果 今天是2021.12.7号,前几天用python爬取了李子柒的油管评论并做了数据分析,可移步至: https://www.cnblogs.com/mashukui/p/1622025 ...
- Python爬取网站上面的数据很简单,但是如何爬取APP上面的数据呢
- 利用Python爬取网页图片
最近几天,研究了一下一直很好奇的爬虫算法.这里写一下最近几天的点点心得.下面进入正文: 你可能需要的工作环境: Python 3.6官网下载 我们这里以sogou作为爬取的对象. 首先我们进入搜狗图片 ...
- 使用 Python 爬取网页数据
1. 使用 urllib.request 获取网页 urllib 是 Python 內建的 HTTP 库, 使用 urllib 可以只需要很简单的步骤就能高效采集数据; 配合 Beautiful 等 ...
- python爬取网页图片(二)
从一个网页爬取图片已经解决,现在想要把这个用户发的图片全部爬取. 首先:先找到这个用户的发帖页面: http://www.acfun.cn/u/1094623.aspx#page=1 然后从这个页面中 ...
随机推荐
- 借助Radamsa变异数据(初探)
Radamsa 介绍 Radamsa是一款测试用例生成器,通常用来测试程序对格式错误和潜在恶意输入的承受能力(对程序进行模糊测试).它通过你的输入来返回变异后的数据.它的主要卖点是,它已经在真正重要的 ...
- 顶层QWidget弹窗设置背景为透明,透明部分为黑色。
setAttribute(Qt::WA_TranslucentBackground); 设置此属性,解决.
- Java堆外缓存(一个很有意思的应用)
我们在开发过程中会遇到这样的场景:就是一个服务的各项 JVM 的配置都比较合理的情况下,它的 GC 情况还是不容乐观.分析之后发现有 2 个对象特别巨大,占了总存活堆内存的 90%以上.其中第 1 大 ...
- MySQL的简单安装配置
一.简单了解MySQL 1.在了解MySQL之前因该了解的东西 数据库(Database)指长期存储在计算机内的.有组织的.可共享的数据集合.数据库实际上就是一个文件集合,是一个存储数据的仓库,本质就 ...
- springBoot集成flowable
前言 Flowable可以十分灵活地加入你的应用/服务/构架.可以将JAR形式发布的Flowable库加入应用或服务,来嵌入引擎. 以JAR形式发布使Flowable可以轻易加入任何Java环境:Ja ...
- IIS服务器SSL证书安装 (pfx文件不能直接运行时)
在证书控制台下载IIS版本证书,下载到本地的是一个压缩文件,解压后里面包含.pfx文件是证书文件,pfx_password.txt是证书文件的密码. 友情提示: 每次下载都会产生新密码,该密码仅匹配本 ...
- xshell连接时显示“服务器发送了一个意外的数据包。received:3,expected:20“问题的解决方法
xshell连接时显示"服务器发送了一个意外的数据包.received:3,expected:20"问题的解决方法 解决方法:在/etc/ssh/sshd_config最后增加以下 ...
- [NOIP2018 提高组] 保卫王国
题解 两只 \(\log\) 的动态 \(dp\) ! 相比标算倍增 动态 \(dp\) 既实用又好理解 \(Code\) #include<cstdio> #include<ios ...
- xampp修改mysql数据库密码(测试成功)
转载: http://www.360doc.com/content/17/0608/14/8797027_661063783.shtml ------------------------------- ...
- 通过手动创建hibernate工厂,自动生成表,完成数据库备份还原功能
最近做toB.toG业务,普遍要去适配各种国产数据库,所以不得不用hibernate,过去这么多年一直都是用mybatis+mysql,现在重拾hibernate,专注跨数据库,感兴趣的加关注. 需求 ...