
AdaBoost:自适应提升算法的原理及其实现
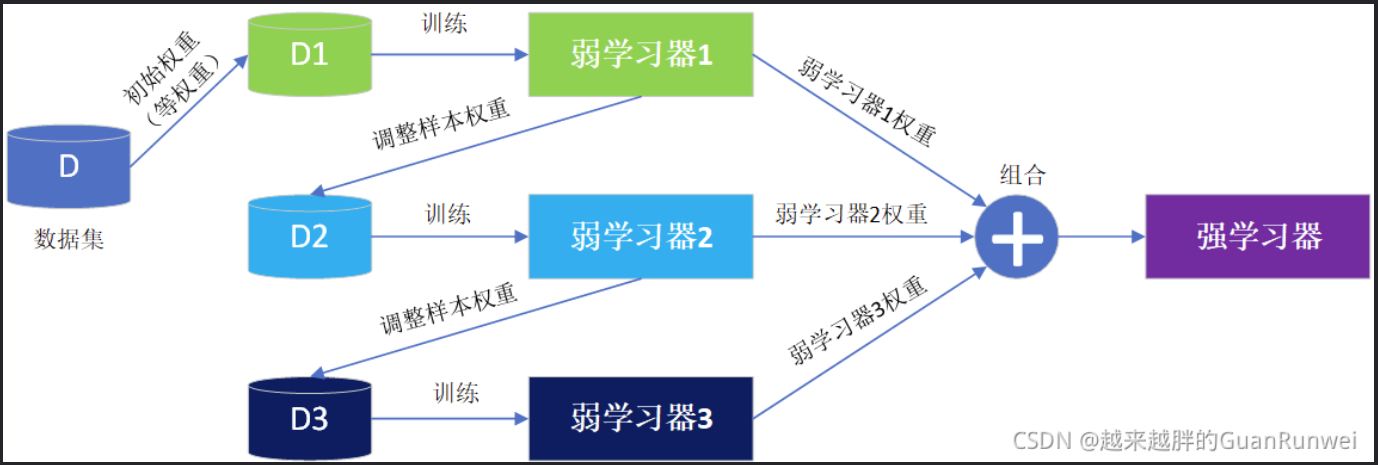
具体过程:
- 对原始数据集初始化权重
- 用带权值数据集训练弱学习器
- 根据弱学习器的误差计算弱学习器的权重
- 调整数据集的权重
- 重复第2-4步K-1次
- 将K-1个弱学习器的结果进行加权组合
对于AdaBoost的数学说明,请见Adaboost算法讲解 - 知乎 (zhihu.com)
代码实现:
首先导入需要的库
import numpy as np

import pandas as pd

import matplotlib.pyplot as plt
然后来制造一些假数据:
# 生成数据并查看

from sklearn.model_selection import train_test_split

from sklearn.datasets import make_blobs  # 导入sklearn模拟二分类数据生成模块

X, y =  make_blobs(n_samples=150, n_features=2, centers=2, cluster_std=1.2, random_state=40) # 生成模拟二分类数据集

# 将标签转换为1/-1

y_ = y.copy()

y_[y_==0] = -1

y_ = y_.astype(float)

X_train, X_test, y_train, y_test = train_test_split(X, y_, test_size=0.3, random_state=43) # 训练/测试数据集划分

colors = {0:'r', 1:'g'} # 设置颜色参数

plt.scatter(X[:,0], X[:,1], marker='o', c=pd.Series(y).map(colors)) # 绘制二分类数据集的散点图

plt.show();
创建一个决策弱分类器的函数:
class DecisionStump():

    def __init__(self):

        # 基于划分阈值决定样本分类为1还是-1

        self.label = 1

        # 特征索引

        self.feature_index = None

        # 特征划分阈值

        self.threshold = None

        # 指示分类准确率的值

        self.alpha = None
定义整体model:
### 定义AdaBoost算法类

class Adaboost:

    # 弱分类器个数

    def __init__(self, n_estimators=5):

        self.n_estimators = n_estimators

    # Adaboost拟合算法

    def fit(self, X, y):

        m, n = X.shape

        # (1) 初始化权重分布为均匀分布 1/N

        w = np.full(m, (1/m))

        # 处初始化基分类器列表

        self.estimators = []

        for _ in range(self.n_estimators):

            # (2.a) 训练一个弱分类器:决策树桩

            estimator = DecisionStump()

            # 设定一个最小化误差

            min_error = float('inf')

            # 遍历数据集特征,根据最小分类误差率选择最优划分特征

            for i in range(n):

                # 获取特征值

                values = np.expand_dims(X[:, i], axis=1)

                # 特征取值去重

                unique_values = np.unique(values)

                # 尝试将每一个特征值作为分类阈值

                for threshold in unique_values:

                    p = 1

                    # 初始化所有预测值为1

                    pred = np.ones(np.shape(y))

                    # 小于分类阈值的预测值为-1

                    pred[X[:, i] < threshold] = -1

                    # 2.b 计算误差率

                    error = sum(w[y != pred])

                    # 如果分类误差大于0.5,则进行正负预测翻转

                    # 例如 error = 0.6 => (1 - error) = 0.4

                    if error > 0.5:

                        error = 1 - error

                        p = -1

                    # 一旦获得最小误差则保存相关参数配置

                    if error < min_error:

                        estimator.label = p

                        estimator.threshold = threshold

                        estimator.feature_index = i

                        min_error = error

            # 2.c 计算基分类器的权重

            estimator.alpha = 0.5 * np.log((1.0 - min_error) / (min_error + 1e-9))

            # 初始化所有预测值为1

            preds = np.ones(np.shape(y))

            # 获取所有小于阈值的负类索引

            negative_idx = (estimator.label * X[:, estimator.feature_index] < estimator.label * estimator.threshold)

            # 将负类设为 '-1'

            preds[negative_idx] = -1

            # 2.d 更新样本权重

            w *= np.exp(-estimator.alpha * y * preds)

            w /= np.sum(w)

            # 保存该弱分类器

            self.estimators.append(estimator)

    # 定义预测函数

    def predict(self, X):

        m = len(X)

        y_pred = np.zeros((m, 1))

        # 计算每个弱分类器的预测值

        for estimator in self.estimators:

            # 初始化所有预测值为1

            predictions = np.ones(np.shape(y_pred))

            # 获取所有小于阈值的负类索引

            negative_idx = (estimator.label * X[:, estimator.feature_index] < estimator.label * estimator.threshold)

            # 将负类设为 '-1'

            predictions[negative_idx] = -1

            # 2.e 对每个弱分类器的预测结果进行加权

            y_pred += estimator.alpha * predictions

        # 返回最终预测结果

        y_pred = np.sign(y_pred).flatten()

        return y_pred
最后,让我们借助sklearn中的准确率函数来测试一下:
##### 计算准确率

from sklearn.metrics import accuracy_score # 导入sklearn准确率计算函数

clf = Adaboost(n_estimators=5) # 创建Adaboost模型实例

clf.fit(X_train, y_train) # 模型拟合

y_pred = clf.predict(X_test) # 模型预测

accuracy = accuracy_score(y_test, y_pred) # 计算模型预测准确率

print("Accuracy of AdaBoost by numpy:", accuracy)
AdaBoost:自适应提升算法的原理及其实现的更多相关文章
- 【机器学习算法】AdaBoost自适应提升算法
前言 AdaBoost的算法步骤比较容易理解,可以参考李航老师的<统计学习方法>和July的blog. 对博主而言,最主要的是迭代部分的第二步骤是如何如何确定阈值呢,也就是说有一个特征就有 ...
- Adaboost提升算法从原理到实践
1.基本思想: 综合某些专家的判断,往往要比一个专家单独的判断要好.在"强可学习"和"弱科学习"的概念上来说就是我们通过对多个弱可学习的算法进行"组合 ...
- [机器学习]-Adaboost提升算法从原理到实践
1.基本思想: 综合某些专家的判断,往往要比一个专家单独的判断要好.在”强可学习”和”弱可学习”的概念上来说就是我们通过对多个弱可学习的算法进行”组合提升或者说是强化”得到一个性能赶超强可学习算法的算 ...
- 机器学习之Adaboost (自适应增强)算法
注:本篇博文是根据其他优秀博文编写的,我只是对其改变了知识的排序,另外代码是<机器学习实战>中的.转载请标明出处及参考资料. 1 Adaboost 算法实现过程 1.1 什么是 Adabo ...
- Adaboost 算法的原理与推导——转载及修改完善
<Adaboost算法的原理与推导>一文为他人所写,原文链接: http://blog.csdn.net/v_july_v/article/details/40718799 另外此文大部分 ...
- [转]Adaboost 算法的原理与推导
看了很多篇解释关于Adaboost的博文,觉得这篇写得很好,因此转载来自己的博客中,以便学习和查阅. 原文地址:<Adaboost 算法的原理与推导>,主要内容可分为三块,Adaboost ...
- 机器学习第5周--炼数成金-----决策树,组合提升算法,bagging和adaboost,随机森林。
决策树decision tree 什么是决策树输入:学习集输出:分类觃则(决策树) 决策树算法概述 70年代后期至80年代初期,Quinlan开发了ID3算法(迭代的二分器)Quinlan改迚了ID3 ...
- 梯度提升树(GBDT)原理小结(转载)
在集成学习值Adaboost算法原理和代码小结(转载)中,我们对Boosting家族的Adaboost算法做了总结,本文就对Boosting家族中另一个重要的算法梯度提升树(Gradient Boos ...
- Atitit 贝叶斯算法的原理以及垃圾邮件分类的原理
Atitit 贝叶斯算法的原理以及垃圾邮件分类的原理 1.1. 最开始的垃圾邮件判断方法,使用contain包含判断,只能一个关键词,而且100%概率判断1 1.2. 元件部件串联定律1 1.3. 垃 ...
随机推荐
- Vxe-table 高亮当前行
需求 1 :设置初始高亮 子组件: 父组件 需求 2 :高亮行的变化,需要把数据传递到兄弟组件中 解决办法:EventBus 参考链接: http://t.csdn.cn/iwOJc main.js ...
- Vue 路由的一些复杂配置
1 # 一.路由的props参数 2 export default new VueRouter({ 3 routes:[ 4 { 5 name:'guanyu', // 命名路由 6 path:'/a ...
- 小白之Python基础(一)
一.数字类型: 1.整形 十进制:默认为十进制:(如:99,100.......) 十六进制: 0x,0X开头的表示16进制数 二进制:0b,0B开头的表示2进制数 八进制: 0o,0O开头的表示8进 ...
- Jenkins使用pipeline部署服务到远程服务器
写这篇文章是对之前搭建Jenkins做的修改和完善,让jenkins更好的为我们服务 Docker搭建Jenkins服务 使用过程中遇到的问题: 为方便部署,打算将jenkins用到的jdk11.ma ...
- 让 DolphinScheduler 1.3.4 开启 Netty 日志打印,解决流程实例一直在运行中的问题
关于新一代大数据任务调度 - Apache DolphinScheduler Apache DolphinScheduler(incubator) 于 17 年在易观数科立项, 19 年 8 月进 ...
- 人非圣贤孰能无过,Go lang1.18入门精炼教程,由白丁入鸿儒,Go lang错误处理机制EP11
人非圣贤,孰能无过,有则改之,无则加勉.在编程语言层面,错误处理方式大体上有两大流派,分别是以Python为代表的异常捕获机制(try....catch):以及以Go lang为代表的错误返回机制(r ...
- as 和 which 引导非限制性定语从句的区别
定语从句关系代词作用表格:as 和 which 都可以指代整个句子.as 引导非限制性定语从句可以放在主句之前.主句之后.主句之中:which 引导非限制性定语从句只能放在先行词之后. (一)As i ...
- 给博客添加个充电按钮(仿B站)
今天我准备吧B站的充电按钮移植到本博客,开始- 上代码: HTML <html> <head> <link href="./space.8.f69f7d6f8f ...
- vivo前端智能化实践:机器学习在自动网页布局中的应用
作者:vivo 互联网前端团队- Su Ning 在设计稿转网页中运用基于self-attention机制设计的机器学习模型进行设计稿的布局,能够结合dom节点的上下文得出合理的方案. 一.背景 切图 ...
- OpenJudge 1.5.39 与7无关的数
39:与7无关的数 总时间限制: 1000ms 内存限制: 65536kB 描述 一个正整数,如果它能被7整除,或者它的十进制表示法中某一位上的数字为7,则称其为与7相关的数.现求所有小于等于n(n ...