
转载:大模型所需 GPU 内存笔记
转载文章:大模型所需 GPU 内存笔记
引言
在运行大型模型时,不仅需要考虑计算能力,还需要关注所用内存和 GPU 的适配情况。这不仅影响 GPU 推理大型模型的能力,还决定了在训练集群中总可用的 GPU 内存,从而影响能够训练的模型规模。
大模型推理的内存计算只需考虑模型权重即可。
大模型训练的内存计算往往会考虑包括模型权重、反向传播的梯度、优化器所用的内存、正向传播的激活状态内存。
接下来以ChatGLM-6B为例,它的参数设置为隐藏层神经元数量(hidden_size)为 4096,层数(num_layers)为 28,token 长度为 2048,注意力头数(attention heads)为 32,讲解怎么计算推理内存和训练内存。
推理内存
模型权重
- 对 int8 而言,模型内存 =1 * 参数量 (字节)
- 对 fp16 和 bf16 而言,模型内存=2 * 参数量(字节)
- 对 fp32 而言,模型内存= 4 * 参数量(字节)
因为 1 GB(\(1024^3\)字节) ≈ 1B字节(???),也正好和1B参数量的数据量级一致,估算时就比较简单了。
例如,对于一个ChatGLM-6B而言,就是:
- 对 int8 而言,模型内存=1 * 6GB=6GB
- 对 fp16 和 bf16 而言,模型内存=2 * 6GB=12GB
- 对 fp32 而言,模型内存=4 * 6GB=24GB
推理总内存
除了用于存储模型权重的内存外,在实际的前向传播过程中还会产生一些额外的开销。根据经验,这些额外开销通常控制在总内存的20%以内(只有80%的有效利用率)
因此,推理总内存≈1.2×模型内存。
训练
模型权重
可以使用纯 fp32 或纯 fp16 训练模型:
- 纯 fp32,模型内存=4 * 参数量(字节)
- 纯 fp16,模型内存=2 * 参数量(字节)
除了常规推理中讨论的模型权重数据类型,训练阶段还涉及混合精度训练。
混合精度 $\approx $ 纯fp16
- 混合精度 (fp16/bf16 + fp32), 模型内存=2 * 参数量(字节)
例如,对于一个ChatGLM-6B而言,就是:
- 纯 fp32,模型内存=4 * 6GB=24GB
- 纯 fp16,模型内存=2 * 6GB=12GB
- 混合精度 (fp16/bf16 + fp32), 模型内存=2 * 6GB=12GB
优化器状态
- 对于纯 AdamW,优化器内存=12 * 参数量(字节)
- 对于像 bitsandbytes 这样的 8 位优化器,优化器内存=6 * 参数量(字节)
- 对于含动量的类 SGD 优化器,优化器内存=8 * 参数量(字节)
例如,对于一个ChatGLM-6B而言,就是:
- 对于纯 AdamW,优化器内存=12 * 6GB=72GB
- 对于像 bitsandbytes 这样的 8 位优化器,优化器内存=6 * 6GB=36GB
- 对于含动量的类 SGD 优化器,优化器内存=8 * 48GB=36GB
梯度
梯度可以存储为 fp32 或 fp16 (梯度数据类型通常与模型数据类型匹配。因此在 fp16 混合精度训练中,梯度数据类型为 fp16)
- 对于 fp32,梯度内存=4 * 参数量(字节)
- 对于 fp16,梯度内存=2 * 参数量(字节)
例如,对于一个ChatGLM-6B而言,就是:
- 对于 fp32,梯度内存=4 * 6GB=24GB
- 对于 fp16,梯度内存=2 * 6GB=12GB
激活状态
在进行LLM(大语言模型)训练时,现代GPU通常会遇到内存问题,而不是算力问题。因此,激活重计算(也称为激活检查点)变得非常流行,它是一种以计算力为代价来减少内存使用的方法。激活重计算/检查点的主要思路是重新计算某些层的激活,而不将它们存储在GPU内存中,从而降低内存使用量。具体来说,减少内存的多少取决于我们选择重新计算哪些层的激活。
接下来,假设激活数据类型为 fp16,没有使用序列并行
- 无重计算的激活内存=token 长度 * batch size * hidden layer 的神经元数量 * 层数(10+24/t+5 * a * token 长度/hidden layer 的神经元数 * t) 字节
- 选择性重计算的激活内存=token 长度 * batch size * hidden layer 的神经元数量 * 层数(10+24/t) 字节
- 全部重计算的激活内存=2 * token 长度 * batch size * hidden layer 的神经元数量 * 层数 字节
其中:
- a :transformer 模型中注意力头 (attention heads) 的个数
- t :张量并行度 (如果无张量并行,则为 1)
对于一个ChatGLM-6B而言,就是:
- token 长度 * batch size * hidden layer 的神经元数量 * 层数 = 2048 * 1 * 4096 * 28 ≈ 0.23GB
- 无重计算的激活内存 = 0.23GB * (10+24/1+5 * 32 * 2048/4096 * 1) = 0.23 * 114 = 26.22G
- 选择性重计算的激活内存 = 0.23GB * (10+24/1) = 7.8G
- 全部重计算的激活内存 = 2 * 0.23GB = 0.46GB
由于重计算的引入也会引起计算成本的增加,具体增加多少取决于选择了多少层进行重计算,但其上界为所有层都额外多了一次前向传播,因此,更新后的前向传播计算成本如下:
2 * token数 * 模型参数 ≤ C(前向传播)≤ 4 * token数 * 模型参数
总结
因为训练大模型时通常会采用AdamW优化器,并用混合精度训练来加速训练,所以训练一个ChatGLM-6B所需的训练总内存为:
训练总内存=模型内存+优化器内存+激活内存+梯度内存 = 12GB + 72GB + 12Gb + 7.8GB = 103GB
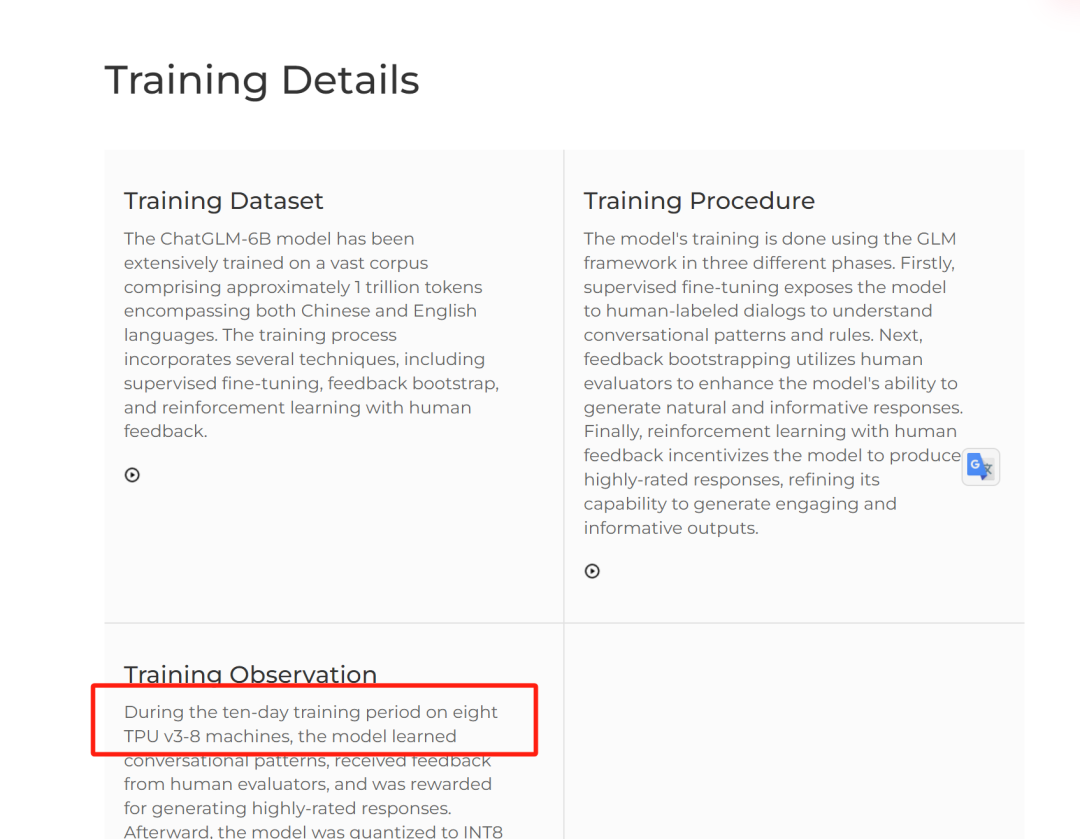
将以上内容总结为一个简单的类比(非常粗糙的类比):TPUv3-8机器,对标八卡V100-16GB版本的机器;TPUv4-8机器,对标四卡A100-40GB版本的机器。
ChatGLM-6B使用了八台TPU v3-8 机器训练,共使用内存为 128 GB,和我们计算的基本一致。
推理总内存 ≈1.2×模型内存 = 1.2 * 12 GB = 14.4GB
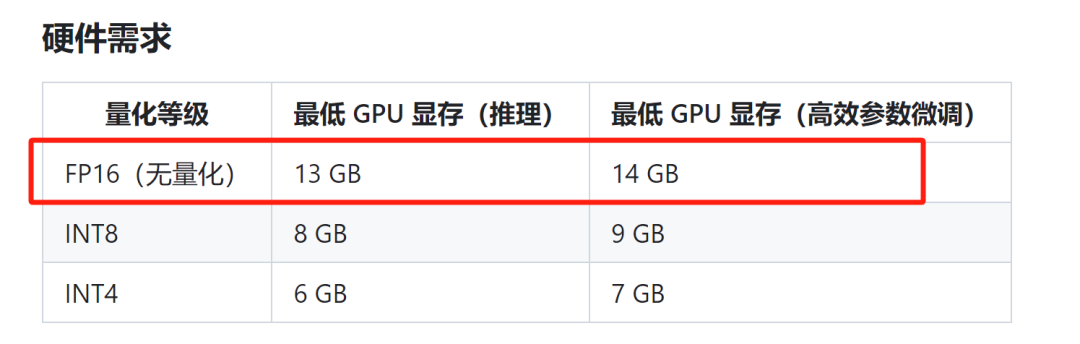
推理总内存的值基本上和ChatGLM-6B官方文档一致。
转载:大模型所需 GPU 内存笔记的更多相关文章
- (转载)CNN 模型所需的计算力(FLOPs)和参数(parameters)数量计算
FLOPS:注意全大写,是floating point operations per second的缩写,意指每秒浮点运算次数,理解为计算速度.是一个衡量硬件性能的指标. FLOPs:注意s小写,是f ...
- PowerDesigner 15学习笔记:十大模型及五大分类
个人认为PowerDesigner 最大的特点和优势就是1)提供了一整套的解决方案,面向了不同的人员提供不同的模型工具,比如有针对企业架构师的模型,有针对需求分析师的模型,有针对系统分析师和软件架构师 ...
- 华为高级研究员谢凌曦:下一代AI将走向何方?盘古大模型探路之旅
摘要:为了更深入理解千亿参数的盘古大模型,华为云社区采访到了华为云EI盘古团队高级研究员谢凌曦.谢博士以非常通俗的方式为我们娓娓道来了盘古大模型研发的"前世今生",以及它背后的艰难 ...
- Tensorflow2对GPU内存的分配策略
一.问题源起 从以下的异常堆栈可以看到是BLAS程序集初始化失败,可以看到是执行MatMul的时候发生的异常,基本可以断定可能数据集太大导致memory不够用了. 2021-08-10 16:38:0 ...
- 千亿参数开源大模型 BLOOM 背后的技术
假设你现在有了数据,也搞到了预算,一切就绪,准备开始训练一个大模型,一显身手了,"一朝看尽长安花"似乎近在眼前 -- 且慢!训练可不仅仅像这两个字的发音那么简单,看看 BLOOM ...
- DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍
DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍 1. 概述 近日来,ChatGPT及类似模型引发了人工智能(AI)领域的一场风潮. 这场风潮对数字世 ...
- java内存模型7-处理器内存模型
处理器内存模型 顺序一致性内存模型是一个理论参考模型,JMM和处理器内存模型在设计时通常会把顺序一致性内存模型作为参照.JMM和处理器内存模型在设计时会对顺序一致性模型做一些放松,因为如果完全按照顺序 ...
- 【转载】 Sqlserver限制最大占用内存
在Sqlserver数据库管理软件中,Sqlserver对系统内存的管理原则是:按需分配,并且分配完成后为了查询有更好的性能,并不会立即自动释放内存,数据取出后,还会一直占用着内存,所以在Sqlser ...
- PowerDesigner 学习:十大模型及五大分类
个人认为PowerDesigner 最大的特点和优势就是1)提供了一整套的解决方案,面向了不同的人员提供不同的模型工具,比如有针对企业架构师的模型,有针对需求分析师的模型,有针对系统分析师和软件架构师 ...
- OpenCL入门:(三:GPU内存结构和性能优化)
如果我们需要优化kernel程序,我们必须知道一些GPU的底层知识,本文简单介绍一下GPU内存相关和线程调度知识,并且用一个小示例演示如何简单根据内存结构优化. 一.GPU总线寻址和合并内存访问 假设 ...
随机推荐
- 无法访问k8s.gcr.io下载镜像问题解决办法
部署K8S最大的难题是镜像下载,在国内无FQ环境情况下很难从k8s.gcr.io等镜像源里下载镜像. 这种情况下正确做法是: 直接指定国内镜像代理仓库(如阿里云代理仓库)进行镜像拉取下载. 成功拉取代 ...
- 3.使用kubeadm方式搭建K8S集群
使用kubeadm方式搭建K8S集群 kubeadm是官方社区推出的一个用于快速部署kubernetes集群的工具. 这个工具能通过两条指令完成一个kubernetes集群的部署: # 创建一个 Ma ...
- 使用yt-dlp下载youtube高清2k 60fps视频
只演示windows下的操作,linux和mac应该差不多的命令行. 首先放上github仓库地址:https://github.com/yt-dlp/yt-dlp 它的介绍: 厉害啊,支持数千个网站 ...
- ES6 延展操作符
延展操作符(Spread operator) 延展操作符 = ...可以在函数调用/数组构造时,将数组表达式或者string在语法层面展开,还可以在构造对象时,将对象表达式按key-value的方式展 ...
- 深入源码之JDK Logging
JDK从1.4开始提供Logging实现,据说当初JDK打算采用Log4J的,后来因为某些原因谈判没谈拢,然后就自己开发了一套,不知道是为了报复而故意不沿用Log4J的命名方式和抽象方式,还是开发这个 ...
- 话说ReferenceQueue
也是几年前写的,在内部邮件列表里发过,在这里保存一下. 看到了这篇帖子: <WeakHashMap的神话>http://www.javaeye.com/topic/587995 因为Jav ...
- 缓存之ehcache 之使用
1. EHCache 的特点,是一个纯Java ,过程中(也可以理解成插入式)缓存实现,单独安装Ehcache ,需把ehcache-X.X.jar 和相关类库方到classpath中.如项目已安装了 ...
- 如何在原生鸿蒙中进行RN的断点调试
方式一 chrome devtools的方式 第一步:metro的方式加载bundle 先设置好原生这边的代码,然后记得打开RN服务器. 注意这个enableDebugger的值一定要设置为true ...
- IDEA 一个服务同时启动多个实例
有些时候为了测试,服务的分发,我们可以在IDEA中对一个微服务启动多个实例,配置方法如下: 1.编辑同时启动的微服务. 勾选 allow parallel run 2.编辑完成后复制一份配置. 3.复 ...
- 聊一下怎么十分钟速水CVE
题目是真的.今天晚上刚接触关于CVE的审计和提交.只能说:牛逼的是真牛逼,水的是真水. 我接下来教你,怎么在10分钟里找到一个CVE的中危漏洞并且提交.然后你就可以去咸鱼接单了,一个一铂快 打开htt ...