
pandas之cut(),qcut()
功能:将数据进行离散化
可参见博客:https://blog.csdn.net/missyougoon/article/details/83986511 , 例子简易好懂

>>> factors = np.random.randn(9)

[ 2.12046097  0.24486218  1.64494175 -0.27307614 -2.11238291 2.15422205 -0.46832859  0.16444572  1.52536248]
传入bins参数
>>> pd.cut(factors, 3) #返回每个数对应的分组

[(0.732, 2.154], (-0.69, 0.732], (0.732, 2.154], (-0.69, 0.732], (-2.117, -0.69], (0.732, 2.154], (-0.69, 0.732], (-0.69, 0.732], (0.732, 2.154]]

Categories (3, interval[float64]): [(-2.117, -0.69] < (-0.69, 0.732] < (0.732, 2.154]]

>>> pd.cut(factors, bins=[-3,-2,-1,0,1,2,3])

[(2, 3], (0, 1], (1, 2], (-1, 0], (-3, -2], (2, 3], (-1, 0], (0, 1], (1, 2]]

Categories (6, interval[int64]): [(-3, -2] < (-2, -1] < (-1, 0] < (0, 1] (1, 2] < (2, 3]]

>>> pd.cut(factors, 3).value_counts() #计算每个分组中含有的数的数量

Categories (3, interval[float64]): [(-2.117, -0.69] < (-0.69, 0.732] < (0.732, 2.154]]

(-2.117, -0.69]    1

(-0.69, 0.732]     4

(0.732, 2.154]     4
传入lable参数
>>> pd.cut(factors, 3,labels=["a","b","c"]) #返回每个数对应的分组,但分组名称由label指示

[c, b, c, b, a, c, b, b, c]

Categories (3, object): [a < b < c]

>>> pd.cut(factors, 3,labels=False) #返回每个数对应的分组,但仅显示分组下标

[2 1 2 1 0 2 1 1 2]
传入retbins参数
>>> pd.cut(factors, 3,retbins=True)# 返回每个数对应的分组,且额外返回bins,即每个边界值

([(0.732, 2.154], (-0.69, 0.732], (0.732, 2.154], (-0.69, 0.732], (-2.117, -0.69], (0.732, 2.154], (-0.69, 0.732], (-0.69, 0.732], (0.732, 2.154]]

Categories (3, interval[float64]): [(-2.117, -0.69] < (-0.69, 0.732] < (0.732, 2.154]], array([-2.11664951, -0.69018126,  0.7320204 ,  2.15422205]))
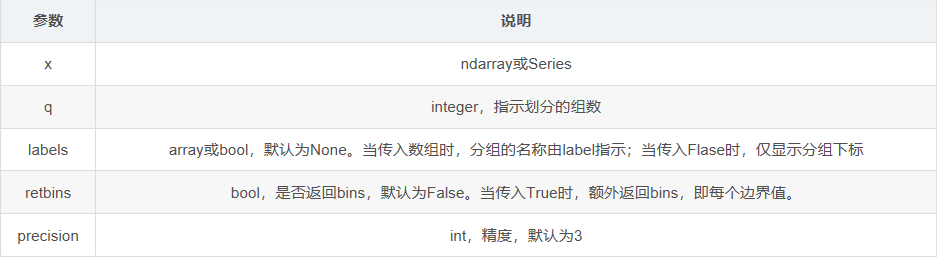
>>> pd.qcut(factors, 3) #返回每个数对应的分组

[(1.525, 2.154], (-0.158, 1.525], (1.525, 2.154], (-2.113, -0.158], (-2.113, -0.158], (1.525, 2.154], (-2.113, -0.158], (-0.158, 1.525], (-0.158, 1.525]]

Categories (3, interval[float64]): [(-2.113, -0.158] < (-0.158, 1.525] < (1.525, 2.154]]

>>> pd.qcut(factors, 3).value_counts() #计算每个分组中含有的数的数量

(-2.113, -0.158]    3

(-0.158, 1.525]     3

(1.525, 2.154]      3
传入lable参数
>>> pd.qcut(factors, 3,labels=["a","b","c"]) #返回每个数对应的分组,但分组名称由label指示

[c, b, c, a, a, c, a, b, b]

Categories (3, object): [a < b < c]

>>> pd.qcut(factors, 3,labels=False) #返回每个数对应的分组,但仅显示分组下标

[2 1 2 0 0 2 0 1 1]
传入retbins参数
>>> pd.qcut(factors, 3,retbins=True)# 返回每个数对应的分组,且额外返回bins,即每个边界值

[(1.525, 2.154], (-0.158, 1.525], (1.525, 2.154], (-2.113, -0.158], (-2.113, -0.158], (1.525, 2.154], (-2.113, -0.158], (-0.158, 1.525], (-0.158, 1.525]]

Categories (3, interval[float64]): [(-2.113, -0.158] < (-0.158, 1.525] < (1.525, 2.154],array([-2.113,  -0.158 ,  1.525,  2.154]))
另一个例子:
import numpy as np

from numpy import *

import pandas as pd

df = pd.DataFrame()

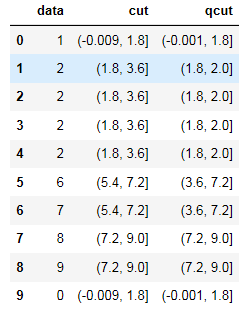
df['data'] = [1,2,2,2,2,6,7,8,9,0]#这里注意箱边界值需要唯一,不然qcut时程序会报错

df['cut']=pd.cut(df['data'],5)

df['qcut']=pd.qcut(df['data'],5)

df.head(10)
运行结果如图:
可以看到cut列各个分段之间间距相等,qcut由于数据中‘2’较多,所以2附近间距较小,2之后的分段间距较大。
pandas之cut(),qcut()的更多相关文章
- Pandas中的qcut和cut
qcut与cut的主要区别: qcut:传入参数,要将数据分成多少组,即组的个数,具体的组距是由代码计算 cut:传入参数,是分组依据.具体见示例 1.qcut方法,参考链接:http://panda ...
- pandas之cut
cut( )用来把一组数据分割成离散的区间. cut(x, bins, right=True, labels=None, retbins=False, precision=3, include_low ...
- pandas的基本功能(一)
第16天pandas的基本功能(一) 灵活的二进制操作 体现在2个方面 支持一维和二维之间的广播 支持缺失值数据处理 四则运算支持广播 +add - sub *mul /div divmod()分区和 ...
- pandas的离散化,面元划分
pd.cut pandas.cut(x, bins, right=True, labels=None, retbins=False, precision=, include_lowest=False) ...
- 利用Python进行数据分析-Pandas(第四部分-数据清洗和准备)
在数据分析和建模的过程中,相当多的时间要用在数据准备上:加载.清理.转换以及重塑上.这些工作会占到分析时间的80%或更多.有时,存储在文件和数据库中的数据的格式不适合某个特定的任务.研究者都选择使用编 ...
- pandas - groupby 深入及数据清洗案例
import pandas as pd import numpy as np 分割-apply-聚合 大数据的MapReduce The most general-purpose GroupBy me ...
- pandas 常规操作大全
那年夏天抓住了蝉的尾巴 gitbook 前言 pandas 抓住 Series (排序的字典), DataFrame (row + 多个 Series) 对象 , 就如同 numpy 里抓住 ndar ...
- 数据处理:12个使得效率倍增的pandas技巧
数据处理:12个使得效率倍增的pandas技巧 1. 背景描述 Python正迅速成为数据科学家偏爱的语言,这合情合理.它拥有作为一种编程语言广阔的生态环境以及众多优秀的科学计算库.如果你刚开始学习P ...
- pandas 初识(三)
Python Pandas 空值 pandas 判断指定列是否(全部)为NaN(空值) import pandas as pd import numpy as np df = pd.DataFrame ...
随机推荐
- POJ 2486
因为苹果可能在不同的子树中,所以,很容易想到设状态dp_back[i][j]为以i点为树根走j步并回到i点的最大苹果数与dp_to[i][j]不回到i点的两个状态. 于是,转移方程就很明显了.只是注意 ...
- 【Python学习笔记】-APP图标显示未读消息数目
以小米手机系统为例,当安装的某个APP有未读消息时,就会在该APP图标的右上角显示未读消息的数目.本文主要解说怎样用Python语言实现图标显示未读消息的数目.首先,还是要用到Python中PIL库, ...
- Eclipse打开ftl文件,高亮显示
解决方式一:下载eclipse相关的freemarker插件 解决方式二:原生解决方式,方法特点无需下载插件,和eclipse编辑html和jsp文件一模一样 步骤: 1:windows---pref ...
- TF-IDF算法--关键词句和文本集中每篇文章相关度计算
关键词句和文本集每篇文章相关度计算:假设语料库中有几万篇文章,每篇文章的长度不一,你任意输入关键词或句子,通过代码以tf-idf值为准检索出来相似度高的文章. 1.TF-IDF概述 TF-IDF是一种 ...
- java环境的配置和求最大子数组
做java开发的朋友,都应该有一个适合自己的开发环境,而eclipse就是这么一个适合java开发的集成环境,完全免费,是java开发人员的必备平台.在安装eclipse之前需要安装JDK, JDK是 ...
- linux 免密登陆(超简单)
一.客户端生产公钥 在windwos上 生成公钥私钥前,先下载git哦 ssh-keygen -t rsa# 记住下方方框内公钥保存地址, 二.查看自己用户的登录地址 cat /etc/passwd ...
- Ajax请求成功但是一直进入error的原因
1.在1.3版本的jQuery以后,严格要求了json格式,如果返回的值不是json格式,他就会执行error函数. 所以如果想让他走success函数的话,还是在后台把数据格式化成json格式吧. ...
- vue项目中阻止浏览器返回上一页
vue项目中在某个页面阻止浏览器返回上一页,适用移动端.PC端. 使用场景例如: 首页 与 A页面 来回跳转,那样点击浏览器返回时也会来回跳转,本想当页面在首页的时候就不再返回了,所以这个时候 ...
- Hadoop MapReduce编程 API入门系列之计数器(二十七)
不多说,直接上代码. MapReduce 计数器是什么? 计数器是用来记录job的执行进度和状态的.它的作用可以理解为日志.我们可以在程序的某个位置插入计数器,记录数据或者进度的变化情况. Ma ...
- Npgsql使用入门(一)【搭建环境】
首先去官网下载最新数据库安装包 postgresql-9.6.1-1-windows-x64 将postgreSQL9.6注册为windows服务 注意:大小写要正确 D:\Worksoftware\ ...