
面试官: ShardingSphere 学一下吧
文章目录
学习之前先了解下分库分表概念:https://spiritmark.blog.csdn.net/article/details/109524713
一、ShardingSphere简介
在数据库设计时候考虑垂直分库和垂直分表。随着数据库数据量增加,不要马上考虑做水平切分,首先考虑缓存处理,读写分离,使 用索引等等方式,如果这些方式不能根本解决问题了,再考虑做水平分库和水平分表。
分库分表导致的问题:
- 跨节点连接查询问题(分页、排序)
- 多数据源管理问题
Apache ShardingSphere是一套开源的分布式数据库中间件解决方案组成的生态圈,它由 JDBC、 Proxy和 Sidecar(规划中)这 3 款相互独立,却又能够混合部署配合使用的产品组成。 它们均提供标准化的数据分片、分布式事务和数据库治理功能,可适用于如 Java同构、异构语言、云原生等各种多样化的应用场景。
Apache ShardingSphere定位为关系型数据库中间件,旨在充分合理地在分布式的场 景下利用关系型数据库的计算和存储能力,而并非实现一个全新的关系型数据库。 它通过关注不变,进而抓住事物本质。关系型数据库当今依然占有巨大市场,是各个公司核心业务的基石,未来也难于撼动,我们目前阶段更加关注在原有基础上的增量,而非颠覆。
二、Sharding-JDBC
Sharding-JDBC 是轻量级的 java 框架,是增强版的 JDBC 驱动,简化对分库分表之后数据相关操作。
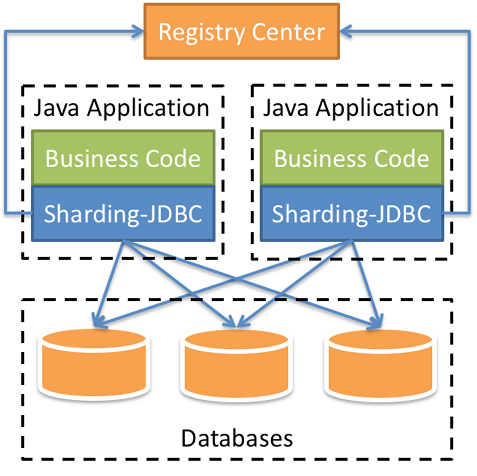
新建项目并添加依赖:
<parent>

    <groupId>org.springframework.bootgroupId>

    <artifactId>spring-boot-parentartifactId>

    <version>2.2.1.RELEASEversion>

parent>

<dependencies>

    <dependency>

        <groupId>org.springframework.bootgroupId>

        <artifactId>spring-boot-starterartifactId>

    dependency>

    <dependency>

        <groupId>org.springframework.bootgroupId>

        <artifactId>spring-boot-starter-testartifactId>

    dependency>

    <dependency>

        <groupId>com.alibabagroupId>

        <artifactId>druid-spring-boot-starterartifactId>

        <version>1.1.20version>

    dependency>

    <dependency>

        <groupId>mysqlgroupId>

        <artifactId>mysql-connector-javaartifactId>

    dependency>

    <dependency>

        <groupId>org.apache.shardingspheregroupId>

        <artifactId>sharding-jdbc-spring-boot-starterartifactId>

        <version>4.0.0-RC1version>

    dependency>

    <dependency>

        <groupId>com.baomidougroupId>

        <artifactId>mybatis-plus-boot-starterartifactId>

        <version>3.0.5version>

    dependency>

    <dependency>

        <groupId>org.projectlombokgroupId>

        <artifactId>lombokartifactId>

    dependency>

dependencies>
2.1 Sharding-JDBC实现水平分表
① 按照水平分表的方式,创建数据库和数据库表
水平分表规则:如果添加 cid是偶数把数据添加 course_1,如果是奇数添加到 course_2
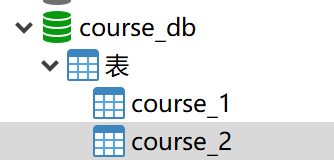
CREATE TABLE `course_1`  (

  `cid` bigint(16) NOT NULL,

  `cname` varchar(255) ,

  `userId` bigint(16),

  `cstatus` varchar(16) ,

  PRIMARY KEY (`cid`)

)
② 编写实体和 Mapper 类
@Data

public class Course {

    private Long cid;

    private String cname;

    private Long userId;

    private String cstatus;

}
@Repository

public interface CourseMapper extends BaseMapper<Course> {

}
③ 详细配置文件
spring:

  main:

    allow-bean-definition-overriding: true

  shardingsphere:

    datasource:

      names: m1

      m1:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3306/course_db?serverTimezone=GMT%2B8

        username: root

        password: 1234

    sharding:

      tables:

        course:

          actual-data-nodes: m1.course_$->{1..2}

          key-generator:

            column: cid

            type: SNOWFLAKE

          table-strategy:

            inline:

              shardingcolumn: cid

              algorithm-expression: course_$->{cid%2+1}

    props:

      sql:

        show: true

mybatis-plus:

  configuration:

    map-underscore-to-camel-case: false
④ 测试
@RunWith(SpringRunner.class)

@SpringBootTest

public class ShardingSphereTestApplication {

    @Autowired

    CourseMapper courseMapper;

    @Test

    public void addCourse() {

        for (int i = 1; i  10; i++) {

            Course course = new Course();

            course.setCname("java" + i);

            course.setUserId(100L);

            course.setCstatus("Normal" + i);

            courseMapper.insert(course);

        }

    }

    @Test

    public void queryCourse() {

        QueryWrapper<Course> wrapper = new QueryWrapper<>();

        wrapper.eq("cid",493001315358605313L);

        Course course = courseMapper.selectOne(wrapper);

        System.out.println(course);

    }

}
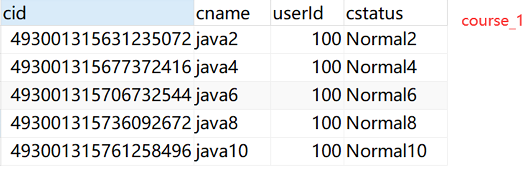
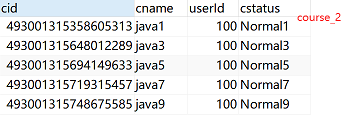
2.2 Sharding-JDBC实现水平分库
① 需求分析
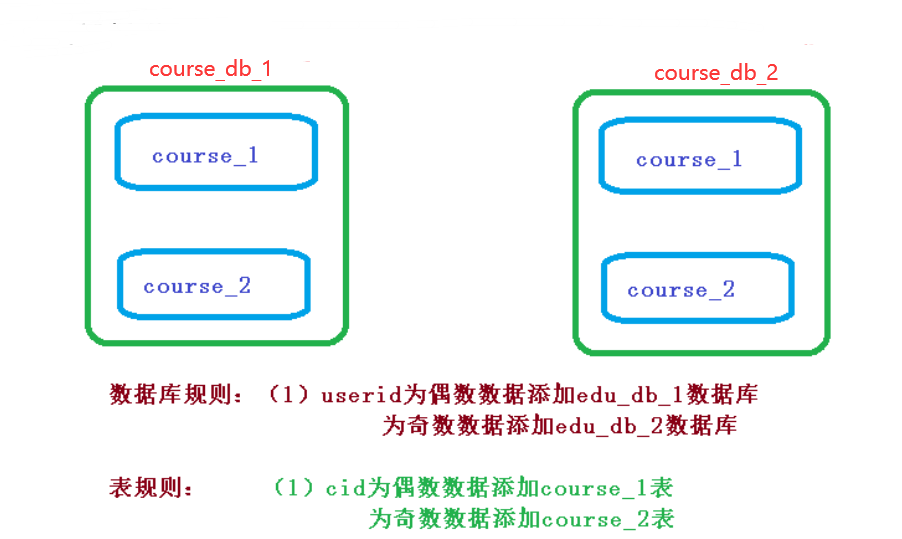
② 创建数据库和表
③ 详细配置文件
spring:

  main:

    allow-bean-definition-overriding: true

  shardingsphere:

    datasource:

      names: m1,m2

      m1:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3306/course_db_2?serverTimezone=GMT%2B8

        username: root

        password: 1234

      m2:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3306/course_db_3?serverTimezone=GMT%2B8

        username: root

        password: 1234

    sharding:

      tables:

        course:

          actual-data-nodes: m$->{1..2}.course_$->{1..2}

          key-generator:

            column: cid

            type: SNOWFLAKE

          database-strategy:

            inline:

              sharding-column: userId

              algorithm-expression: m$->{userId%2+1}

          table-strategy:

            inline:

              sharding-column: cid

              algorithm-expression: course_$->{cid%2+1}

    props:

      sql:

        show: true

mybatis-plus:

  configuration:

    map-underscore-to-camel-case: false
④ 测试代码
@RunWith(SpringRunner.class)

@SpringBootTest

public class ShardingSphereTestApplication {

    @Autowired

    CourseMapper courseMapper;

    @Test

    public void addCourse() {

        for (int i = 1; i  20; i++) {

            Course course = new Course();

            course.setCname("java" + i);

            int random = (int) (Math.random() * 10);

            course.setUserId(100L + random);

            course.setCstatus("Normal" + i);

            courseMapper.insert(course);

        }

    }

    @Test

    public void queryCourse() {

        QueryWrapper<Course> wrapper = new QueryWrapper<>();

        wrapper.eq("cid", 493001315358605313L);

        Course course = courseMapper.selectOne(wrapper);

        System.out.println(course);

    }

}
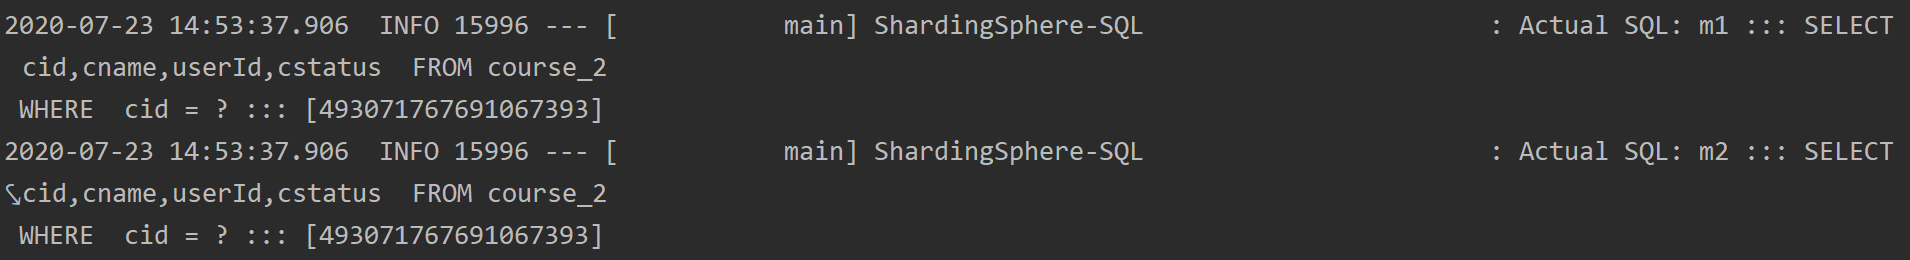
查询实际对应的 SQL:
2.3 Sharding-JDBC操作公共表
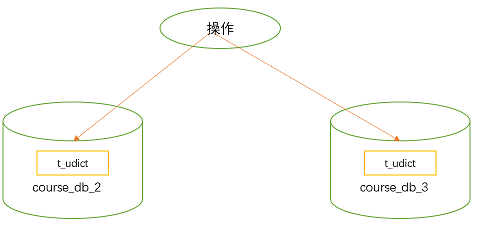
公共表 :
- 存储固定数据的表,表数据很少发生变化,查询时候经常进行关联
- 在每个数据库中创建出相同结构公共表
① 思路分析
② 在对应数据库创建公共表 t_udict,并创建对应实体和 Mapper``
CREATE TABLE `t_udict`  (

  `dict_id` bigint(16) NOT NULL,

  `ustatus` varchar(16) ,

  `uvalue` varchar(255),

  PRIMARY KEY (`dict_id`)

)
③ 详细配置文件
spring:

  main:

    allow-bean-definition-overriding: true

  shardingsphere:

    datasource:

      names: m1,m2

      m1:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3306/course_db_2?serverTimezone=GMT%2B8

        username: root

        password: 1234

      m2:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3306/course_db_3?serverTimezone=GMT%2B8

        username: root

        password: 1234

    sharding:

      tables:

        course:

          actual-data-nodes: m$->{1..2}.course_$->{1..2}

          key-generator:

            column: cid

            type: SNOWFLAKE

          database-strategy:

            inline:

              sharding-column: userId

              algorithm-expression: m$->{userId%2+1}

          table-strategy:

            inline:

              sharding-column: cid

              algorithm-expression: course_$->{cid%2+1}

        t_udict:

          key-generator:

            column: dict_id

            type: SNOWFLAKE

      broadcast-tables: t_udict

    props:

      sql:

        show: true

mybatis-plus:

  configuration:

    map-underscore-to-camel-case: false
④ 进行测试
经测试:数据插入时会在每个库的每张表中插入,删除时也会删除所有数据。
@RunWith(SpringRunner.class)

@SpringBootTest

public class ShardingSphereTestApplication {

    @Autowired

    UdictMapper udictMapper;

    @Test

    public void addUdict() {

        Udict udict = new Udict();

        udict.setUstatus("a");

        udict.setUvalue("已启用");

        udictMapper.insert(udict);

    }

    @Test

    public void deleteUdict() {

        QueryWrapper<Udict> wrapper = new QueryWrapper<>();

        wrapper.eq("dict_id", 493080009351626753L);

        udictMapper.delete(wrapper);

    }

}
2.4 Sharding-JDBC实现读写分离
为了确保数据库产品的稳定性,很多数据库拥有双机热备功能。也就是,第一台数据库服务器是对外提供增删改业务的生产服务器;第二台数据库服务器主要进行读的操作。
Sharding-JDBC通过 sql语句语义分析,实现读写分离过程,不会做数据同步,数据同步通常数据库集群间会自动同步。
详细配置文件:
spring:

  main:

    allow-bean-definition-overriding: true

  shardingsphere:

    datasource:

      names: m0,s0

      m0:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3306/course_db?serverTimezone=GMT%2B8

        username: root

        password: 1234

      s0:

        type: com.alibaba.druid.pool.DruidDataSource

        driver-class-name: com.mysql.cj.jdbc.Driver

        url: jdbc:mysql://192.168.182.200:3307/course_db?serverTimezone=GMT%2B8

        username: root

        password: 1234

    masterslave:

      master-data-source-name: m0

      slave-data-source-names: s0

    props:

      sql:

        show: true

mybatis-plus:

  configuration:

    map-underscore-to-camel-case: false
经过测试:增删改操作都是会通过 master数据库,同时 master数据库会同步数据给 slave数据库;查操作都是通过 slave数据库.
三、Sharding-Proxy
Sharding-Proxy定位为 透明化的数据库代理端,提供封装了数据库二进制协议的服务端版本,用于完成对异构语言的支持, 目前仅 MySQL和 PostgreSQL版本。
Sharding-Proxy是独立应用,需要安装服务,进行分库分表或者读写分离配置,启动使用。
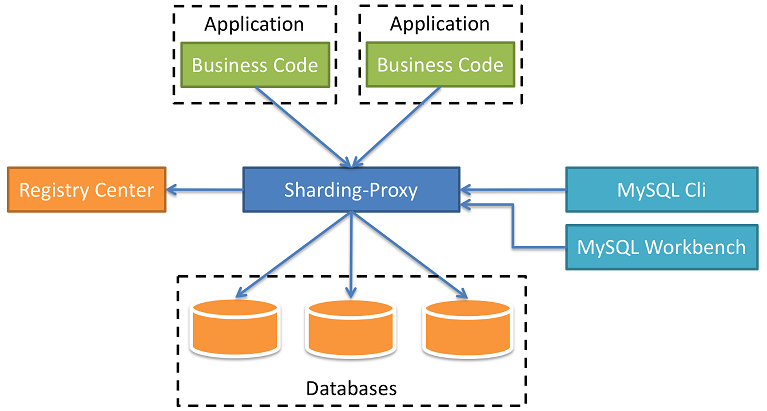
Sharding-proxy的使用参考:Sharding-Proxy的基本使用。
微信搜一搜 : 全栈小刘 ,获取文章 pdf 版本
面试官: ShardingSphere 学一下吧的更多相关文章
- 一些Java中不为人知的特殊方法,学完后面试官可能都没你知道的多!
如果你用过反射并且执行过getDeclaredMethods方法的话,你可能会感到很吃惊.你会发现出现了很多源代码里没有的方法.如果你看一下这些方法的修饰符的话,可能会发现里面有些方法是volatil ...
- 学完了这篇JVM,面试官真拿我没办法了!
在我们面试中经常会遇到面试官问一些有关JVM的问题,下面我大概从运行时数据域.类加载机制.类加载器.垃圾收集器.垃圾收集算法.JVM堆内存模型.JVM内存结构.JVM调优等几个方面来讲一下JVM. 一 ...
- 关键词:ACM & 大小端 & 面试官
关于“ACM” fender0107401 :面试了一个在ACM拿过奖的人 我问了他几个问题: 读取数组中的一个元素,计算复杂度是多少,回答不清楚. 往链表里面存一个数,不排序的情况下,计算复杂度是多 ...
- 走向DBA[MSSQL篇] 面试官最喜欢的问题 ----索引+C#面试题客串
原文:走向DBA[MSSQL篇] 面试官最喜欢的问题 ----索引+C#面试题客串 对大量数据进行查询时,可以应用到索引技术.索引是一种特殊类型的数据库对象,它保存着数据表中一列或者多列的排序结果,有 ...
- 如何写出面试官欣赏的Java单例
单例模式是一种常用的软件设计模式.在它的核心结构中只包含一个被称为单例的特殊类.通过单例模式可以保证系统中一个类只有一个实例. 今天我们不谈单例模式的用途,只说一说如果在面试的时候面试官让你敲一段代码 ...
- 以技术面试官的经验分享毕业生和初级程序员通过面试的技巧(Java后端方向)
本来想分享毕业生和初级程序员如何进大公司的经验,但后来一想,人各有志,有程序员或许想进成长型或创业型公司或其它类型的公司,所以就干脆来分享些提升技能和通过面试的技巧,技巧我讲,公司你选,两厢便利. 毕 ...
- 图解Java线程的生命周期,看完再也不怕面试官问了
文章首发自个人微信公众号: 小哈学Java https://www.exception.site/java-concurrency/java-concurrency-thread-life-cycle ...
- Tomcat相关面试题,看这篇就够了!保证能让面试官颤抖!
Tomcat相关的面试题出场的几率并不高,正式因为如此,很多人忽略了对Tomcat相关技能的掌握. 这次整理了Tomcat相关的系统架构,介绍了Server.Service.Connector.Con ...
- 【长文】Google面试官分步解析自己泄漏前的面试题,超多干货和建议
本文翻译自Google工程师/面试官Alex Golec的文章:Google Interview Questions Deconstructed: The Knight's Dialer:翻译:实验楼 ...
随机推荐
- 一个定时任务管理器,基于Go语言和beego框架开发
链接 https://github.com/lisijie/webcron 安装说明 系统需要安装Go和MySQL. 获取源码 $ go get github.com/lisijie/webcron ...
- And Or IN Not操作符
再sql中And比or运算符优先级要更高,比如说 条件1 Or 条件2 And 条件3 如果先执行or,就是1or2 再and3 但是实际上是 2and3 再or 1,所以如果想要 1 ...
- 理解go语言的shellcode加载器
序言 本文假设你知道unsafe包常见函数的用法,若否,请查看 https://books.studygolang.com/gopl-zh/ch13/ch13-01.html 第13章. 例子和代码 ...
- flink:StreamExecutionEnvironment、DataStream和Transformation与StreamOperator
1.StreamExecutionEnvironment: StreamExecutionEnvironment是构建执行任务环境以及任务的启动的入口,主要具备以下几方面的职责: a.存储全局相关的参 ...
- 发现了一个关于 gin 1.3.0 框架的 bug
gin 1.3.0 框架 http 响应数据错乱问题排查 问题概述 客户端同时发起多个http请求,gin接受到请求后,其中一个接口响应内容为空,另外一个接口响应内容包含接口1,接口2的响应内容,导致 ...
- 基于CefSharp开发(二)自定义浏览器窗体
上一篇 https://www.cnblogs.com/mchao/p/13914726.html 简单了解了CefSharp引用配置但页面光秃秃的,这一篇着手开发简单浏览器窗体 一.Edge浏览器窗 ...
- js实现视频截图,视频批量截图,canvas实现
截取视频的某一时间的图像并保存 利用canvas的绘画能力画出视频某一帧的视频画面, 获得到图像之后转换成base64图像, 再利用a标签的实现自动保存到本地 html代码 <!DOCTYPE ...
- MVTMVC 区别
1,MVC的意思是 M:model V:views C:controller model是 主要是封装对数据库层的访问,对数据库中的数据进行增删改查操作 views 是 用于封装结果, 生程页面展示 ...
- 洛谷P3901 数列找不同(莫队水题)
重温下手感,判断区间是否全是不同的数字有两种做法,一个长度为len的区间不同的数字,参见HH的项链,一种是区间众数,参见蒲公英,是水题没错了.明天搞数据库,然后继续自己的gre和训练计划 #inclu ...
- 手写koa-static源码,深入理解静态服务器原理
这篇文章继续前面的Koa源码系列,这个系列已经有两篇文章了: 第一篇讲解了Koa的核心架构和源码:手写Koa.js源码 第二篇讲解了@koa/router的架构和源码:手写@koa/router源码 ...