
MongoDB学习4:MongoDB复制集机制和原理,搭建复制集
1.复制集的作用
1.1 MongoDB复制集的主要意义在于实现服务高可用
1.2 它的实现依赖于两个方面的功能:
· 数据写入时将数据迅速复制到另一个独立节点上
· 在接收写入的节点发生故障时自动选举出一个新的替代节点
1.3 在实现高可用的同时,复制集实现了其他几个附加作用:
· 数据分发:将数据从一个区域复制到另一个区域,减少另一个区域的读延迟
· 读写分离:不同类型的压力分别在不同的节点上执行
· 异地容灾:在数据中心故障时快速切换到异地
2.典型复制集结构
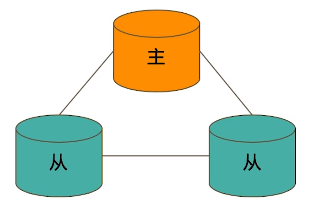
2.1 一个典型的复制集由3个以上具有投票权的节点组成,包括:
· 一个主节点(PRIMARY):接受写入操作和选举时投票
· 两个(或多个)从节点(SECONDARY):复制主节点上的新数据和选举时投票
· 不推荐使用Arbiter(投票节点,即不做数据存储只用来投票)
3. 数据是如何复制的?
- 当一个修改操作,无论是插入、更新或删除,到达主节点时,它对数据的操作将被记录下来(经过一些必要的转换),这些记录成为oplog
- 从节点通过在主节点上打开一个tailable游标不断获取新进入主节点的oplog,并在自己的数据上回放,以此保持与主节点数据一致

4. 通过选举完成故障恢复
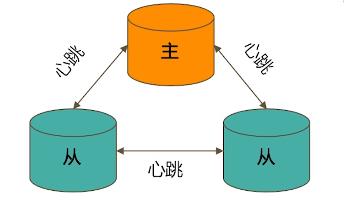
- 具有投票权的节点之间两两互相发送心跳(默认2s)
- 当5次心跳未收到时判断为节点失联
- 如果失联的是主节点,从节点会发起选举,选出新的主节点
- 如果失联的是从节点则不会产生新的选举
- 选举基于 RAFT一致性算法 实现,选举成功的必要条件是大多数投票节点存活
- 复制集最多可以有50个节点,但具有投票权的节点最多7个
影响选举的因素
- 整个集群必须有大多数节点存活
- 被选举为主节点的节点必须:
- 能够与多数节点建立连接
- 具有较新的oplog
- 具有较高的优先级(如果有配置)
复制集节点具有以下常见选项
- 是否具有投票权(v 参数):有则参与投票
- 优先级(priority 参数):优先级越高的节点越优先成为主节点。优先级为0的节点无法成为主节点
- 隐藏(hidden 参数):复制数据,但对应用不可见。隐藏节点可以具有投票权,但优先级必须为0
- 延迟(slaveDelay 参数):复制n秒之前的数据,保持与主节点的时间差
复制集注意事项
- 关于硬件
- 因为正常的复制集节点都有可能成为主节点,它们的地位是一样的,因此硬件配置上必须一致
- 为了保证节点不会同时宕机,各个节点使用的硬件必须具有独立性
- 关于软件
- 复制集各节点软件版本必须一致,防止出现不可预知的问题
- 增加节点不会增加系统写性能 !
5. 在一台机器上运行3个实例来搭建一个简单的复制集
5.1 通过实验将学会:
如何启动一个MongoDB实例
如何将3个MongoDB实例搭建成一个复制集
如何对复制集运行参数做一些常规调整
5.2 创建数据目录
mkdir -p /data/db{1,2,3}
5.3 准备配置文件并启动实例
复制集的每个MongoDB进程应该位于不同的服务器。我们现在在一台机器上运行3个进程,因此要为他们各自配置:
- 不同的端口(示例将使用28017、28019、28019)
- 不同的数据目录
- /data/db1
- /data/db2
- /data/db3
- 不同的日志文件路径
- /data/db1/mongod.log
- /data/db2/mongod.log
- /data/db3/mongod.log
- 三个配置文件:
- /data/db1/mongod.conf
systemLog:

 destination: file

 path: /data/db1/mongod.log   # log path

 logAppend: true

storage:

 dbPath: /data/db1    # data directory

net:

 bindIp: 0.0.0.0

 port: 28017

replication:

 replSetName: rs0

processManagement:

 fork: true
- /data/db2/mongod.conf
systemLog:

 destination: file

 path: /data/db2/mongod.log   # log path

 logAppend: true

storage:

 dbPath: /data/db2    # data directory

net:

 bindIp: 0.0.0.0

 port: 28018

replication:

 replSetName: rs0

processManagement:

 fork: true
- /data/db3/mongod.conf
systemLog:

 destination: file

 path: /data/db3/mongod.log   # log path

 logAppend: true

storage:

 dbPath: /data/db3    # data directory

net:

 bindIp: 0.0.0.0

 port: 28019

replication:

 replSetName: rs0

processManagement:

 fork: true
- 使用如下命令启动MongoDB实例(成功启动终端会显示success)
./mongod -f /data/db1/mongod.conf

./mongod -f /data/db2/mongod.conf

./mongod -f /data/db3/mongod.conf
- 使用
ps -ef | grep mongod来确认已经正确运行

5.4 配置复制集
- 方法1(此方式需要hostname能被解析,输入
hostname -f可以查看)
#假定使用28017做为主节点

./mongo --port 28017   # 进入mongodb的终端

> rs.initiate()

>rs.add("localhost:28018")  # 如果localhost不行可改为本机ip

>rs.add("localhost:28019")
- 方法2
#假定使用28017做为主节点

./mongo --port 28017   # 进入mongodb的终端

 # 如果localhost不行可改为本机ip

> rs.initiate({

  _id:"rs0",

  members:[{

   _id:0,

   host:"localhost:28017"

  },{

   _id:1,

   host:"localhost:28018"

  },{

   _id:2,

   host:"localhost:28019"

  }]

})
- 使用
rs.status()可以查看复制集状态
5.5 验证复制集
- MongoDB主节点进行写入
# mongo localhost:28017

> db.test.insert({a:1})

> db.test.insert({a:2})
- MongoDB从节点进行读取
# mongo localhost:28018

> rs.salvaOk()

> db.test.find()
可以看到MongoDB几乎是没有延迟的,数据就可以同步到子节点上,建议在生产环境上一定要使用MongoDB的复制集
MongoDB学习4:MongoDB复制集机制和原理,搭建复制集的更多相关文章
- MongoDB学习笔记:MongoDB 数据库的命名、设计规范
MongoDB学习笔记:MongoDB 数据库的命名.设计规范 第一部分,我们先说命名规范. 文档 设计约束 UTF-8 字符 不能包含 \0 字符(空字符),这个字符标识建的结尾 . 和 $ ...
- MongoDB学习笔记——MongoDB 连接配置
MongoDB连接标准格式: mongodb://[username:password@]host1[:port1][,host2[:port2],...[,hostN[:portN]]][/[dat ...
- MongoDB学习笔记~MongoDB实体中的值对象
回到目录 注意,这里说的值对象是指在MongoDB实体类中的,并不是DDD中的值对象,不过,两者也是联系,就是它是对类的补充,自己本身没有存在的价值,而在值对象中,也是不需要有主键Id的,这与DDD也 ...
- MongoDB学习笔记系列
回到占占推荐博客索引 该来的总会来的,Ef,Redis,MVC甚至Sqlserver都有了自己的系列,MongoDB没有理由不去整理一下,这个系列都是平时在项目开发时总结出来的,希望可以为各位一些帮助 ...
- MongoDB学习笔记系列~目录
MongoDB学习笔记~环境搭建 (2015-03-30 10:34) MongoDB学习笔记~MongoDBRepository仓储的实现 (2015-04-08 12:00) MongoDB学习笔 ...
- MongoDB 学习笔记(原创)
MongoDB 学习笔记 mongodb 数据库 nosql 一.数据库的基本概念及操作 SQL术语/概念 MongoDB术语/概念 解释/说明 database database 数据库 table ...
- 分布式缓存技术redis学习系列(四)——redis高级应用(集群搭建、集群分区原理、集群操作)
本文是redis学习系列的第四篇,前面我们学习了redis的数据结构和一些高级特性,点击下面链接可回看 <详细讲解redis数据结构(内存模型)以及常用命令> <redis高级应用( ...
- 分布式缓存技术redis学习(四)——redis高级应用(集群搭建、集群分区原理、集群操作)
本文是redis学习系列的第四篇,前面我们学习了redis的数据结构和一些高级特性,点击下面链接可回看 <详细讲解redis数据结构(内存模型)以及常用命令> <redis高级应用( ...
- 分布式缓存技术redis系列(四)——redis高级应用(集群搭建、集群分区原理、集群操作)
本文是redis学习系列的第四篇,前面我们学习了redis的数据结构和一些高级特性,点击下面链接可回看 <详细讲解redis数据结构(内存模型)以及常用命令> <redis高级应用( ...
随机推荐
- 详解Vue大护法——组件
1.什么是组件化 人面对复杂问题的处理方式: 任何一个人处理信息的逻辑能力都是有限的 所以,当面对一个非常复杂的问题时,我们不太可能一次性搞定一大堆的内容. 但是,我们人有一种天生的能力,就是将问题进 ...
- 【mysql】- 索引简介篇
简介 我们都知道mysql使用存储引擎的是InnoDB,InnoDB使用的索引的对应的数据结构是B+树 结构图: 如上图所示,我们实际用户记录是存放在B+树的最底层的节点上,这些节点也被称为叶子节点或 ...
- Everything搜索表达式
导出搜索列表为txt或csv 索引最近变化 维持一个额外的按照最近变化排序的系统文件数据库,其可以通过 rc: 搜索,或以最近变化排序. 搜索运行次数大于 100: runcount:> ...
- 多云架构下,JAVA微服务技术选型实例解析
[摘要] 本文介绍了基于开源自建和适配云厂商开发框架两种构建多云架构的思路,以及这些思路的优缺点. 微服务生态 微服务生态本质上是一种微服务架构模式的实现,包括微服务开发SDK,以及微服务基础设施. ...
- 本地ES集群数据通过_reindex方式迁移到腾讯云服务器(亲测有效)
本地ES集群数据通过_reindex方式迁移到腾讯云服务器(亲测有效) 随着业务量的增加,本地的ES集群服务器性能和磁盘空间有点不够使用,项目组考虑使用腾讯云服务器,以下是我测试的使用_reindex ...
- 16 . Go之网络编程
互联网的本质 两台计算机之间的通信与两个人打电话原理是一样的. # 1. 首先要通过各种物理连接介质连接 # 2. 找准确对方计算机(准确到软件)的位置 # 3. 通过统一的标准(一般子协议)进行数据 ...
- 【新生学习】第一周:深度学习及pytorch基础
DEADLINE: 2020-07-25 22:00 写在最前面: 本课程的主要思路还是要求大家大量练习 pytorch 代码,在写代码的过程中掌握深度学习的各类算法,希望大家能够坚持练习,相信经度过 ...
- awk格式化
1,获取指定列和行,在指定列和行内插入 指定符号. /p/v2/api/winapi/mini/merchant/admin/notice/list/1/10?current=1&size=1 ...
- Hexo博客美化之蝴蝶(butterfly)主题魔改
Hexo是轻量级的极客博客,因为它简便,轻巧,扩展性强,搭建部署方便深受广大人们的喜爱.各种琳琅满路的Hexo主题也是被各种大佬开发出来,十分钦佩,向大佬仰望,大声称赞:流批!!! 我在翻看各种主 ...
- 删除GIT中的.DS_Store
转载自:https://www.jianshu.com/p/fdaa8be7f6c3 .DS_Store 是什么 使用 Mac 的用户可能会注意到,系统经常会自动在每个目录生成一个隐藏的 .DS_St ...