
Lucene核心数据结构——FST存词典,跳表存倒排或者roarning bitmap 见另外一个文章
Lucene实现倒排表没有使用bitmap,为了效率,lucene使用了一些策略,具体如下:
1. 使用FST保存词典,FST可以实现快速的Seek,这种结构在当查询可以表达成自动机时(PrefixQuery、FuzzyQuery、RegexpQuery等)效率很高。(可以理解成自动机取交集)
此种场景主要用在对Query进行rewrite的时候。
2. FST可以表达出Term倒排表所在的文件偏移。
3. 倒排表使用SkipList结构。从上面的讨论可知,求倒排表的交集、并集、差集需要各种SeekTo(docId),SkipList能对Seek进行加速。
skiplist备忘
如今大部分工具使用的倒排链已经不是简单的链表了。一个常用,比如lucene中用的,叫skiplist,是一种高效的链表结构,在查询、添加、删除的时间复杂度上做到O(logN)。数据结构如下图:
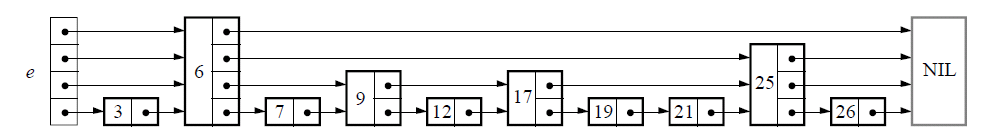
查询的过程很简单,从顶层开始,往后查询遇到节点的next()比待查的大或者到NIL了,节点不变下移一层继续向后查询,如此反复,直到到了底层还没查到。skiplist的资料也比较多,这里就不赘述了。
链表集合操作
直接引用转述这篇博文:http://www.cnblogs.com/forfuture1978/archive/2010/04/04/1704258.html 。作者很细致地把过程都列出来了,真是方便了大家啊,建议顺着读一边。
链表集合求交
lucene中用的是ConjunctionScorer ,大致过程是每条倒排链不断的推进到小于等于当前最大节点的位置。当然实现细节还是很丰富的,作者很细心的把过程都列出来了,建议顺着读一边。这里摘抄部分:
首先把倒排链按第一个next排序:

查看0~7的倒排链的第一个和最后一个是否相同,不同就开始找;取最后一个倒排的第一个元素8作为终点, 第一个链表开始找8

第0个链表 跳过1到了10,那么8也不用找了都去找10就行了

第1根链表找到了11,那么10也不用找了,找11,之后都这么做
 ......


之后遇到11,本次交集操作找到一个11,

后续的计算也是同理,当然整个代码实现会比较复杂和讨巧。基本思路就是每条倒排链能根据当前文档迅速跳过不符合的docid,由于倒排链可以用skiplist查询,因此即使很长的倒排链,如果交集的数量很少,整个求解过程可以很快跳过不需要比较的节点。
Lucene核心数据结构——FST存词典,跳表存倒排或者roarning bitmap 见另外一个文章的更多相关文章
- 聊聊Mysql索引和redis跳表 ---redis的有序集合zset数据结构底层采用了跳表原理 时间复杂度O(logn)(阿里)
redis使用跳表不用B+数的原因是:redis是内存数据库,而B+树纯粹是为了mysql这种IO数据库准备的.B+树的每个节点的数量都是一个mysql分区页的大小(阿里面试) 还有个几个姊妹篇:介绍 ...
- 自己动手实现java数据结构(九) 跳表
1. 跳表介绍 在之前关于数据结构的博客中已经介绍过两种最基础的数据结构:基于连续内存空间的向量(线性表)和基于链式节点结构的链表. 有序的向量可以通过二分查找以logn对数复杂度完成随机查找,但由于 ...
- lucene底层数据结构——FST,针对field使用列存储,delta encode压缩doc ids数组,LZ4压缩算法
参考: http://www.slideshare.net/lucenerevolution/what-is-inaluceneagrandfinal http://www.slideshare.ne ...
- lucene .doc里存储的skiplist跳表
http://forfuture1978.iteye.com/blog/546841 见图: lucene-6.5.1-src/lucene-6.5.1$ grep "skiplistwri ...
- ES索引文件和数据文件大小对比——splunk索引文件大小远小于ES,数据文件的压缩比也较ES更低,有趣的现象:ES数据文件zip压缩后大小和splunk的数据文件相当!词典文件tim/tip+倒排doc/pos和cfs文件是索引的大头
和splunk对比: ES中各个倒排索引文件的分布: 测试说明:ES2.41版本,数据使用500次批量插入,每批数据都不同,大小500条,每条数据50个字段,对应的字符串使用长度为1-10个单词随机生 ...
- skiplist(跳表)的原理及JAVA实现
前记 最近在看Redis,之间就尝试用sortedSet用在实现排行榜的项目,那么sortedSet底层是什么结构呢? "Redis sorted set的内部使用HashMap和跳跃表(S ...
- [转载] 跳表SkipList
原文: http://www.cnblogs.com/xuqiang/archive/2011/05/22/2053516.html leveldb中memtable的思想本质上是一个skiplist ...
- 跳表SkipList
原文:http://www.cnblogs.com/xuqiang/archive/2011/05/22/2053516.html 跳表SkipList 1.聊一聊跳表作者的其人其事 2. 言归正 ...
- C语言跳表(skiplist)实现
一.简介 跳表(skiplist)是一个非常优秀的数据结构,实现简单,插入.删除.查找的复杂度均为O(logN).LevelDB的核心数据结构是用跳表实现的,redis的sorted set数据结构也 ...
随机推荐
- element-ui table 默认全选
来自: https://juejin.im/post/5cf24f1ee51d4577583ddc77 侵删 this.deviceTableData = res.body || []; // con ...
- body onload()事件和table insertRow()、tr insertCell()
onload事件: 定义和用法: onload 事件会在页面或图像加载完成后立即发生. onload 通常用于 <body> 元素,在页面完全载入后(包括图片.css文件等等.)执行脚本代 ...
- CVE-2019-11517 CSRF in Wampserver 3.1.4-3.1.8
https://www.cnblogs.com/iAmSoScArEd/ Affected product:WampServer 3.1.4-3.1.8 Offiical description:&q ...
- 使用Idea初始化一个spring boot 项目
配置环境 Idea配置jdk8.0 1.打开Idea,点击右上角file,找到Other Settings选项,点击下方的Default Project Structure,如下所示 2.点击下图中所 ...
- Python中的上下文管理器(contextlib模块)
上下文管理器的任务是:代码块执行前准备,代码块执行后收拾 1 如何使用上下文管理器: 打开一个文件,并写入"hello world" filename="my.txt&q ...
- [#Linux] CentOS 7 安装微信详细过程
微信安装 微信安装过程如下: 1,下载最新版本tar.gz压缩包 wget https://github.com/geeeeeeeeek/electronic-wechat/releases/down ...
- 【DRF框架】利用序列化组件操作
使用序列化组件进行操作 不带参数:查+增 带参数:查.改.删 不带参数的操作 # url路由 url(r'^book_list/$',Search_book.as_view()), # views.p ...
- Jenkins管理插件
1 配置自动更新的镜像 https://mirrors.tuna.tsinghua.edu.cn/jenkins/updates/update-center.json 系统管理-----插件管理--- ...
- Mongodb创建用户Error: couldn’t add user: Use of SCRAM-SHA-256 requires undigested passwords
解决方案:修改mechanisms加密方式为SCRAM-SHA-1 db.createUser({ user: "admin", pwd: "xxx", rol ...
- 开源框架---tensorflow c++ API 运行第一个“手写字的例子”
#CMakeLists.txt cmake_minimum_required (VERSION ) project (tf_example) set(CMAKE_CXX_FLAGS "${C ...