
用python requests库写一个人人网相册爬虫
担心人人网会黄掉,写个爬虫,把我的相册照片都下载下来。代码如下:
# -*- coding: utf-8 -*-

import requests

import json

import os

def mkdir(path):

    path=path.strip()

    path=path.rstrip("\\")

    isExists=os.path.exists(path)

    if not isExists:

        print path+u' 创建成功'

        os.makedirs(path)

        return "yes"

    else:

        print path+u' 目录已存在'

        return "no"

def login_renren(s):

    origin_url = 'http://www.renren.com'

    login_data = {

        'email':'用户名',

        'domain':'renren.com',

        'origURL':'http://www.renren.com/home',

        'key_id':'',

        'captcha_type':'web_login',

        'password':'密码抓包获得',

        'rkey':'rkey抓包获得'

    }

    r = s.post("http://www.renren.com/ajaxLogin/login?1=1&uniqueTimestamp=2016742045262", data = login_data)

    if 'true' in r.content:

        print u'登录人人网成功'

    return s

def get_albums(s):

    r = s.get('http://photo.renren.com/photo/278382090/albumlist/v7?showAll=1#')

    #print r.content

    content = r.content

    index1 = content.find('nx.data.photo = ')

    #print index1

    index2 = content.find('nx.data.hasHiddenAlbum =')

    #print index2

    target_json = content[index1+16:index2].strip()

    target_json = target_json[0:len(target_json)-1]

    #print target_json

    data = json.loads(target_json.replace("\'", '"'));

    album_list = data['albumList']

    album_count = album_list['albumCount']

    tip = u'一共有'+str(album_count)+u'个相册'

    print tip

    album_ids = []

    for album in album_list['albumList']:

        #print album['albumName']

        album_ids.append(album['albumId'])

    return album_ids,s

def download_albums(album_ids,s):

    #访问相册

    for album_id in album_ids:

        album_url = 'http://photo.renren.com/photo/278382090/album-'+album_id+'/v7'

        r = s.get(album_url)

        if "photoId" in r.content:

            print u'进入相册成功'

            #print r.content

            content = r.content

            index1 = content.find('nx.data.photo = ')

            #print index1

            index2 = content.find('; define.config')

            #print index2

            target_json = content[index1+16:index2].strip()

            target_json = target_json[13:len(target_json)-2]

            #print target_json

            data = json.loads(target_json.replace("\'", '"'));

            photos = data['photoList']

            album_name = data['albumName']

            # 定义并创建目录

            album_path = 'd:\\'+album_name

            #print album_path

            if mkdir(album_path)=='yes':

                for photo in photos:

                    #print photo['url']

                    image_name = photo['photoId']

                    photo_url = photo['url']

                    r = requests.get(photo_url)

                    image_path = album_path+'/'+image_name+'.jpg'

                    f = open(image_path, 'wb')

                    f.write(r.content)

                    f.close()

                    tip = u'相片'+image_name+u'下载成功'

                    print tip

            else:

                print u'相册已经下载'

#执行该文件的主过程

if __name__ == '__main__':

    #创建requests会话

    s = requests.Session()

    #登录人人网

    s = login_renren(s)

    #获取相册列表

    album_ids,s = get_albums(s)

    #下载相册

    download_albums(album_ids,s)
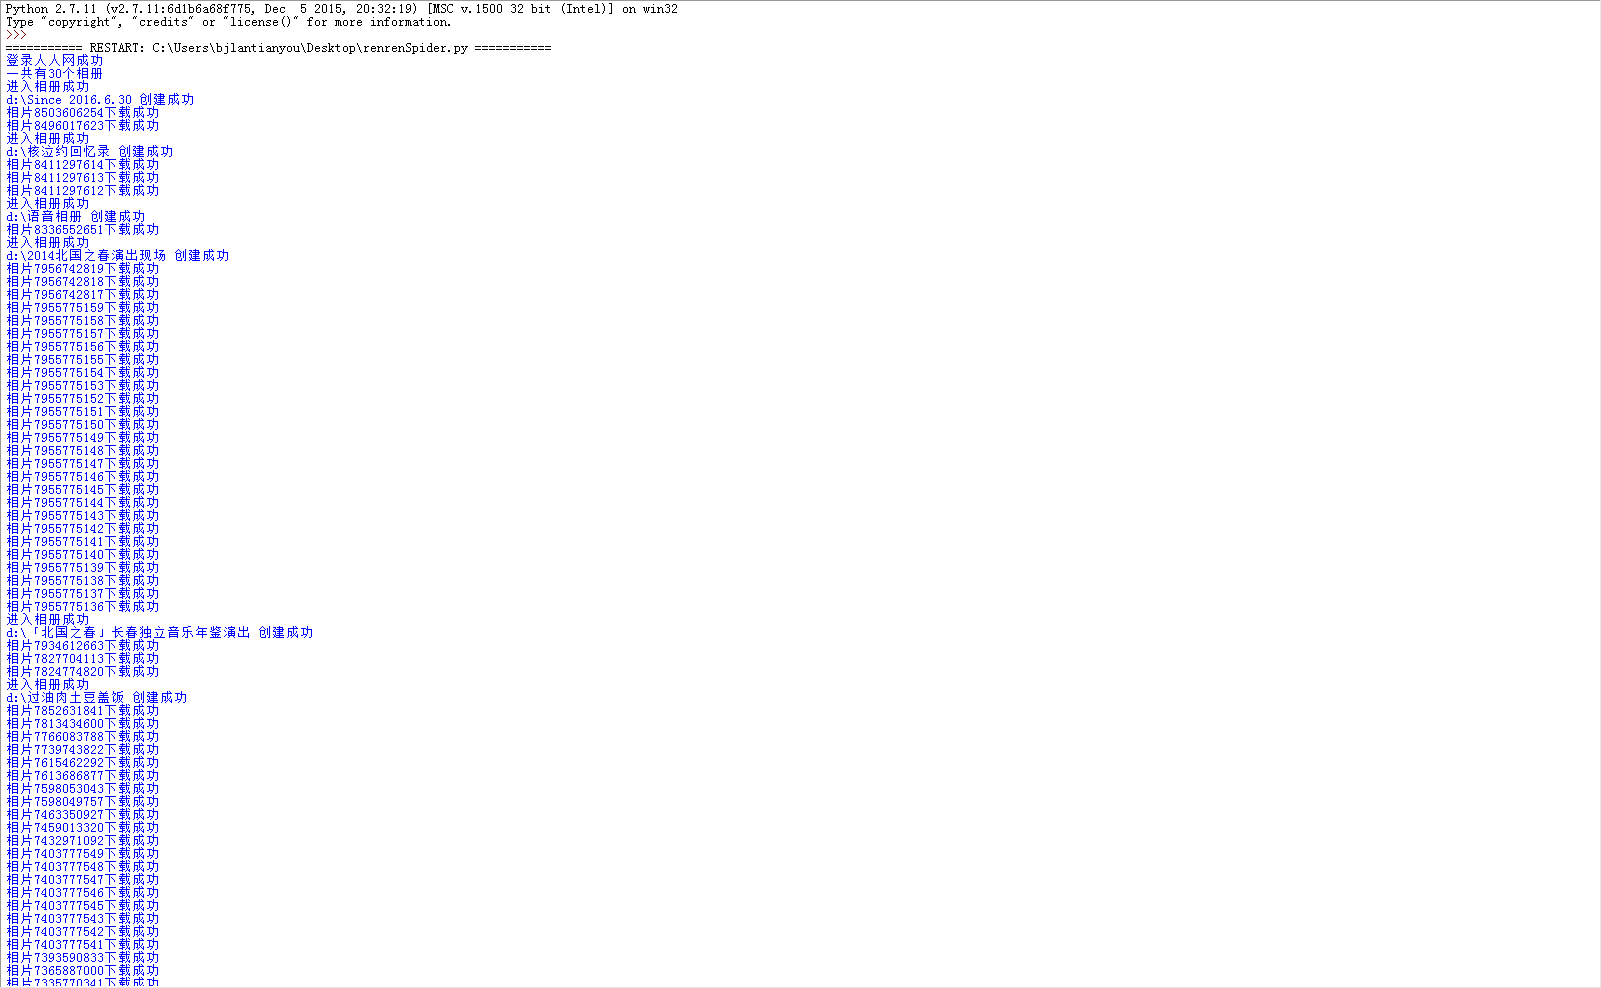
搞定!运行效果如下:


用python requests库写一个人人网相册爬虫的更多相关文章
- 使用python requests库写接口自动化测试--记录学习过程中遇到的坑(1)
一直听说python requests库对于接口自动化测试特别合适,但由于自身代码基础薄弱,一直没有实践: 这次赶上公司项目需要,同事小伙伴们一起学习写接口自动化脚本,听起来特别给力,赶紧实践一把: ...
- 大概看了一天python request源码。写下python requests库发送 get,post请求大概过程。
python requests库发送请求时,比如get请求,大概过程. 一.发起get请求过程:调用requests.get(url,**kwargs)-->request('get', url ...
- 用python的time库写一个进度条
运算符 算数运算 如a=10,b=20 +两个数相加 a+b=30 -两个数相减 a-b=-10 两个数相乘 a****b =200 /两个数相除b/a=2 %取模,并返回余数b%a=0 幂,a*** ...
- 【python爬虫】用requests库模拟登陆人人网
说明:以前是selenium登陆取cookie的方法比较复杂,改用这个 """ 用requests库模拟登陆人人网 """ import r ...
- Python Requests库简单入门
我对Python网络爬虫的学习主要是基于中国慕课网上嵩天老师的讲授,写博客的目的是为了更好触类旁通,并且作为学习笔记之后复习回顾. 1.引言 requests 库是一个简洁且简单的处理HTTP请求的第 ...
- python requests库学习笔记(上)
尊重博客园原创精神,请勿转载! requests库官方使用手册地址:http://www.python-requests.org/en/master/:中文使用手册地址:http://cn.pytho ...
- Python——Requests库的开发者接口
本文介绍 Python Requests 库的开发者接口,主要内容包括: 目录 一.主要接口 1. requests.request() 2. requests.head().get().post() ...
- Python:requests库、BeautifulSoup4库的基本使用(实现简单的网络爬虫)
Python:requests库.BeautifulSoup4库的基本使用(实现简单的网络爬虫) 一.requests库的基本使用 requests是python语言编写的简单易用的HTTP库,使用起 ...
- Python requests库的使用(一)
requests库官方使用手册地址:http://www.python-requests.org/en/master/:中文使用手册地址:http://cn.python-requests.org/z ...
随机推荐
- poj 1417(并查集+简单dp)
True Liars Time Limit: 1000MS Memory Limit: 10000K Total Submissions: 2087 Accepted: 640 Descrip ...
- [原创]java WEB学习笔记75:Struts2 学习之路-- 总结 和 目录
本博客的目的:①总结自己的学习过程,相当于学习笔记 ②将自己的经验分享给大家,相互学习,互相交流,不可商用 内容难免出现问题,欢迎指正,交流,探讨,可以留言,也可以通过以下方式联系. 本人互联网技术爱 ...
- javaIO整理
写在前面:本文章基本覆盖了java IO的全部内容,java新IO没有涉及,因为我想和这个分开,以突出那个的重要性,新IO哪一篇文章还没有开始写,估计很快就能和大家见面.照旧,文章依旧以例子为主,因为 ...
- BETWEEN and
select * from ( select *,ROW_NUMBER() over (ORDER BY AddTime desc) RowNumber from Product where ID n ...
- oracle的散列聚簇表
在簇表中,Oracle使用存储在索引中的键值来定位表中的行, 而在散列聚簇表中,使用了散列函数代替了簇索引,先通过内部函数或者自定义的函数进行散列计算,然后再将计算得到的码值用于定位表中的行. 创建散 ...
- 夺命雷公狗---TP商城----TP之样式和特效以及图片引入---2
---恢复内容开始--- 刚才见到笑脸了,那么下一步就到我们的shop目录下创建一个Admin的目录了,然后将Home目录里面的东西全部都拉进去即可 然后我们回到shop\Home\View目录下创建 ...
- 锋利的JQuery(三)
事件冒泡: 解决方式: 1.使用事件对象:$("element").bind("click",function(event){}); 这个事件对象只有事件处理函 ...
- EXCEL 删除重复项并保留最大最小值
自定义排序 框选需要主次排序的区域 开始—排序和筛选—自定义排序 添加筛选条件 若要获取最小值则次要关键字选择升序 排序后的数据 删除重复项 数据—删除重复项 选择要删除的列 删除A列的重复项后,B列 ...
- DELPHI出现无法加载dclite50.bpl的解决办法(转)
现象: Borland Integrated Translation Environment 加载出错 解决办法: 我的电脑--->(鼠标右键)属性--->高级--->(性能)设置- ...
- 关于 ActiveMQ
今天玩了下 ActiveMQ,希望实现服务器的消息可以通知到各个客户终端. 安装: 1.安装 ActiveMQ 之前必须安装 Java 的 jdk , 可以从此下载: http://www.ora ...