
scrapy的安装,scrapy创建项目
简要:

scrapy的安装
# 1)pip install scrapy -i https://pypi.douban.com/simple(国内源)

一步到位

# 2) 报错1: building 'twisted.test.raiser' extension
# error: Microsoft Visual C++ 14.0 is required. Get it with "Microsoft Visual C++
# Build Tools": http://landinghub.visualstudio.com/visual-cpp-build-tools
# 解决1
# http://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted
# Twisted‑20.3.0‑cp37‑cp37m‑win_amd64.whl
# cp是你的python版本
# amd是你的操作系统的版本

# 下载完成之后 使用pip install twisted的路径 安装
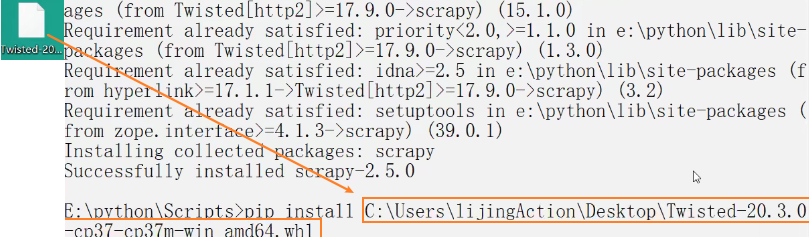
# 切记安装完twisted 再次安装scrapy
pip install scrapy -i https://pypi.douban.com/simple
# 3) 报错2:提示python -m pip install --upgrade pip
# 解决2 运行python -m pip install --upgrade pip
# 4) 报错3 win32的错误
# 解决3 pip install pypiwin32
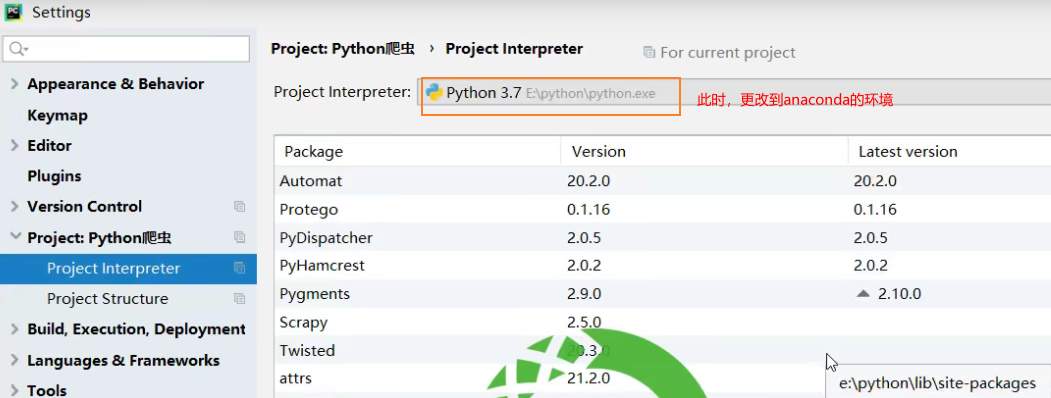
# 5)使用 anaconda



scrapy创建项目
cmd 到项目文件夹中


或者直接拖入
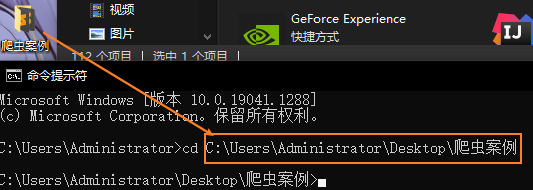
如果返回没有权限,使用管理员运行cmd
scrapy startproject scrapy_baidu
scrapy_baidu\下的文件夹


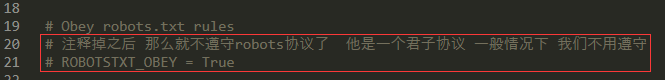
settings.py
spiders\baidu.py
import scrapy

class BaiduSpider(scrapy.Spider):

    # 爬虫的名字  用于运行爬虫的时候 使用的值

    name = 'baidu'

    # 允许访问的域名

    allowed_domains = ['http://www.baidu.com']

    # 起始的url地址  指的是第一次要访问的域名

    # start_urls 是在allowed_domains的前面添加一个http://

    #             在 allowed_domains的后面添加一个/

    start_urls = ['http://www.baidu.com/']

    # 是执行了start_urls之后 执行的方法   方法中的response 就是返回的那个对象

    # 相当于 response = urllib.request.urlopen()

    #       response  = requests.get()

    def parse(self, response):

        print('你好世界')
scrapy的安装,scrapy创建项目的更多相关文章
- C++框架_之Qt的开始部分_概述_安装_创建项目_快捷键等一系列注意细节
C++框架_之Qt的开始部分_概述_安装_创建项目_快捷键等一系列注意细节 1.Qt概述 1.1 什么是Qt Qt是一个跨平台的C++图形用户界面应用程序框架.它为应用程序开发者提供建立艺术级图形界面 ...
- Django在Win7下安装与创建项目hello word示例
Django在Win7下的安装及创建项目hello word的例子 有关python 的django 框架安装与开发的小例子.Django在Win7下的安装及创建项目hello word.1.安装:命 ...
- mac下配置Node.js开发环境、express安装、创建项目
mac下配置Node.js开发环境.express安装.创建项目 一.node.js的安装 去官网下载对应的平台版本就可以了,https://nodejs.org 二.express安装 sudo n ...
- Webpack指南(一):安装,创建项目,配置文件,开发环境以及问题汇总
Webpack是一个现代 JavaScript 应用程序的静态模块打包器(module bundler).当 webpack 处理应用程序时,它会递归地构建一个依赖关系图(dependency gra ...
- vue-cli 3.0 安装和创建项目流程
使用前我们先了解下3.0较2.0有哪些区别 一.3.0 新加入了 TypeScript 以及 PWA 的支持二.部分命令发生了变化: 1.下载安装 npm install -g vue@cli 2. ...
- vue安装及创建项目的几种方式
原文地址:https://www.wjcms.net/archives/vue安装及创建项目的几种方式 VUE安装的方式 直接用 script标签 引入 对于制作原型或学习,你可以这样使用最新版本: ...
- python爬虫框架—Scrapy安装及创建项目
linux版本安装 pip3 install scrapy 安装完成 windows版本安装 pip install wheel 下载twisted,网址:http://www.lfd.uci.edu ...
- scrapy框架安装及创建
介绍:大而全的爬虫组件 使用Anaconda conda install -c conda-forge scrapy 一.安装: windows 1.下载 https://www.lfd.uci.ed ...
- Maven入门学习,安装及创建项目
一.maven介绍: 1.maven是一个基于项目对象模型(POM Project Object Model),通过配置文件管理项目的工具(项目管理工具). 2.maven主要功能:发布项目(从编译到 ...
- [Scrapy] Mac安装Scrapy
Mac安装Scrapy Mac版本 10.11 El Captain. 前一段想在Mac上用Scrapy,各种问题.有一个不错的工具:Anaconda. 安装Anaconda 下载地址 我还是下pyt ...
随机推荐
- 四、mybatis动态sql
# 前言前面mysql都是通过静态sql进行查询的,但是如果业务复杂的时候,我们会遇到引号问题,或者多一个空格,这就使得sql代码编写错误了,所以为了解决这个问题,我们有了动态sql. Mybatis ...
- .NET跨平台实践:.NetCore、.Net5/6 Linux守护进程设计
之前,我写过两篇关于用C#开发Linux守护进程的技术文章,分别是<.NET跨平台实践:用C#开发Linux守护进程>和<.NET跨平台实践:再谈用C#开发Linux守护进程 - 完 ...
- 转载 使用wce进行本地和域的hash注入
参数解释:-l 列出登录的会话和NTLM凭据(默认值)-s 修改当前登录会话的NTLM凭据 参数:<用户名>:<域名>:<LM哈希>:<NT哈希>-r ...
- 前端规范之Git工作流规范(Husky + Comminilint + Lint-staged)
代码规范是软件开发领域经久不衰的话题,几乎所有工程师在开发过程中都会遇到或思考过这一问题.而随着前端应用的大型化和复杂化,越来越多的前端团队也开始重视代码规范.同样,前段时间,笔者所在的团队也开展了一 ...
- 全套Java教程_Java基础入门教程,零基础小白自学Java必备教程 #011 # 第十一单元 String&ArrayList #
一.本单元知识点概述 (Ⅰ)知识点概述 二.本单元教学目标 (Ⅰ)重点知识目标 1.ArrayList集合的常用方法2.ArrayList存储数据和遍历数据3.String类的构造方法4.String ...
- centos6.5 oracle 卸载
1.使用SQL*PLUS停止数据库 [oracle@OracleTest oracle]$ sqlplus / as sysdba SQL> shutdown immediate; SQL> ...
- 寻找最佳路径(ArcPy实现)
一.背景 随着社会经济发展需求,公路的重要性日益提高.在一些交通欠发达的地区,公路建设迫在眉睫.如何根据实际地形情况设计出比较合理的公路规划,是一个值得研究的问题. 二.实验目的: (1)通过练习,熟 ...
- Django基础1
一,web框架的本质 web应用的本质就是一个socket的服务端.而用户的浏览器就是一个客户端,具体事例如下: import socket sk = socket.socket() sk.bind( ...
- AutoCAD云产品平台ForgeViewer格式离线部署思路分析
背景 在上一篇博文中CAD图DWG解析WebGIS可视化技术分析总结提到,利用AutoCAD的自有云产品 Autodesk Forge,能在浏览器中渲染 3D 和 2D 模型数据,实现DWG图形的We ...
- 2021北航敏捷软工Beta阶段评分与总结
概述 Beta 阶段评分,按照之前的规则,主要组成部分为: 博客部分,基于 Beta 阶段博客的评分(每篇正规博客 10 分,每篇 Scrum5 分,评定方式类比往年) 评审部分,基于 Beta 阶段 ...