
Lucene 基础数据压缩处理
Lucene 为了使的信息的存储占用的空间更小,访问速度更快,采取了一些特殊的技巧,然 而在看 Lucene 文件格式的时候,这些技巧却容易使我们感到困惑,所以有必要把这些特殊 的技巧规则提取出来介绍一下。 在下不才,胡乱给这些规则起了一些名字,是为了方便后面应用这些规则的时候能够简单, 不妥之处请大家谅解。
1. 前缀后缀规则(Prefix+Suffix)
Lucene 在反向索引中,要保存词典(Term Dictionary)的信息,所有的词(Term)在词典中是按照 39
字典顺序进行排列的,然而词典中包 了文档中的几乎所有的词,并且有的词还是非常的长 的,这样索引文件会非常的大,所谓前缀后缀规则,即当某个词和前一个词有共同的前缀的 时候,后面的词仅仅保存前缀在词中的偏移(offset),以及除前缀以外的字符串(称为后缀)。
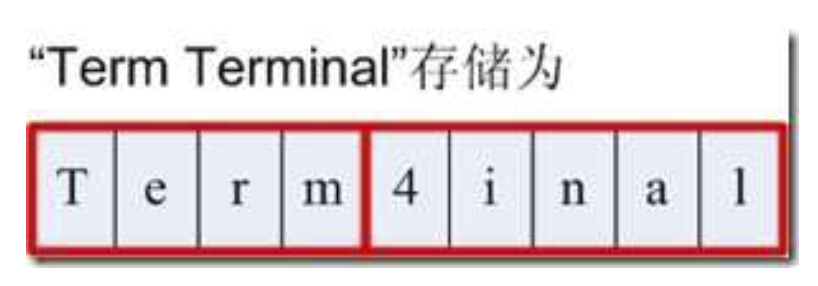
比如要存储如下词:term,termagancy,termagant,terminal, 如果按照正常方式来存储,需要的空间如下:
[VInt = 4] [t][e][r][m],[VInt = 10][t][e][r][m][a][g][a][n][c][y],[VInt = 9][t][e][r][m][a][g][a][n][t], [VInt = 8][t][e][r][m][i][n][a][l]
共需要 35 个 Byte.
如果应用前缀后缀规则,需要的空间如下:
[VInt = 4] [t][e][r][m],[VInt = 4 (offset)][VInt = 6][a][g][a][n][c][y],[VInt = 8 (offset)][VInt = 1][t],
[VInt = 4(offset)][VInt = 4][i][n][a][l]
共需要 22 个 Byte。
大大缩小了存储空间,尤其是在按字典顺序排序的情况下,前缀的重合率大大提高。
2. 差值规则(Delta)
在 Lucene 的反向索引中,需要保存很多整型数字的信息,比如文档 ID 号,比如词(Term)在 文档中的位置等等。
由上面介绍,我们知道,整型数字是以 VInt 的格式存储的。随着数值的增大,每个数字占
用的 Byte 的个数也逐渐的增多。所谓差值规则(Delta)就是先后保存两个整数的时候,后面
的整数仅仅保存和前面整数的差即可。
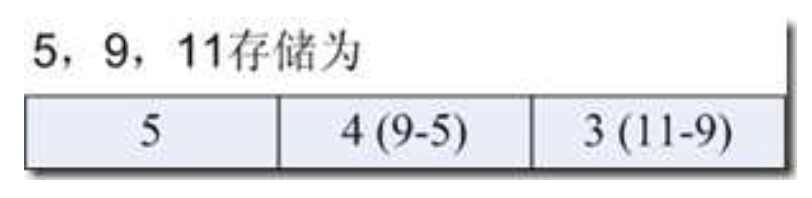
比如要存储如下整数:16386,16387,16388,16389
如果按照正常方式来存储,需要的空间如下:
[(1) 000, 0010][(1) 000, 0000][(0) 000, 0001],[(1) 000, 0011][(1) 000, 0000][(0) 000, 0001],[(1)
000, 0100][(1) 000, 0000][(0) 000, 0001],[(1) 000, 0101][(1) 000, 0000][(0) 000, 0001]
供需 12 个 Byte。
如果应用差值规则来存储,需要的空间如下:
[(1) 000, 0010][(1) 000, 0000][(0) 000, 0001],[(0) 000, 0001],[(0) 000, 0001],[(0) 000, 0001]
共需 6 个 Byte。
大大缩小了存储空间,而且无论是文档 ID,还是词在文档中的位置,都是按从小到大的顺
序,逐渐增大的。
3. 或然跟随规则(A,B?)
Lucene 基础数据压缩处理的更多相关文章
- Lucene基础(2)
上一篇:Lucene基础(1) 一.Lucene术语 Document, Field, Term, Query, Analyzer相信在其中大多数在之前已经理解了...对其中部分概念详细说明 Docu ...
- Lucene基础(1)
下一篇: Lucene基础(2) 一.Lucene介绍 http://www.kailing.pub/index/columns/colid/16.html Documentation:http:// ...
- [全文检索]Lucene基础入门.
本打算直接来学习Solr, 现在先把Lucene的只是捋一遍. 本文内容: 1. 搜索引擎的发展史 2. Lucene入门 3. Lucene的API详解 4. 索引调优 5. Lucene搜索结果排 ...
- Lucene基础学习笔记
在学校和老师一起做项目,在老师的推荐下深入学习了一些SqlServer的知识,看一些书下来哎也没记住多少,不过带来了新疑问. 不使用模糊查询,我应该用什么呢?如何能不影响数据库性能,还能做模糊查询呢? ...
- JAVAEE——Lucene基础:什么是全文检索、Lucene实现全文检索的流程、配置开发环境、索引库创建与管理
1. 学习计划 第一天:Lucene的基础知识 1.案例分析:什么是全文检索,如何实现全文检索 2.Lucene实现全文检索的流程 a) 创建索引 b) 查询索引 3.配置开发环境 4.创建索引库 5 ...
- 01 lucene基础 北风网项目培训 Lucene实践课程 系统架构
Lucene在搜索的时候数据源可以是文件系统,数据库,web等等. Lucene的搜索是基于索引,Lucene是基于前面建立的索引之上进行搜索的. 使用Lucene就像使用普通的数据库一样. Luce ...
- lucene 基础知识点
部分知识点的梳理,参考<lucene实战>及网络资料 1.基本概念 lucence 可以认为分为两大组件: 1)索引组件 a.内容获取:即将原始的内容材料,可以是数据库.网站(爬虫).文本 ...
- Lucene基础(一)--入门
Lucene介绍 lucene的介绍,这里引用百度百科的介绍Lucene是apache软件基金会4 jakarta项目组的一个子项目,是一个开放源代码的全文检索引擎工具包,即它不是一个完整的全文检索引 ...
- Lucene基础(二)--索引的操作
索引的操作 我们建立所有就是要达到快速检索的目的,对数据能够方面便的查找,和数据库类似,索引也有自己的相关增删改查的操作. 在索引的增删改查中,增删改属于写操作,主要是有IndexWrite提供的方法 ...
随机推荐
- 【机器学习与R语言】4-决策树
目录 1.决策树原理 2.决策树应用示例 2.1)收集数据 2.2)探索和准备数据 2.3)训练模型 2.4)评估模型性能 2.5)提高模型性能 通过自适应增强算法(boosting) 将惩罚因子分配 ...
- 【Python小试】统计一条核酸序列中频数非0或为2的双核苷酸
概念 双核苷酸由任意2个碱基组成 测试1 dna = "AATGATGAACGAC" #一一列举 dinucleotides = ['AA','AT','AG','AC', 'TA ...
- Linux服务器I/O性能分析-1
一.IOSTAT误区 1.1 误区-svctm Linux上的svctm是重要的I/O指标(I/O平均服务时间-单位毫秒),这个值直接反映了硬件的性能(I/O请求从SCSI层发出--->I/O完 ...
- Python基础之格式化输出的三种方式
目录 1. 格式化输出的三种方式 1.1 占位符 1.2 format格式化 1.3 f-string格式化 1. 格式化输出的三种方式 在程序中,需要将输出信息打印成固定的格式,这时候就需要格式化输 ...
- Oracle-除了会排序,你对ORDER BY的用法可能一无所知!
导读 为什么只有ORDER BY后面可以使用列别名 为什么不推荐使用ORDER BY后接数字来排序 为什么视图和子查询里面不能使用ORDER BY -- 小伙伴们在进行SQL排序时,都能很自然的使用 ...
- A Child's History of England.20
CHAPTER 7 ENGLAND UNDER HAROLD THE SECOND, AND CONQUERED BY THE NORMANS Harold was crowned King of E ...
- Shell学习(九)——chattr与lsattr命令详解
有时候你发现用root权限都不能修改某个文件,大部分原因是曾经用chattr命令锁定该文件了.chattr命令的作用很大,其中一些功能是由Linux内核版本来支持的,不过现在生产绝大部分跑的linux ...
- 生成接口文档并同步到postman
前言 当我们开发需要测试接口时,会遇到以下几个问题 1.如果接口过多,参数过多,一个个参数复制到postman简直能要了我的狗命,重复劳动过多. 2.如果接口过多,参数过多,编写接口文档给测试人员或者 ...
- 转 GSON
转 https://www.jianshu.com/p/75a50aa0cad1 GSON弥补了JSON的许多不足的地方,在实际应用中更加适用于Java开发.在这里,我们主要讲解的是利用GSON来操作 ...
- MySQL(2):数据管理
一. 外键概念: 如果公共关键字在一个关系中是主关键字,那么这个公共关键字被称为另一个关系的外键.由此可见,外键表示了两个关系之间的相关联系.以另一个关系的外键作主关键字的表被称为主表,具有此外键的表 ...