
统计学习:逻辑回归与交叉熵损失(Pytorch实现)
1. Logistic 分布和对率回归
监督学习的模型可以是概率模型或非概率模型,由条件概率分布\(P(Y|\bm{X})\)或决 策函数(decision function)\(Y=f(\bm{X})\)表示,随具体学习方法而定。对具体的输入\(\bm{x}\)进行相应的输出预测并得到某个结果时,写作\(P(y|\bm{x})\)或\(y=f(\bm{x})\)。
我们这里的 Logistic 分类模型是概率模型,模型\(P(Y|\bm{X})\)表示给定随机向量\(\bm{X}\)下,分类标签\(Y\)的条件概率分布。这里我们只讨论二分类问题。后面我们介绍多层感知机的时候会介绍多分类问题。道理是一样的。
先介绍 Logistic 分布。
Logistic 的分布函数为:
\]
该分布函数的图像为:
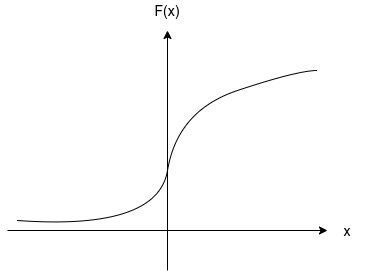
该函数以点\((u,1/2)\)中心对称,在中心附近增长速度较快,在两端增长速度较慢。
我们后面对于未归一化的数\(z\),采用\(\text{sigmoid}\)函数
\]
将其“压”在(0, 1)之间。这样就可以使\(z\)归一化,一般我们使归一化后的值表示置信度(belief),可以理解成概率,但是与概率有着细微的差别,更体现 “属于××类的把握”的意思。
对于二分类,标签\(Y=0\)或\(Y=1\),我们将\(P(Y=0|\bm{X}=\bm{x})\)和\(P(Y=1|\bm{X}=\bm{x})\)表示如下,也就定义了二项逻辑回归模型:
P(Y=1|\bm{X}=\bm{x}) &= \sigma(\bm{w}^T\bm{x}+b) \\
&= \frac{1}{1+\text{exp}(-(\bm{w}^T\bm{x}+b))}
\end{aligned}\space (1)
\\
\begin{aligned}
P(Y=0|\bm{X}=\bm{x}) &= 1-\sigma(\bm{w}^T\bm{x}+b) \\
&= \frac{1}{1+\text{exp}(\bm{w}^T\bm{x}+b)}
\end{aligned} \qquad (2)
\]
现在考察 Logistic 回归模型的特点,一个事件的几率(odds)是指该事件发生的概率与不发生的概率的比值。如果事件发生的概率是\(p\),那么该事件的几率是\(p/(1-p)\),该事件的对数几率(log odds,简称对率)或 logit 函数是
\]
对 Logistic 回归而言,由式子\((1)\)和式子\((2)\)得到:
\]
这玩意在统计学里面称之为“对率回归”,其实就是“Logistic regression 名称”的由来。这里的 Logistic 和“逻辑”没有任何关系,和对率才是有关系的。 可以看出,输出\(Y=1\)的对数几率是由输入\(\bm{x}\)的线性函数表示的模型,即 Logistic 回归模型。
2. Logistic 回归模型的参数估计
我们在《统计推断:极大似然估计、贝叶斯估计与方差偏差分解》)中说过,从概率模型的视角来看,机器模型学习的过程就是概率分布参数估计的过程,这里就是估计条件概率分布\(P(Y|\bm{X})\)的参数\(\bm{θ}\)。对于给定的训练数据集\(T=\{\{\bm{x}_1, y_1\},\{\bm{x}_2, y_2\}, \dots, \{\bm{x}_N, y_N\}\}\),其中,\(\bm{x}_i∈\mathbb{R}^n\),\(y_i∈\{0, 1\}\),可以应用极大似然估计法估计模型参数,从而得到Logistic回归模型。
我们设\(P(Y=1|x)=π(\bm{x})\),\(P(Y=0|\bm{x})=1-π(\bm{x})\),很显然\(P(Y|\bm{x})\)服从一个伯努利分 布,不过这个伯努利分布很复杂,它的参数\(p\)是一个函数\(π(\bm{x})\)。我们这里采用一个抽象的观念,将函数\(π(\bm{x})\)看做一个整体,这样\(P(Y|\bm{x})\)服从二项分布,可以方便我们理解。我们的参数\(\bm{θ}=(w, b)\),不过我们还是采用之前的技巧,将权值向量和输入向量加以扩充,直接记做\(\bm{θ}=\bm{w}\)。
这样,对于\(N\)个样本,定义似然函数:
\]
因为函数比较复杂,我们采用数值优化进行求解。然而这个函数是非凸的, 如果直接用数值迭代算法作用于次函数,可能陷入局部最优解不能保证到收敛到全局最优解。我们为了将其变为负对数似然函数(想一想为什么要取负号),也就是一个凸函数,方便用梯度下降法、牛顿法进行求解:
- \sum_{i=1}^N[y_i\text{log}\space \pi(\bm{x}_i)+(1-y_i)\text{log}(1-\pi(\bm{x}_i))]
\]
配凑 \(1/N\)转换为关于数据经验分布期望的无偏估计 ,即\(\mathbb{E}_{\bm{x}\sim \hat{p}_{data}}\text{log}\space p_{model}(\bm{x}_i| \bm{\theta})\)而不改变目标函数的优化方向。
\]
上面这个式子,就是我们在深度学习里面常用的交叉熵损失函数(cross entropy loss function)的特殊情况。(交叉熵损失函数一般是多分类,这里是二分类)。后面我们会学习,在深度学习领域中,我们用\(f(\cdot)\)表示神经网络对输入\(\bm{x}\)加以的 映射(这里没有激活函数,是线性的映射),\(f(\bm{x})\)就是输出的条件概率分布\(P(Y|\bm{X}=\bm{x})\)。 设类别总数为\(K\),\(\bm{x}_i\)为第\(i\)个样本的特征向量(特征维度为\(D\)),\(f(\bm{x}_i)\)输出维度也为\(K\)。\(f(\bm{x}_i)_k\)表示\(P(y_k | \bm{x}_i)\)。因为是多分类,\(P(y_k | \bm{x}_i)\)的计算方法就不能通过\(\text{sigmoid}\)函数来得到了,取而代之是更通用的\(\text{softmax}\)函数。我们给定输入样本\(\bm{x}\),设\(z_k=\sum_{j=1}^Dw_{zj}x_{j}\),其中\(\textbf{W} ∈\mathbb{R}^{K\times D}\)神经网络的权重矩阵\(D\)为特征向量维度,\(K\)为类别总数。则我们有:
\]
我们规定第\(i\)个样本的标签\(\bm{y}_i\)为\(K\)维one-hot向量。则交叉熵函数表述如下:
\]
因为\(\bm{y}_i\)为 one-hot 向量,只有一个维度为 1,设这个维度为\(c\)(即表示类别\(c\)),则交叉熵函数可以化简为:
\]
很明显,如果\(f(\bm{x}_i)_c\)越大,表示神经网络预测\(\bm{x}_i\)样本类别为第\(c\)类的概率越大,这也是目标函数优化的方向——即对于类别为\(c\)的样本\(\bm{x}_i\),优化器尽量使样本\(\bm{x}_i\)被预测为第\(c\)类的概率更大。
如下为使用梯度下降法求解二分类逻辑回归问题:
import numpy as np

import random

import torch

# batch_size表示单批次用于参数估计的样本个数

# y_pred大小为(batch_size, 1)

# y大小为(batch_size, ),为类别型变量

def cross_entropy(y_pred, y):

    # 这里y是创建新的对象,这里将y变为(batch_size. 1)形式

    y = y.reshape(-1, 1)

    return -(y*torch.log(y_pred) + (1-y)*torch.log(1-y_pred)).sum()/y_pred.shape[0]

# 前向函数

def logistic_f(X, w):

    z = torch.matmul(X, w).reshape(-1, 1)

    return 1/(1+torch.exp(-z))

# 之前实现的梯度下降法,做了一些小修改

def gradient_descent(X, w, y, n_iter, eta, loss_func, f):

    # 初始化计算图参数,注意:这里是创建新对象,非参数引用

    w = torch.tensor(w, requires_grad=True)

    X = torch.tensor(X)

    y = torch.tensor(y)

    for i in range(1, n_iter+1):

        y_pred = f(X, w)

        loss_v = loss_func(y_pred, y)

        loss_v.backward()

        with torch.no_grad():

            w -= eta*w.grad

        w.grad.zero_()

    w_star = w.detach().numpy()

    return w_star

# 本模型按照二分类架构设计

def LR(X, y, n_iter=200, eta=0.001, loss_func=cross_entropy, optimizer=gradient_descent):

    # 初始化模型参数

    # 我们使W和b融合,X后面添加一维

    X = np.concatenate([X, np.ones([X.shape[0], 1])], axis=1)

    w = np.zeros(X.shape[1], dtype=np.float64)

    # 调用梯度下降法对函数进行优化

    # 这里采用单次迭代对所有样本进行估计,后面我们会介绍小批量法减少时间复杂度

    w_star = optimizer(X, w, y, n_iter, eta, loss_func, logistic_f)

    return w_star

if __name__ == '__main__':

    # 数据矩阵,一共4个样本,每个样本特征维度为3

    X = np.array([

        [1, 5, 3],

        [4, 5, 6],

        [7, 1, 9],

        [10, 1, 12]

    ], dtype=np.float64)

    # 标签向量,注意要从0开始编码

    y = np.array([1, 1, 0, 0], dtype=np.int64)

    # 迭代次数

    n_iter = 200

    # 学习率

    eta = 0.001

    w = LR(X, y, n_iter, eta, cross_entropy, gradient_descent)

    # 学得的权重,最后一维是偏置b

    print(w)
最终学得的权重向量为(最后一维为偏置\(b\)):
[-0.10717712 0.20524747 -0.06932763 0.01892475]
如下是多分类逻辑回归问题,我们需要将\(\text{sigmoid}\)函数修改为\(\text{softmax}\)函数,损失函数修改为更为通用的交叉熵函数,根据输出维度变化将权重向量修改为权重矩阵等。
import numpy as np

import random

import torch

# batch_size表示单批次用于参数估计的样本个数

# n_feature为特征向量维度

# n_class为类别个数

# y_pred大小为(batch_size, n_class)

# y大小为(batch_size, ),为类别型变量

def cross_entropy(y_pred, y):

    # 这里y是创建新的对象,这里将y变为(batch_size. 1)形式

    y = y.reshape(-1, 1)

    return -torch.log(torch.gather(y_pred, 1, y)).sum()/ y_pred.shape[0]

# 前向函数,注意,这里的sigmoid改为多分类的softmax函数

def logistic_f(X, W):

    z = torch.matmul(X, W)

    return torch.exp(z)/torch.exp(z).sum()

# 之前实现的梯度下降法,做了一些小修改

def gradient_descent(X, W, y, n_iter, eta, loss_func, f):

    # 初始化计算图参数,注意:这里是创建新对象,非参数引用

    W = torch.tensor(W, requires_grad=True)

    X = torch.tensor(X)

    y = torch.tensor(y)

    for i in range(1, n_iter+1):

        y_pred = f(X, W)

        loss_v = loss_func(y_pred, y)

        loss_v.backward()

        with torch.no_grad():

            W -= eta*W.grad

        W.grad.zero_()

    W_star = W.detach().numpy()

    return W_star

# 本模型按照多分类架构设计

def LR(X, y, n_iter=200, eta=0.001, loss_func=cross_entropy, optimizer=gradient_descent, n_class=2):

    # 初始化模型参数

    # 我们使W和b融合,X后面添加一维

    X = np.concatenate([X, np.ones([X.shape[0], 1])], axis=1)

    W = np.zeros((X.shape[1], n_class), dtype=np.float64)

    # 调用梯度下降法对函数进行优化

    # 这里采用单次迭代对所有样本进行估计,后面我们在深度学习专栏中会介绍小批量法

    W_star = optimizer(X, W, y, n_iter, eta, loss_func, logistic_f)

    return W_star

if __name__ == '__main__':

    X = np.array([

        [1, 5, 3],

        [4, 5, 6],

        [7, 1, 9],

        [10, 1, 12]

    ], dtype=np.float64)

    # 标签向量,注意要从0开始编码

    y = np.array([1, 2, 0, 0], dtype=np.int64)

    # 迭代次数

    n_iter = 200

    # 学习率

    eta = 0.001

    # 分类类别数

    n_class = 3

    W = LR(X, y, n_iter, eta, cross_entropy, gradient_descent, n_class)

    # 学得的权重矩阵,最后一行是偏置向量

    print(W)
最终学得的权重为(同样,最后一行为偏置向量\(\bm{b}\)。因为是多分类,每一个类别维度\(k\)都会对应一个偏置\(b_k\)):
[[ 0.07124357 -0.10592994 -0.03893547]

 [-0.13648944  0.10387124  0.07448013]

 [ 0.04985565 -0.08291154 -0.04056595]

 [-0.01069396  0.0115092  -0.00081524]]
统计学习:逻辑回归与交叉熵损失(Pytorch实现)的更多相关文章
- 【深度学习】softmax回归——原理、one-hot编码、结构和运算、交叉熵损失
1. softmax回归是分类问题 回归(Regression)是用于预测某个值为"多少"的问题,如房屋的价格.患者住院的天数等. 分类(Classification)不是问&qu ...
- DL基础补全计划(二)---Softmax回归及示例(Pytorch,交叉熵损失)
PS:要转载请注明出处,本人版权所有. PS: 这个只是基于<我自己>的理解, 如果和你的原则及想法相冲突,请谅解,勿喷. 前置说明 本文作为本人csdn blog的主站的备份.(Bl ...
- Hinge Loss、交叉熵损失、平方损失、指数损失、对数损失、0-1损失、绝对值损失
损失函数(Loss function)是用来估量你模型的预测值 f(x) 与真实值 Y 的不一致程度,它是一个非负实值函数,通常用 L(Y,f(x)) 来表示.损失函数越小,模型的鲁棒性就越好. 损失 ...
- 从交叉熵损失到Facal Loss
1交叉熵损失函数的由来1.1关于熵,交叉熵,相对熵(KL散度) 熵:香农信息量的期望.变量的不确定性越大,熵也就越大,把它搞清楚所需要的信息量也就越大.其计算公式如下: 其是一个期望的计算,也是记录随 ...
- 深度学习原理与框架-Tensorflow卷积神经网络-卷积神经网络mnist分类 1.tf.nn.conv2d(卷积操作) 2.tf.nn.max_pool(最大池化操作) 3.tf.nn.dropout(执行dropout操作) 4.tf.nn.softmax_cross_entropy_with_logits(交叉熵损失) 5.tf.truncated_normal(两个标准差内的正态分布)
1. tf.nn.conv2d(x, w, strides=[1, 1, 1, 1], padding='SAME') # 对数据进行卷积操作 参数说明:x表示输入数据,w表示卷积核, stride ...
- 【python实现卷积神经网络】损失函数的定义(均方误差损失、交叉熵损失)
代码来源:https://github.com/eriklindernoren/ML-From-Scratch 卷积神经网络中卷积层Conv2D(带stride.padding)的具体实现:https ...
- pytorch 中交叉熵损失实现方法
- 分布式机器学习:逻辑回归的并行化实现(PySpark)
1. 梯度计算式导出 我们在博客<统计学习:逻辑回归与交叉熵损失(Pytorch实现)>中提到,设\(w\)为权值(最后一维为偏置),样本总数为\(N\),\(\{(x_i, y_i)\} ...
- 线性模型之逻辑回归(LR)(原理、公式推导、模型对比、常见面试点)
参考资料(要是对于本文的理解不够透彻,必须将以下博客认知阅读,方可全面了解LR): (1).https://zhuanlan.zhihu.com/p/74874291 (2).逻辑回归与交叉熵 (3) ...
随机推荐
- .NET C#教程初级篇 1-1 基本数据类型及其存储方式
.NET C# 教程初级篇 1-1 基本数据类型及其存储方式 全文目录 (博客园).NET Core Guide (Github).NET Core Guide 本节内容是对于C#基础类型的存储方式以 ...
- 使用uiautomatorviewer,查看app页面元素,进行元素定位
环境搭建: 安装adt,安装成功后,就可以在adt路径下的tools文件夹中找到uiautomatorviewer.bat 用来做什么? uiautomatorviewer.bat是用来扫描和分析An ...
- Kubernetes 部署 Kubernetes-Dashboard v2.0.0 尝鲜
目录· . 一.简介· . 二.兼容性· . 三.部署 Kubernetes Dashboard· . 1.Dashboard RBAC· . 2.创建 ConfigMap.Secret· . 3.k ...
- tomcat 服务器的几个重要监听 方法 与 使用
1. 总结一下tomcat 服务器里的三种监听 ServletContextListener HttpSessionListener ServletRequestListener 这是我要做的三个自定 ...
- 用户注册调优 及Connection对象
调优的方法: (1)减少Connection对象的销毁与创建 我们可以在服务器启动时 预先创建好二十个Connection对象 因为每次Coonection对象的创建与销毁会浪费大量的时间 我们需要 ...
- 一站式搭建 GitHub Pages 博客 (一)
本文将详细讲解如何快速搭建 GitHub Pages 博客页面 关于博客主题,博客信息更改,上传文章等将会在 一站式搭建 GitHub Pages 博客 (二) 中进行详细讲解 准备阶段 注册 Git ...
- 深入理解Java虚拟机之Java内存区域与内存溢出异常
Java内存区域与内存溢出异常 运行时数据区域 程序计数器 用于记录从内存执行的下一条指令的地址,线程私有的一小块内存,也是唯一不会报出OOM异常的区域 Java虚拟机栈 Java虚拟机栈(Java ...
- 还在用visio?这款画图工具才是真的绝!
最近有读者私信我,问我推文的配图是用什么工具画的,很好看,也想学习一下.今天就给大家介绍一下这款画图工具--Draw.io 概述 draw.io是一款免费的网页版画图工具(也有桌面版),支持流程图.U ...
- 白话TCP/IP原理
TCP/IP(Transmission-Control-Protocol/Internet-Protocol),中文译名为传输控制协议/因特网互联协议,又名网络通讯协议,是Internet最基本的协议 ...
- Vue 动态设置图片路径
大多数情况vue项目中组件是需要相互引用的,父组件引用子组件,子组件引用父组件,已达到组件重用的目的 本次记录的是父组件引用子组件,img标签定义在多个子组件中,不同或相同的父组件引用同一个子 ...