
hdfs文件导入到hive(带资源)
前言
hive是基于Hadoop的一个数据仓库工具,用来进行数据提取、转化、加载,这是一种可以存储、查询和分析存储在Hadoop中的大规模数据的机制。hive数据仓库工具能将结构化的数据文件映射为一张数据库表,并提供SQL查询功能,能将SQL语句转变成MapReduce任务来执行,下面来介绍如何将结构化文档数据导入hive。
一、安装Hive
1.1 官网下载或到本章最后地址下载hive 安装包
/opt/software 下新建hive 目录 并将安装包解压至此
tar -xzvf /opt/software/apache-hive-3.1.2-bin.tar.gz -C /opt/software/hive
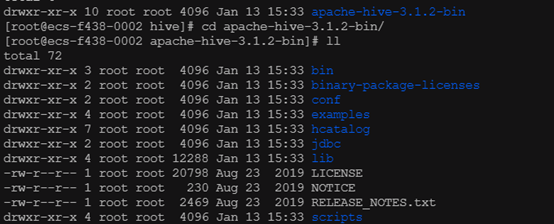
解压后的 hive 目录结构如下
1.2 添加环境变量
vim /etc/profile
文件末尾加上下面两行 分别为hive安装路径和引用
export HIVE_HOME=/usr/local/hive/apache-hive-3.1.2-bin

export PATH=$PATH:$HIVE_HOME/bin
使文件立即生效
source /etc/profile
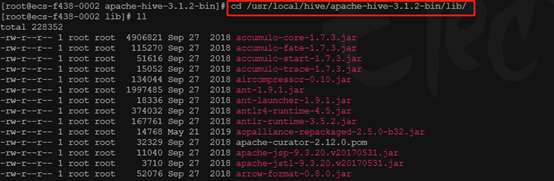
1.3 进入hive 的jar包目录lib文件夹下
cd /usr/local/hive/apache-hive-3.1.2-bin/lib/
1.3.1 解决 log4j jar 包冲突
mv log4j-slf4j-impl-2.10.0.jar log4j-slf4j-impl-2.10.0.jar.bak
1.3.2 hive de guava-xx.jar 的guava-xx.jar 和hadoop的guava-xx.jar 包冲突,需要同步高版本jar,并删除低版本jar(两个jar包分别在/opt/hive/lib/ 以及 /opt/hadoop/share/hadoop/common/lib/)
1.3.3 添加mysql 驱动到hive 的 lib下(略)
1.4 修改配置文件
进入到hive安装目录conf下执行
mv hive-env.sh.template hive-env.sh
1.4.1 编辑hive-env.sh 配置hive_home
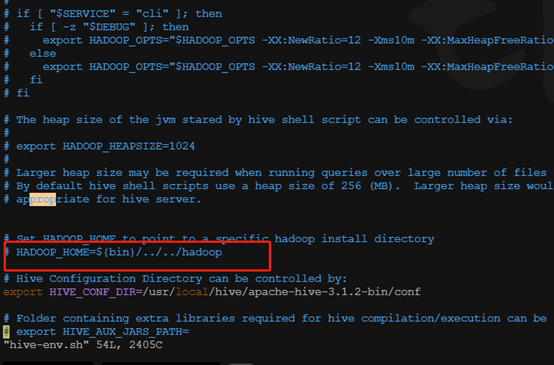
这里注意,如果hadoop和hive 不是安装在同一台机器上,会报错找不到hadoop_home,网上暂时没有找到好方案,暂时只能装在一起,所以这里不用配置
1.4.2 conf文件夹下配置hive-site.xml (如果无该文件,请自行创建 touch hive-site.xml)
<configuration>

<property>
<name>hive.server2.active.passive.ha.enable</name>
<value>true</value>

</property>

<!-- hive的相关HDFS存储路径配置 -->

 <property>

    <name>hive.exec.scratchdir</name>

    <value>/tmp/hive</value>

</property>

<property>

    <name>hive.metastore.warehouse.dir</name>

    <value>/user/hive/warehouse</value>

</property>

<property>

    <name>hive.metastore.schema.verification</name>

    <value>false</value>

</property>

<property>

    <name>hive.querylog.location</name>

    <value>/user/hive/log</value>

</property>

<!-- 以下是mysql相关配置 地址端口自行更改 -->

<property>

    <name>javax.jdo.option.ConnectionURL</name>

    <value>jdbc:mysql://ip:port/testhive?createDatabaseIfNotExist=true&characterEncoding=UTF-8&useSSL=false</value>

  </property>

  <property>

    <name>javax.jdo.option.ConnectionDriverName</name>

    <value>com.mysql.jdbc.Driver</value>

  </property>


  <property>

    <name>javax.jdo.option.ConnectionUserName</name>

    <value>userName</value>

  </property>

  <property>

    <name>javax.jdo.option.ConnectionPassword</name>

    <value>PASSWORD</value>

</property>

<!-- hive UI地址,不配置的话,默认只会在本机可以访问 -->

  <property>

    <name>hive.server2.thrift.bind.host</name>

    <value>0.0.0.0</value>

  </property>

</configuration>
1.5 后台启动hiveserver
nohup $HIVE_HOME/bin/hiveserver2 &

1.6 启动hive 自带client
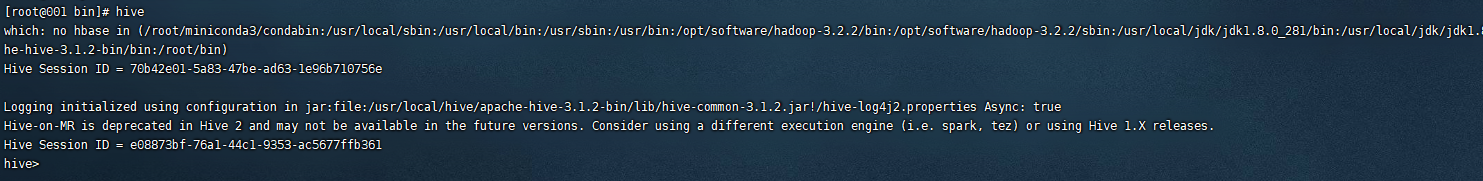
bin/hive
进入hive 客户端
1.7 执行sql测试
hive> create table emp(

      > id int,

      > name string);

hive> insert into emp values(1,"lisi");

hive> select * from emp;

OK

1       lisi

Time taken: 0.395 seconds, Fetched: 1 row(s)
正常!
二 、 将hdfs中的文件导入hive
2.1 新建emp表,指定以空格切分字段,以换行切分数据条数
hive> create table student(

    > id int,

    > name string)

    > row format delimited

    > fields terminated by ' '

    > lines terminated by '\n';
2.2 准备要导入的文件
先找到hdfs文件路径
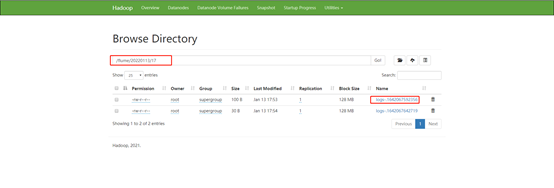
可以在Hadoop(Utilities-Browse the file system)上看到本次要导入的文件路径为 /flume/20220113/13/logs-.1642052912087
2.3 执行导入命令
hive> load data inpath '/flume/20220113/13/logs-.1642052912087' INTO TABLE emp;

Loading data to table default.emp

OK
执行查询emp语句,可以看到数据以成功导入
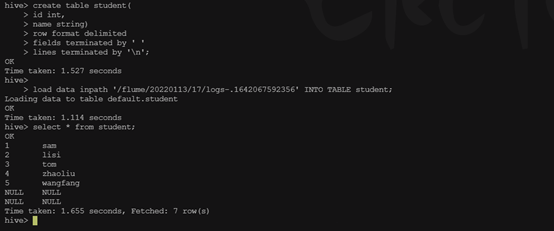
下面为hdfs 源文件(test.log)
1 sam

2 lisi

3 tom

4 zhaoliu

5 wangfang
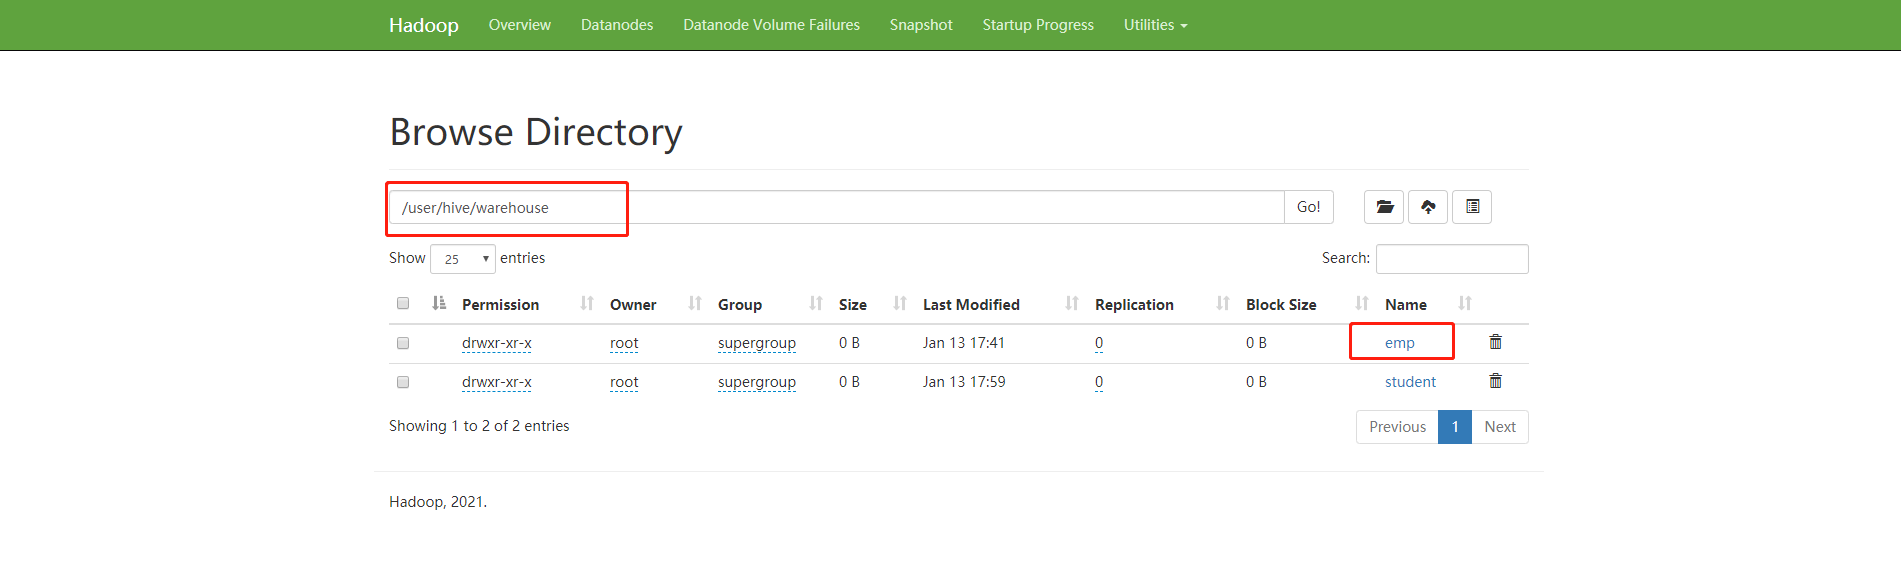
到hadoop 控制台可以看到hive 的表文件
结束!
hive 安装包下载地址
链接:https://pan.baidu.com/s/1CIBq7V6m4yH7TYmI0tacRQ
提取码:6666
hdfs文件导入到hive(带资源)的更多相关文章
- [Spark][Hive]外部文件导入到Hive的例子
外部文件导入到Hive的例子: [training@localhost ~]$ cd ~[training@localhost ~]$ pwd/home/training[training@local ...
- 将CSV格式或者EXCEL格式的文件导入到HIVE数据仓库中
学习内容:数据导入,要求将CSV格式或者EXCEL格式的文件导入到HIVE数据仓库中: ①hive建表:test1 create table test1 (InvoiceNo String, Stoc ...
- 将CSV文件导入到hive数据库
将csv文件导入hive后出现了所有的字段只显示在新建的表的第一个字段中,后面的字段全是null. 出现这种的原因是hive以行分隔数据,需要修改为按逗号' , ‘ 进行分隔读取, 具体操作如下, ...
- Talend 将Oracle中数据导入到hive中,根据系统时间设置hive分区字段
首先,概览下任务图: 流程是,先用tHDFSDelete将hdfs上的文件删除掉,然后将oracle中的机构表中的数据导入到HDFS中:建立hive连接->hive建表->tJava获取系 ...
- 11.把文本文件的数据导入到Hive表中
先在hive里面创建一个表 create table mydb2.t3(id int,name string,age int) row format delimited fields terminat ...
- sqoop命令,mysql导入到hdfs、hbase、hive
1.测试MySQL连接 bin/sqoop list-databases --connect jdbc:mysql://192.168.1.187:3306/trade_dev --username ...
- 第3节 sqoop:4、sqoop的数据导入之导入数据到hdfs和导入数据到hive表
注意: (1)\001 是hive当中默认使用的分隔符,这个玩意儿是一个asc 码值,键盘上面打不出来 (2)linux中一行写不下,可以末尾加上 一些空格和 “ \ ”,换行继续写余下的命令: bi ...
- 如何快速把hdfs数据动态导入到hive表
1. hdfs 文件 {"retCode":1,"retMsg":"Success","data":[{" ...
- HDFS文件和HIVE表的一些操作
1. hadoop fs -ls 可以查看HDFS文件 后面不加目录参数的话,默认当前用户的目录./user/当前用户 $ hadoop fs -ls 16/05/19 10:40:10 WARN ...
随机推荐
- PMP过程组与知识领域
过程组知识领域 启动 规划 执行 监控 结尾 整合管理 制定项目章程 制定项目计划 指导与管理项目工作 监控项目工作 结束项目过程或阶段 项目管理知识 实施整体变更控制 范围管理 规划范围管理 确认范 ...
- 🔥🔥🔥【已开源】Flutter 腾讯优量汇广告插件,帮助开发者获利 - FlutterAds
前言 Flutter 已成为目前最流行的跨平台框架之一,在近期的几个大版本的发布中都提到了 Flutter 版本 Google 广告插件 [google_mobile_ads] .对于"出海 ...
- 2、动态规划接替套路框架——Go语言版
前情提示:Go语言学习者.本文参考https://labuladong.gitee.io/algo,代码自己参考抒写,若有不妥之处,感谢指正 关于golang算法文章,为了便于下载和整理,都已开源放在 ...
- java 8 启动脚本优化
1 #!/bin/bash 2 3 JAVA_HOME=/usr/java/default 4 5 #java虚拟机启动参数 6 JAVA_OPTS="-server -Xms1366m - ...
- JavaScript数组的push()等方法的使用
数组是值得有序集合.每个值在数组中有一个位置,用数字表示,叫做索引.JavaScript数组是无类型的:数组元素可以是任何类型,而且同一个数组中可以存在不同类型元素,甚至可以是对象或是其他数组,这就可 ...
- java 输入输出IO流 IO异常处理try(IO流定义){IO流使用}catch(异常){处理异常}finally{死了都要干}
IO异常处理 之前我们写代码的时候都是直接抛出异常,但是我们试想一下,如果我们打开了一个流,在关闭之前程序抛出了异常,那我们还怎么关闭呢?这个时候我们就要用到异常处理了. try-with-resou ...
- C++ 11 新特性: auto 和 decltype 区别和联系
一. auto简介编程时候常常需要把表达式的值付给变量,需要在声明变量的时候清楚的知道变量是什么类型.然而做到这一点并非那么容易(特别是模板中),有时候根本做不到.为了解决这个问题,C++11新标准就 ...
- props 使用场景 及 布局提升
一对一一边写html 一边写css一小块为单位html csscss html整块单位html csscss html react/first-react/src/views/Wk/index.jsx ...
- jQuery 实现列表自动滚动循环滚动显示新闻通知
需求 页面中一个小区域循环滚动展示通知(公告.新闻.活动.图片等),并且鼠标hover时停止滚动并提示,鼠标离开后,继续滚动. 效果图 https://www.iguopin.com/index.ph ...
- JAVA结合WebSocket实现简单客服聊天功能
说明:该示例只简单的实现了客服聊天功能. 1.聊天记录没有保存到数据库中,一旦服务重启,消息记录将会没有,如果需要保存到数据库中,可以扩展 2.页面样式用的网上模板,样式可以自己进行修改 3.只能由用 ...