
Flink计算pv和uv的通用方法
PV(访问量):即Page View, 即页面浏览量或点击量,用户每次刷新即被计算一次。
UV(独立访客):即Unique Visitor,访问您网站的一台电脑客户端为一个访客。00:00-24:00内相同的客户端只被计算一次。
计算网站App的实时pv和uv,是很常见的统计需求,这里提供通用的计算方法,不同的业务需求只需要小改即可拿来即用。
需求
利用Flink实时统计,从0点到当前的pv、uv。
一、需求分析
从Kafka发送过来的数据含有:时间戳、时间、维度、用户id,需要从不同维度统计从0点到当前时间的pv和uv,第二天0点重新开始计数第二天的。
二、技术方案
Kafka数据可能会有延迟乱序,这里引入watermark;- 通过
keyBy分流进不同的滚动window,每个窗口内计算pv、uv; - 由于需要保存一天的状态,
process里面使用ValueState保存pv、uv; - 使用
BitMap类型ValueState,占内存很小,引入支持bitmap的依赖; - 保存状态需要设置
ttl过期时间,第二天把第一天的过期,避免内存占用过大。
三、数据准备
这里假设是用户订单数据,数据格式如下:
{"time":"2021-10-31 22:00:01","timestamp":"1635228001","product":"苹果手机","uid":255420}

{"time":"2021-10-31 22:00:02","timestamp":"1635228001","product":"MacBook Pro","uid":255421}
四、代码实现
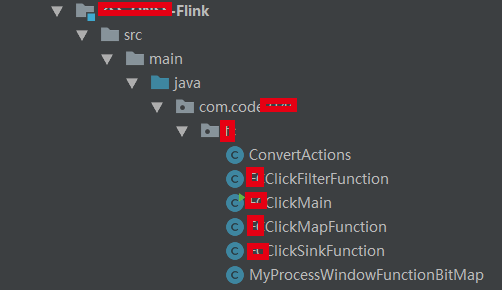
整个工程代码截图如下(抹去了一些不方便公开的信息):
1. 环境
kafka:1.0.0;
Flink:1.11.0;
2. 发送测试数据
首先发送数据到kafka测试集群,maven依赖:
<dependency>

    <groupId>org.apache.kafka</groupId>

    <artifactId>kafka-clients</artifactId>

    <version>2.4.1</version>

</dependency>
发送代码:
import com.alibaba.fastjson.JSON;

import com.alibaba.fastjson.JSONObject;

import jodd.util.ThreadUtil;

import org.apache.commons.lang3.StringUtils;

import org.junit.Test;

import java.io.*;

public class SendDataToKafka {

    @Test

    public void sendData() throws IOException {

        String inpath = "E:\\我的文件\\click.txt";

        String topic = "click_test";

        int cnt = 0;

        String line;

        InputStream inputStream = new FileInputStream(inpath);

        Reader reader = new InputStreamReader(inputStream);

        LineNumberReader lnr = new LineNumberReader(reader);

        while ((line = lnr.readLine()) != null) {

            // 这里的KafkaUtil是个生产者、消费者工具类,可以自行实现

            KafkaUtil.sendDataToKafka(topic, String.valueOf(cnt), line);

            cnt = cnt + 1;

            ThreadUtil.sleep(100);

        }

    }

}
3. 主要程序
先定义个pojo:
@NoArgsConstructor

@AllArgsConstructor

@Data

@ToString

public class UserClickModel {

    private String date;

    private String product;

    private int uid;

    private int pv;

    private int uv;

}
接着就是使用Flink消费kafka,指定Watermark,通过KeyBy分流,进入滚动窗口函数通过状态保存pv和uv。
public class UserClickMain {

    private static final Map<String, String> config = Configuration.initConfig("commons.xml");

    public static void main(String[] args) throws Exception {

        // 初始化环境,配置相关属性

        StreamExecutionEnvironment senv = StreamExecutionEnvironment.getExecutionEnvironment();

        senv.setStreamTimeCharacteristic(TimeCharacteristic.EventTime);

        senv.enableCheckpointing(5000, CheckpointingMode.EXACTLY_ONCE);

        senv.setStateBackend(new FsStateBackend("hdfs://bigdata/flink/checkpoints/userClick"));

        // 读取kafka

        Properties kafkaProps = new Properties();

        kafkaProps.setProperty("bootstrap.servers", config.get("kafka-ipport"));

        kafkaProps.setProperty("group.id", config.get("kafka-groupid"));

        // kafkaProps.setProperty("auto.offset.reset", "earliest");

        // watrmark 允许数据延迟时间

        long maxOutOfOrderness = 5 * 1000L;

        SingleOutputStreamOperator<UserClickModel> dataStream = senv.addSource(

                new FlinkKafkaConsumer<>(

                        config.get("kafka-topic"),

                        new SimpleStringSchema(),

                        kafkaProps

                ))

                //设置watermark

                .assignTimestampsAndWatermarks(WatermarkStrategy.<String>forBoundedOutOfOrderness(Duration.ofMillis(maxOutOfOrderness))

                        .withTimestampAssigner((element, recordTimestamp) -> {

                            // 时间戳须为毫秒

                            return Long.valueOf(JSON.parseObject(element).getString("timestamp")) * 1000;

                        })).map(new FCClickMapFunction()).returns(TypeInformation.of(new TypeHint<UserClickModel>() {

                }));

        // 按照 (date, product) 分组

        dataStream.keyBy(new KeySelector<UserClickModel, Tuple2<String, String>>() {

            @Override

            public Tuple2<String, String> getKey(UserClickModel value) throws Exception {

                return Tuple2.of(value.getDate(), value.getProduct());

            }

        })

                // 一天为窗口,指定时间起点比时间戳时间早8个小时

                .window(TumblingEventTimeWindows.of(Time.days(1), Time.hours(-8)))

                // 10s触发一次计算,更新统计结果

                .trigger(ContinuousEventTimeTrigger.of(Time.seconds(10)))

                // 计算pv uv

                .process(new MyProcessWindowFunctionBitMap())

                // 保存结果到mysql

                .addSink(new FCClickSinkFunction());

        senv.execute(UserClickMain.class.getSimpleName());

    }

}
代码都是一些常规代码,但是还是有几点需要注意的。
注意
- 设置watermark,flink1.11中使用WatermarkStrategy,老的已经废弃了;
- 我的数据里面时间戳是秒,需要乘以1000,flink提取时间字段,必须为
毫秒; .window只传入一个参数,表明是滚动窗口,TumblingEventTimeWindows.of(Time.days(1), Time.hours(-8))这里指定了窗口的大小为一天,由于中国北京时间是东8区,比国际时间早8个小时,需要引入offset,可以自行进入该方法源码查看英文注释。
Rather than that,if you are living in somewhere which is not using UTC±00:00 time,

* such as China which is using UTC+08:00,and you want a time window with size of one day,

* and window begins at every 00:00:00 of local time,you may use {@code of(Time.days(1),Time.hours(-8))}.

* The parameter of offset is {@code Time.hours(-8))} since UTC+08:00 is 8 hours earlier than UTC time.
- 一天大小的窗口,根据
watermark机制一天触发计算一次,显然是不合理的,需要用trigger函数指定触发间隔为10s一次,这样我们的pv和uv就是10s更新一次结果。
4. 关键代码,计算uv
由于这里用户id刚好是数字,可以使用bitmap去重,简单原理是:把 user_id 作为 bit 的偏移量 offset,设置为 1 表示有访问,使用 1 MB的空间就可以存放 800 多万用户的一天访问计数情况。
redis是自带bit数据结构的,不过为了尽量少依赖外部存储媒介,这里自己实现bit,引入相应maven依赖即可:
<dependency>

    <groupId>org.roaringbitmap</groupId>

    <artifactId>RoaringBitmap</artifactId>

    <version>0.8.0</version>

</dependency>
计算pv、uv的代码其实都是通用的,可以根据自己的实际业务情况快速修改的:
public class MyProcessWindowFunctionBitMap extends ProcessWindowFunction<UserClickModel, UserClickModel, Tuple<String, String>, TimeWindow> {

    private transient ValueState<Integer> pvState;

    private transient ValueState<Roaring64NavigableMap> bitMapState;

    @Override

    public void open(Configuration parameters) throws Exception {

        super.open(parameters);

        ValueStateDescriptor<Integer> pvStateDescriptor = new ValueStateDescriptor<>("pv", Integer.class);

        ValueStateDescriptor<Roaring64NavigableMap> bitMapStateDescriptor = new ValueStateDescriptor("bitMap"

                , TypeInformation.of(new TypeHint<Roaring64NavigableMap>() {}));

        // 过期状态清除

        StateTtlConfig stateTtlConfig = StateTtlConfig

                .newBuilder(Time.days(1))

                .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)

                .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)

                .build();

        // 开启ttl

        pvStateDescriptor.enableTimeToLive(stateTtlConfig);

        bitMapStateDescriptor.enableTimeToLive(stateTtlConfig);

        pvState = this.getRuntimeContext().getState(pvStateDescriptor);

        bitMapState = this.getRuntimeContext().getState(bitMapStateDescriptor);

    }

    @Override

    public void process(Tuple2<String, String> key, Context context, Iterable<UserClickModel> elements, Collector<UserClickModel> out) throws Exception {

        // 当前状态的pv uv

        Integer pv = pvState.value();

        Roaring64NavigableMap bitMap = bitMapState.value();

        if(bitMap == null){

            bitMap = new Roaring64NavigableMap();

            pv = 0;

        }

        Iterator<UserClickModel> iterator = elements.iterator();

        while (iterator.hasNext()){

            pv = pv + 1;

            int uid = iterator.next().getUid();

            //如果userId可以转成long

            bitMap.add(uid);

        }

        // 更新pv

        pvState.update(pv);

        UserClickModel UserClickModel = new UserClickModel();

        UserClickModel.setDate(key.f0);

        UserClickModel.setProduct(key.f1);

        UserClickModel.setPv(pv);

        UserClickModel.setUv(bitMap.getIntCardinality());

        out.collect(UserClickModel);

    }

}
注意
- 由于计算
uv第二天的时候,就不需要第一天数据了,要及时清理内存中前一天的状态,通过ttl机制过期; - 最终结果保存到mysql里面,如果数据结果分类聚合太多,要注意
mysql压力,这块可以自行优化;
五、其它方法
除了使用bitmap去重外,还可以使用Flink SQL,编码更简洁,还可以借助外面的媒介Redis去重:
- 基于 set
- 基于 bit
- 基于 HyperLogLog
- 基于bloomfilter
具体思路是,计算pv、uv都塞入redis里面,然后再获取值保存统计结果,也是比较常用的。
猜你喜欢
HDFS的快照讲解
Hadoop 数据迁移用法详解
Hbase修复工具Hbck
数仓建模分层理论
一文搞懂Hive的数据存储与压缩
大数据组件重点学习这几个
Flink计算pv和uv的通用方法的更多相关文章
- Flink实时计算pv、uv的几种方法
本文首发于:Java大数据与数据仓库,Flink实时计算pv.uv的几种方法 实时统计pv.uv是再常见不过的大数据统计需求了,前面出过一篇SparkStreaming实时统计pv,uv的案例,这里用 ...
- 按渠道计算 PV 和 UV
按渠道计算 PV 和 UV: ------------------按指定channel_id按月求PV.UV------------ drop table if exists tmp_pvuv; cr ...
- 网站PV、UV以及查看方法
网站PV.UV以及查看方法 一.名词解释 PV:PV 是Page Views的缩写,即页面浏览量,用户每一次对网站中的每个网页访问均被记录一次.注意,访客每刷新一次页面,pv就增加一次. UV:UV是 ...
- 【总结整理】pv、uv
1.pv的全称是page view,译为页面浏览量或点击量,通常是衡量一个网站甚至一条网络新闻的指标.用户每次对网站中的一个页面的请求或访问均被记录1个PV,用户对同一页面的多次访问,pv累计.例如, ...
- Flink统计当日的UV、PV
Flink 统计当日的UV.PV 测试环境: flink 1.7.2 1.数据流程 a.模拟数据生成,发送到kafka(json 格式) b.flink 读取数据,count c. 输出数据到kafk ...
- 聊一聊PV和并发、以及计算web服务器的数量的方法【转】
聊一聊PV和并发.以及计算web服务器的数量的方法 站长之家 2016-08-17 09:40 最近和几个朋友,聊到并发和服务器的压力问题.很多朋友,不知道该怎么去计算并发?部署多少台服务器才合适? ...
- PV和并发、以及计算web服务器的数量的方法
几个概念 网站流量是指网站的访问量,用来描述访问网站的用户数量以及用户所浏览的网页数量等指标,常用的统计指标包括网站的独立用户数量.总用户数量(含重复访问者).网页浏览数量.每个用户的页面浏览数量.用 ...
- 聊一聊PV和并发、以及计算web服务器的数量的方法
聊一聊PV和并发.以及计算web服务器的数量的方法 http://www.chinaz.com/web/2016/0817/567752.shtml 最近和几个朋友,聊到并发和服务器的压力问题.很多朋 ...
- 聊一聊PV和并发、以及计算web服务器的数量的方法(转)
转自:http://www.chinaz.com/web/2016/0817/567752.shtml 最近和几个朋友,聊到并发和服务器的压力问题.很多朋友,不知道该怎么去计算并发?部署多少台服务器才 ...
随机推荐
- axios与vue-resource
在Vue项目中前后端交互时,早期Vue使用Vue-resource实现异步请求.从Vue2.0之后就不再对vue-resource进行更新,Vue官方推荐使用axios. vue-resource V ...
- css3 animate转圈360旋转
.logo{ width:20px; height: 20px; background: red; -webkit-animation:haha1 .8s linear infinite; anima ...
- 手机访问pc网站自动跳转手机端网站PHP代码
$agent = $_SERVER['HTTP_USER_AGENT']; if(strpos($agent,"comFront") strpos($agent,"iPh ...
- Windows系统如何找到占用端口的进程并杀掉
1.先建立用户环境变量:C\WINDOWS/system32 2.输入:cmd,打开命令控制台,然后输入ipconfig 3.再输入:netstat -ano(可以找到所有的进程连接端口及对应PID) ...
- genymotion从本地拖拽apk到模拟器失败,报错“An error occured while deploying the file……”-解决方案
前两篇已经讲过genymotion的安装了,但genymotion构建的安卓模拟器的界面比较简洁,什么软件都没.那么我们进行测试之前,先将需要测试的apk安装到模拟器中,一般来说,直接将apk文件从本 ...
- 安卓模拟器genymotion安装
上一篇已经讲了appium的搭建.那么搭建好后,我们需要测试不同机型,这个时候除了真机外,可以选择安装模拟器.市面上的模拟器有很多:夜神.逍遥.mumu.android emulator.genymo ...
- 鸿蒙内核源码分析(字符设备篇) | 字节为单位读写的设备 | 百篇博客分析OpenHarmony源码 | v67.01
百篇博客系列篇.本篇为: v67.xx 鸿蒙内核源码分析(字符设备篇) | 字节为单位读写的设备 | 51.c.h.o 文件系统相关篇为: v62.xx 鸿蒙内核源码分析(文件概念篇) | 为什么说一 ...
- AT4502-[AGC029C]Lexicographic constraints【二分,栈】
正题 题目链接:https://www.luogu.com.cn/problem/AT4502 题目大意 给出\(n\)个长度\(S\),求一个最小\(m\)表示用大小为\(m\)的字符集构造出\(n ...
- div 可编辑--获取光标位置插入元素
<!DOCTYPE html> <html> <head> <meta http-equiv="Content-Language" ...
- Go语言核心36讲(导读)--学习笔记
目录 开篇词 | 跟着学,你也能成为Go语言高手 导读 | 写给0基础入门的Go语言学习者 导读 | 学习专栏的正确姿势 开篇词 | 跟着学,你也能成为Go语言高手 Go 语言是由 Google 出品 ...