
爬虫--Scrapy-参数等级和请求传参
日志等级
日志等级(种类):

    ERROR:错误

    WARNING:警告

    INFO:一般信息

    DEBUG:调试信息(默认)

指定输入某一中日志信息:

    settings:LOG_LEVEL = ‘ERROR’

将日志信息存储到制定文件中,而并非显示在终端里:

    settings:LOG_FILE = ‘log.txt’

请求传参:爬取的数据值不在同一个页面中。

    需求:将id97电影网站中电影详情数据进行爬取(名称,类型,导演,语言,片长)
如何让终端显示错误信息
在settings.py中配置
# 指定终端输入指定种类日志信息

LOG_LEVEL = 'ERROR'

# 存储到文件

LOG_FILE = 'log.txt'
请求传参
请求传参:爬取的数据值不在同一个页面中。
(id97电影网站)

在电影网站中电影详情数据进行爬取(名称,类型,导演,语言,片长)
创建moviePro工程
scrapy startproject moviePro
cd moviePro
scrapy genspider movie www.id97.com

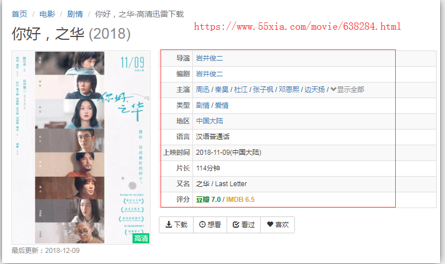
电影名称和类型在一页
电影的其他详情在另外一页
爬虫文件movie.py
import scrapy

from moviePro.items import MovieproItem

class MovieSpider(scrapy.Spider):

    name = 'movie'

    #allowed_domains = ['www.id97.com']

    start_urls = ['https://www.55xia.com/movie']

    print(' start_urls')

    # 用于解析二级页面数据

    def parseBySecondPage(self,response):

        # 直接复制网页端的xpath

        director = response.xpath('/html/body/div[1]/div/div/div[1]/div[1]/div[2]/table/tbody/tr[1]/td[1]/span/text()').extract_first()

        language = response.xpath('/html/body/div[1]/div/div/div[1]/div[1]/div[2]/table/tbody/tr[6]/td[2]/text()').extract_first()

        longTime = response.xpath('/html/body/div[1]/div/div/div[1]/div[1]/div[2]/table/tbody/tr[8]/td[2]/text()').extract_first()

        # 取出Request方法的meta参数传递过来的字典(response.meta)

        item = response.meta['item']

        item['director'] = director

        item['language'] = language

        item['longTime'] = longTime

        # 将item提交给管道

        print('将item提交给管道')

        yield item

    def parse(self, response):

        # 需求:将id97电影网站中电影详情数据进行爬取(名称,类型,导演,语言,片长)

        div_list = response.xpath('/html/body/div[1]/div[1]/div[2]/div')

        for div in div_list:

            # extract_first()第一个

            name = div.xpath(".//div[@class='meta']/h1/a/text()").extract_first()

            kind = div.xpath('.//div[@class="otherinfo"]//text()').extract()

            # 将kind列表转化成字符串

            kind = " ".join(kind)

            url = div.xpath('.//div[@class="meta"]/h1/a/@href').extract_first()

            # href="//www.55xia.com/movie/638284.html

            url = 'https:'+url

            # 创建items对象

            item = MovieproItem()

            item['name'] = name

            item['kind'] = kind

            item['url'] = url

            print('创建items对象')

            # 需要对url发起请求,获取页面数据,进行指定数据解析

            # 问题:如何将剩下的电影详情数据存储到item对象(meta)

            # 需要对url发起请求,获取页面数据,进行指定数据解析

            # meta参数只可以赋值一个字典(将item对象先封装到字典)

            yield scrapy.Request(url=url, callback=self.parseBySecondPage, meta={'item': item})
movie.py
items.py
import scrapy

class MovieproItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    name = scrapy.Field()

    kind = scrapy.Field()

    director = scrapy.Field()

    language = scrapy.Field()

    longTime = scrapy.Field()

    url = scrapy.Field()
管道pipelines.py
class MovieproPipeline(object):

    fp = None

    def open_spider(self, spider):

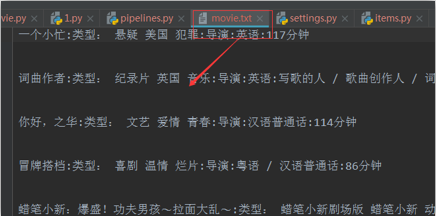
        self.fp = open('movie.txt', 'w', encoding='utf-8')

    def process_item(self, item, spider):

        print('------process_item-------')

        detail = item['name'] + ':' + item['kind'] + ':' + item['director'] + ':' + item['language'] + ':' + item[

            'longTime'] + '\n\n\n'

        self.fp.write(detail)

        return item

    def close_spider(self, spider):

        self.fp.close()
爬虫--Scrapy-参数等级和请求传参的更多相关文章
- Scrapy日志等级以及请求传参
日志等级 请求传参 提高scrapy的爬取效率 日志等级 - 日志信息: 使用命令:scrapy crawl 爬虫文件 运行程序时,在终端输出的就是日志信息: - 日志信息的种类: - ERROR ...
- scrapy框架的日志等级和请求传参, 优化效率
目录 scrapy框架的日志等级和请求传参, 优化效率 Scrapy的日志等级 请求传参 如何提高scripy的爬取效率 scrapy框架的日志等级和请求传参, 优化效率 Scrapy的日志等级 在使 ...
- 爬虫开发10.scrapy框架之日志等级和请求传参
今日概要 日志等级 请求传参 今日详情 一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息. - 日志 ...
- 13.scrapy框架的日志等级和请求传参
今日概要 日志等级 请求传参 如何提高scrapy的爬取效率 今日详情 一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是s ...
- scrapy框架的日志等级和请求传参
日志等级 请求传参 如何提高scrapy的爬取效率 一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息 ...
- scrapy框架之日志等级和请求传参-cookie-代理
一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息. - 日志信息的种类: ERROR : 一般错误 ...
- Scrapy的日志等级和请求传参
日志等级 日志信息: 使用命令:scrapy crawl 爬虫文件 运行程序时,在终端输出的就是日志信息: 日志信息的种类: ERROR:一般错误: WARNING:警告: INFO:一般的信息: ...
- scrapy框架post请求发送,五大核心组件,日志等级,请求传参
一.post请求发送 - 问题:爬虫文件的代码中,我们从来没有手动的对start_urls列表中存储的起始url进行过请求的发送,但是起始url的确是进行了请求的发送,那这是如何实现的呢? - 解答: ...
- Scrapy框架之日志等级和请求传参
一.Scrapy的日志等级 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息. 1.日志等级(信息种类) ERROR:错误 WARN ...
随机推荐
- java学习——异常处理机制
public class ExceptionDemo2 { public static void main(String[] args) { // TODO Auto-generated method ...
- 学习笔记之Data Visualization
Data visualization - Wikipedia https://en.wikipedia.org/wiki/Data_visualization Data visualization o ...
- Zabbix agentd 命令
#zabbix_agentd -p 查看zabbix所有的内置监控项 [root@nod01 zabbix_agentd.d]# zabbix_agentd -pagent.hostname [s|Z ...
- [UE4]碰撞的随机性
物理引擎(包括碰撞)的计算具有随机性 原因: 一.每一帧的时间并不是严格相等 二.浮点数计算不是完全准确(两个浮点数运算,结果不可重复) 影响 在左边窗口(服务器端)打几发子弹把其中3个立方体的位置打 ...
- AndroidStudio快捷键使用记录
输入logt+回车 自动增加Tag的定义. private static final String TAG = "MainActivity"; 输入logd+回车 自动增加d级别的 ...
- 第1课 类型推导(1)_auto关键字
1. auto关键字 (1)auto的作用是让编译器自动推断变量的类型,而不需要显式指定类型.这种隐式类型的推导发生在编译期. (2)auto并不能代表实际的类型声明,只是一个类型声明的“占位符” ...
- CentOS7.4安装部署openstack [Liberty版] (一)
一.OpenStack简介 OpenStack是一个由NASA(美国国家航空航天局)和Rackspace合作研发并发起的,以Apache许可证授权的自由软件和开放源代码项目. OpenStack是一个 ...
- Centos下安装Docker集群管理工具Shipyard
一. Docker Shipyard是什么 ? shipyard是一个开源的docker管理平台,其特性主要包括: 支持镜像管理.容器管理. 支持控制台命令 容器资源消耗监控 支持集群swarm,可以 ...
- Ubuntu17.04下安装vmware虚拟机
linux常用虚拟机一般为KVM,Vmware或者VirtualBox(简称VBox). 下面给大家介绍以下如何在ubuntu17.04版本上安装vmware虚拟机至于虚拟机是用来干啥的,在这里我就不 ...
- MySQL安装,库的操作
一 数据库管理软件的由来 基于我们之前所学,数据要想永久保存,都是保存于文件中,毫无疑问,一个文件仅仅只能存在于某一台机器上. 如果我们暂且忽略直接基于文件来存取数据的效率问题,并且假设程序所有的组件 ...