
python爬取微信公众号
爬取策略
1.需要安装python selenium模块包,通过selenium中的webdriver驱动浏览器获取Cookie的方法、来达到登录的效果
pip3 install selenium
chromedriver:
下载地址:http://chromedriver.storage.googleapis.com/index.html
chromedriver与chrome的对应关系表
http://blog.csdn.net/huilan_same/article/details/51896672
2.微信公众号登陆地址:https://mp.weixin.qq.com/ ,需要在https://mp.weixin.qq.com/注册一个账户用于登录
3.微信公众号文章接口地址可以在微信公众号后台中新建图文消息,超链接功能中获取:
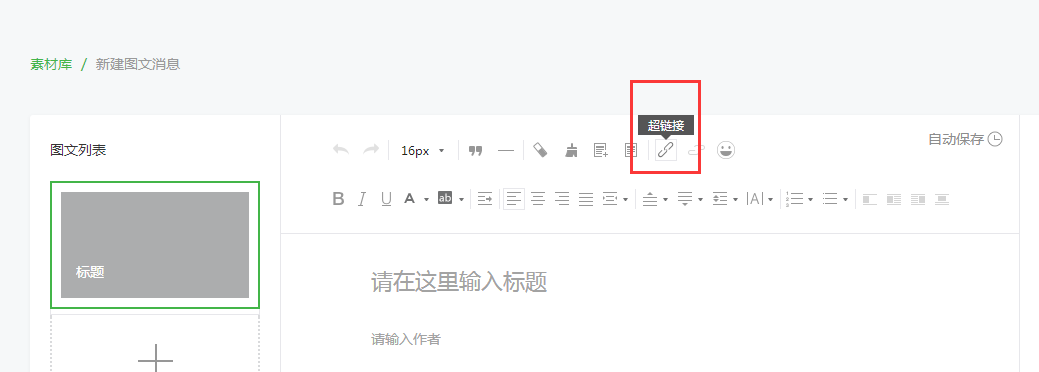

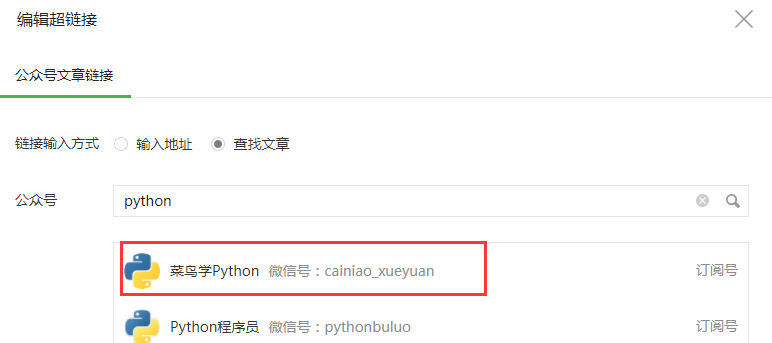
4. 搜索公众号名称

搜索可以获取所有相关的公众号信息,只取第一个做测试
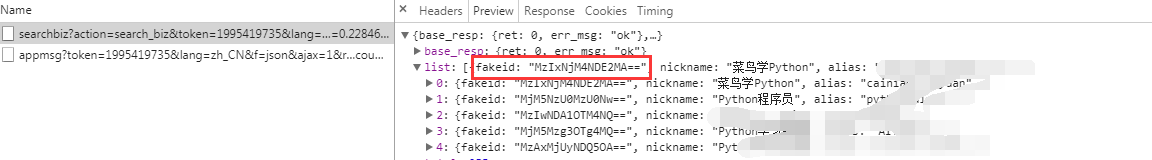
获取要爬取的公众号的fakeid
选定要爬取的公众号,获取文章接口地址
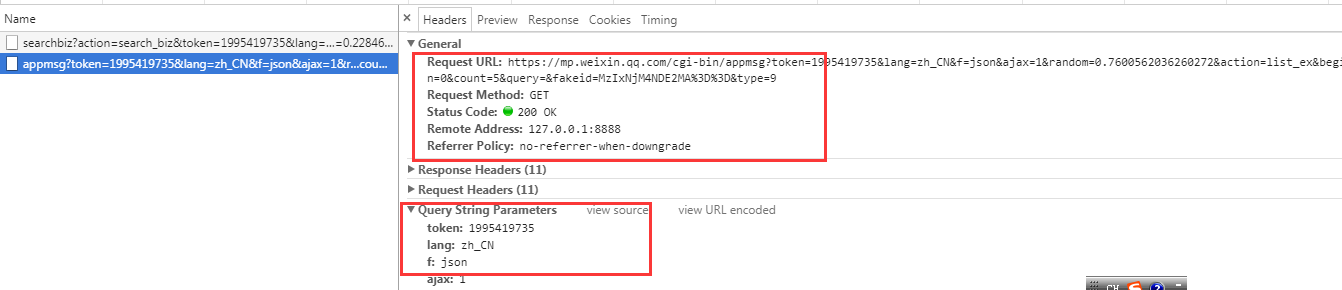
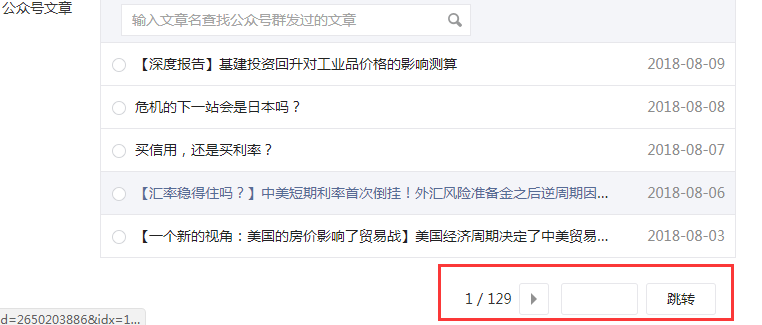
文章列表翻页及内容获取
爬取代码
from selenium import webdriver

import time

import json

import random

import requests

import re

account_name = "xx"

password = "xx"

# 登录微信公众号,获取登录之后的cookies信息,并保存到本地文本中

def wechat_login():

    # 用webdriver启动谷歌浏览器

    print("启动浏览器,打开微信公众号登录界面")

    driver = webdriver.Chrome()

    driver.get("https://mp.weixin.qq.com/")

    time.sleep(2)

    print("正在输入微信公众号登录账号和密码......")

    # 清空账号框中的内容

    driver.find_element_by_name("account").clear()

  driver.find_element_by_name("account").send_keys(account_name)

    time.sleep(1)

    driver.find_element_by_name("password").clear()

    driver.find_element_by_name("password").send_keys(password)

    time.sleep(1)

    # 在自动输完密码之后需要手动点一下记住我

    print("请在登录界面点击:记住账号")

    driver.find_element_by_class_name("frm_checkbox_label").click()

    time.sleep(5)

    # 自动点击登录按钮进行登录

    driver.find_element_by_class_name("btn_login").click()

    # 拿手机扫二维码!

    print("请拿手机扫码二维码登录公众号")

    time.sleep(20)

    print("登录成功")

    cookies = driver.get_cookies()

    # 获取cookies

    cookie_items = driver.get_cookies()

    post = {}

    # 获取到的cookies是列表形式,将cookies转成json形式并存入本地名为cookie的文本中

    for cookie_item in cookie_items:

        post[cookie_item['name']] = cookie_item['value']

    cookie_str = json.dumps(post)

    with open('cookie.txt', 'w+', encoding='utf-8') as f:

        f.write(cookie_str)

    print("cookies信息已保存到本地")

    driver.quit()

# 爬取微信公众号文章,并存在本地文本中

def get_content(query):

    # query为要爬取的公众号名称

    # 公众号主页

    url = 'https://mp.weixin.qq.com'

    # 设置headers

    header = {

        "HOST": "mp.weixin.qq.com",

        "User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"

    }

    from requests.packages import urllib3

    urllib3.disable_warnings()  # 关闭警告

    # 读取上一步获取到的cookies

    with open('cookie.txt', 'r', encoding='utf-8') as f:

        cookie = f.read()

    cookies = json.loads(cookie)

    # 增加重试连接次数

    session = requests.Session()

    session.keep_alive = False

    # 增加重试连接次数

    session.adapters.DEFAULT_RETRIES = 511

    time.sleep(5)

    # 登录之后的微信公众号首页url变化为:https://mp.weixin.qq.com/cgi-bin/home?t=home/index&lang=zh_CN&token=1849751598,从这里获取token信息

    response = session.get(url=url, cookies=cookies, verify=False)

    token = re.findall(r'token=(\d+)', str(response.url))[0]

    time.sleep(2)

    # 搜索微信公众号的接口地址

    search_url = 'https://mp.weixin.qq.com/cgi-bin/searchbiz?'

    # 搜索微信公众号接口需要传入的参数,有三个变量:微信公众号token、随机数random、搜索的微信公众号名字

    query_id = {

        'action': 'search_biz',

        'token': token,

        'lang': 'zh_CN',

        'f': 'json',

        'ajax': '1',

        'random': random.random(),

        'query': query,

        'begin': '0',

        'count': '5'

    }

    # 打开搜索微信公众号接口地址,需要传入相关参数信息如:cookies、params、headers

    search_response = session.get(

        search_url,

        cookies=cookies,

        headers=header,

        params=query_id)

    # 取搜索结果中的第一个公众号

    lists = search_response.json().get('list')[0]

    print(lists)

    # 获取这个公众号的fakeid,后面爬取公众号文章需要此字段

    fakeid = lists.get('fakeid')

    # 微信公众号文章接口地址

    appmsg_url = 'https://mp.weixin.qq.com/cgi-bin/appmsg?'

    # 搜索文章需要传入几个参数:登录的公众号token、要爬取文章的公众号fakeid、随机数random

    query_id_data = {

        'token': token,

        'lang': 'zh_CN',

        'f': 'json',

        'ajax': '1',

        'random': random.random(),

        'action': 'list_ex',

        'begin': '0',  # 不同页,此参数变化,变化规则为每页加5

        'count': '5',

        'query': '',

        'fakeid': fakeid,

        'type': '9'

    }

    # 打开搜索的微信公众号文章列表页

    appmsg_response = session.get(

        appmsg_url,

        cookies=cookies,

        headers=header,

        params=query_id_data)

    # 获取文章总数

    max_num = appmsg_response.json().get('app_msg_cnt')

    # 每页至少有5条,获取文章总的页数,爬取时需要分页爬

    num = int(int(max_num) / 5)

    # 起始页begin参数,往后每页加5

    begin = 0

    seq = 0

    while num + 1 > 0:

        query_id_data = {

            'token': token,

            'lang': 'zh_CN',

            'f': 'json',

            'ajax': '1',

            'random': random.random(),

            'action': 'list_ex',

            'begin': '{}'.format(str(begin)),

            'count': '5',

            'query': '',

            'fakeid': fakeid,

            'type': '9'

        }

        print('正在翻页:--------------', begin)

        time.sleep(5)

        # 获取每一页文章的标题和链接地址,并写入本地文本中

        query_fakeid_response = requests.get(

            appmsg_url,

            cookies=cookies,

            headers=header,

            params=query_id_data)

        fakeid_list = query_fakeid_response.json().get('app_msg_list')

        if fakeid_list:

            for item in fakeid_list:

                content_link = item.get('link')

                content_title = item.get('title')

                fileName = query + '.txt'

                seq += 1

                with open(fileName, 'a', encoding='utf-8') as fh:

                    fh.write(

                        str(seq) +

                        "|" +

                        content_title +

                        "|" +

                        content_link +

                        "\n")

        num -= 1

        begin = int(begin)

        begin += 5

if __name__ == '__main__':

        # 登录微信公众号,获取登录之后的cookies信息,并保存到本地文本中

    wechat_login()

    query = "XXX"

    print("开始爬取公众号:" + query)

    get_content(query)

    print("爬取完成")

    # #登录之后,通过微信公众号后台提供的微信公众号文章接口爬取文章

    # for query in gzlist:

    #     #爬取微信公众号文章,并存在本地文本中

    #     print("开始爬取公众号:"+query)

    #     get_content(query)

    #     print("爬取完成")
python爬取微信公众号的更多相关文章
- 使用Python爬取微信公众号文章并保存为PDF文件(解决图片不显示的问题)
前言 第一次写博客,主要内容是爬取微信公众号的文章,将文章以PDF格式保存在本地. 爬取微信公众号文章(使用wechatsogou) 1.安装 pip install wechatsogou --up ...
- Python爬取微信公众号素材库
这是我的之前写的代码,今天发布到博客园上,说不定以后需要用. 开始: #coding:utf-8 import werobot import pymongo class Gongzhonghao( ...
- 使用BeautifulSoup自动爬取微信公众号图片
爬取微信分享的图片,根据不同的页面自行修改,使用BeautifulSoup爬取,自行格局HTML修改要爬取图片的位置 import re import time import requests imp ...
- Python爬取微信小程序(Charles)
Python爬取微信小程序(Charles) 本文链接:https://blog.csdn.net/HeyShHeyou/article/details/90045204 一.前言 最近需要获取微信小 ...
- python 爬取微信好友列表和个性签名,绘制个性签名云图
python爬取微信好友列表和个性签名,绘制个性签名云图 1. 简要介绍 本次实验主要用到下面几个库 : 1)itchat---用于微信接口,实现生成QR码,用于微信扫描登陆 2)re(正则化)--- ...
- python爬取微信小程序(实战篇)
python爬取微信小程序(实战篇) 本文链接:https://blog.csdn.net/HeyShHeyou/article/details/90452656 展开 一.背景介绍 近期有需求需要抓 ...
- python通过手机抓取微信公众号
使用 Fiddler 抓包分析公众号 打开微信随便选择一个公众号,查看公众号的所有历史文章列表 在 Fiddler 上已经能看到有请求进来了,说明公众号的文章走的都是HTTPS协议,这些请求就是微信客 ...
- Python爬取微信好友
前言 今天看到一篇好玩的文章,可以实现微信的内容爬取和聊天机器人的制作,所以尝试着实现一遍,本文记录了实现过程和一些探索的内容 来源: 痴海 链接: https://mp.weixin.qq.com/ ...
- Python+Tornado开发微信公众号
本文已同步到专业技术网站 www.sufaith.com, 该网站专注于前后端开发技术与经验分享, 包含Web开发.Nodejs.Python.Linux.IT资讯等板块. 本教程针对的是已掌握Pyt ...
随机推荐
- jquery删除onclick属性和设置onclick属性--获取验证码
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/ ...
- form表单序列化为json格式数据
在web开发过程中,经常遇到将form序列化不能格式的字符串提交到后台,下面就介绍怎样将form表单序列化为json字符串. 首先,是扩展的jquery序列化插件,依赖jquery.经测试,这段代码可 ...
- c 语言申明头文件和实现分开简单例子
很多时候,看到很多c函数的声明和实现是分开的.声明放在头文件,实现却放在另一个文件,最后函数被其他文件调用. 下面以简单例子说明. 一.声明部分 /* test.h */ #include <s ...
- (转).net面试题(老赵)
转自:http://www.cnblogs.com/chenxiaoran/archive/2012/05/27/2519988.html 1.什么是CLR 公共语言运行时(Comman langua ...
- Shell编程-10-Shell中的数组
目录 数组基础 数组示例 数组总结 如果大家有其他语言的基础或经验,就很快能明白数组了.简单来说,数组就某一种相同类型的元素组合,而后通过下标对其进行访问各元素. 数组基础 基础语法 第一种形 ...
- 20155326刘美岑2016-2017-2《Java程序设计》第三周学习总结
20155326刘美岑2016-2017-2<Java程序设计>第三周学习总结 教材学习内容总结 基本类型和类类型 基本类型:第三章中讲述的那几种,short.long.int.byte. ...
- 20155326刘美岑 2016-2017-2 《Java程序设计》第二周学习总结
20155326刘美岑 2016-2017-2 <Java程序设计>第二周学习总结 教材学习内容总结 教材第三章主要讲解的是基础语法,主要包括认识类型与变量.学习运算符的基本使用.了解类型 ...
- Hdu2255 奔小康赚大钱(二分图最大权匹配KM算法)
奔小康赚大钱 Problem Description 传说在遥远的地方有一个非常富裕的村落,有一天,村长决定进行制度改革:重新分配房子. 这可是一件大事,关系到人民的住房问题啊.村里共有n间房间,刚好 ...
- hdu 4902 线段树+逆向模拟
http://acm.hdu.edu.cn/showproblem.php?pid=4902 出n个数,然后对这n个数进行两种操作: 如果是 1 l r x,则把 [l, r] 区间里面的每一个数都变 ...
- python全栈学习1.开课介绍
python————web && 爬虫 Django pyramid Tornado Bottle Flask GUI图形开发 QT 想要类似于执行shell脚本一样执行python ...